
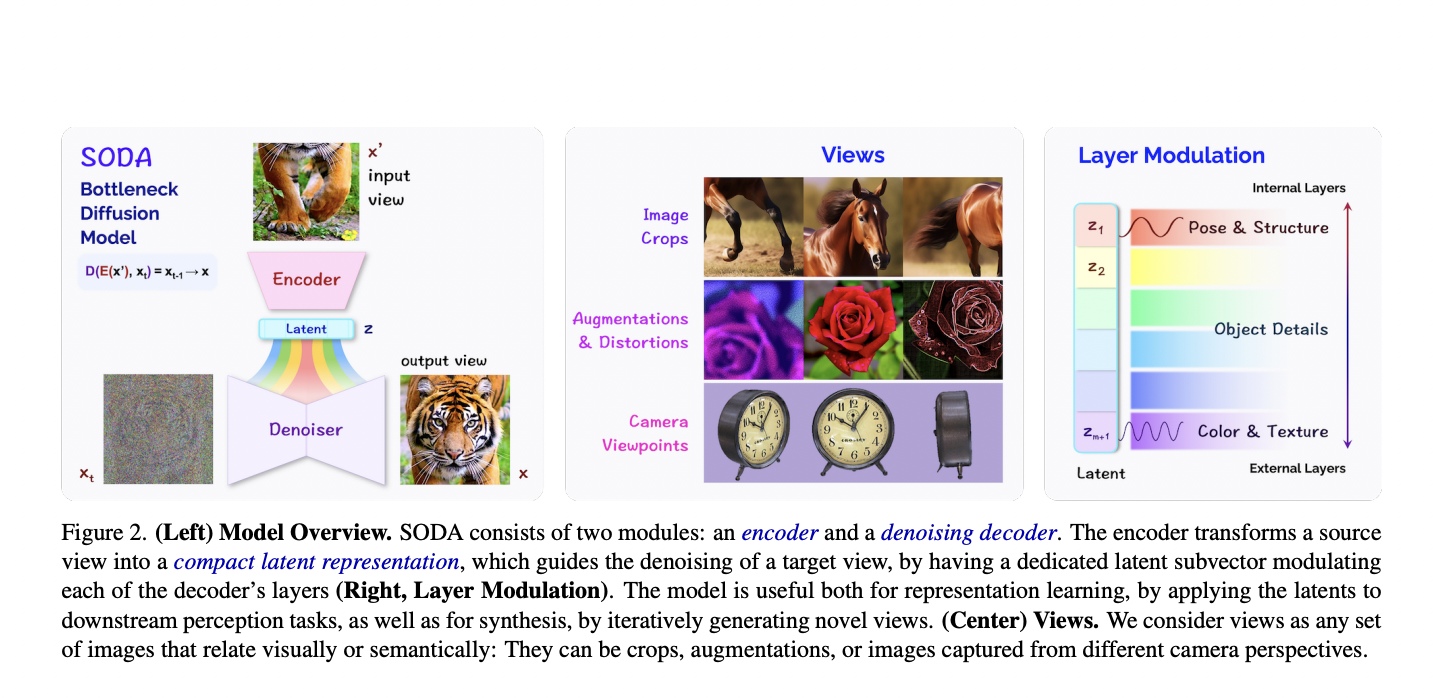
Los investigadores de Google DeepMind han desarrollado SODA, un modelo de inteligencia artificial que aborda el problema de codificar imágenes en representaciones latentes eficientes. Con SODA, se hacen posibles transiciones fluidas entre imágenes y atributos semánticos, lo que permite la interpolación y transformación entre varias categorías de imágenes.
Los modelos de difusión han revolucionado la síntesis visual, sobresaliendo en diversas tareas como síntesis, planificación y descubrimiento de fármacos de imágenes, vídeos, audio y texto. Si bien los estudios anteriores se centraron en sus capacidades generativas, este estudio explora el ámbito poco explorado de la capacidad de representación de los modelos de difusión. El estudio evalúa exhaustivamente el aprendizaje de representación basado en difusión en varios conjuntos de datos y tareas, arrojando luz sobre su potencial derivado únicamente de imágenes.
El modelo propuesto enfatiza la importancia de la síntesis en el aprendizaje y destaca la importante capacidad representacional de los modelos de difusión. SODA es un modelo autosupervisado que incorpora un cuello de botella de información para lograr representaciones informativas y desenredadas. SODA muestra sus fortalezas en tareas de clasificación, reconstrucción y síntesis, incluida la generación de vistas novedosas de alto rendimiento y pocas tomas y la controlabilidad de rasgos semánticos.
Un modelo SODA utiliza un cuello de botella de información para crear representaciones desenredadas mediante difusión autosupervisada. Este enfoque utiliza un entrenamiento previo basado en la distribución para mejorar el aprendizaje de la representación, lo que da como resultado un rendimiento sólido en tareas de clasificación y síntesis de vistas novedosas. Las capacidades de SODA se han probado mediante una evaluación exhaustiva de diversos conjuntos de datos, incluido un rendimiento sólido en ImageNet.
Se ha demostrado que SODA sobresale en el aprendizaje de representaciones con resultados impresionantes en clasificación, desenredo, reconstrucción y síntesis de vistas novedosas. Se ha descubierto que mejora significativamente las métricas de desenredo en comparación con los métodos variacionales. En la clasificación de sonda lineal ImageNet, SODA supera a otros modelos discriminativos y demuestra solidez frente a los aumentos de datos. Su versatilidad es evidente a la hora de generar vistas novedosas y transiciones fluidas de atributos. A través de estudios empíricos, SODA se ha establecido como un enfoque eficaz, sólido y versátil para el aprendizaje de representación, respaldado por análisis detallados, métricas de evaluación y comparaciones con otros modelos.
En conclusión, SODA demuestra una notable competencia en el aprendizaje de representaciones, produciendo representaciones semánticas sólidas para diversas tareas, incluidas clasificación, reconstrucción, edición y síntesis. Emplea un cuello de botella de información para centrarse en las cualidades esenciales de la imagen y supera a los métodos variacionales en métricas de desenredo. La versatilidad de SODA es evidente en su capacidad para generar vistas novedosas, realizar cambios en atributos semánticos y manejar información condicional más rica, como la perspectiva de la cámara.
Como trabajo futuro, sería valioso profundizar en el campo de SODA explorando escenas de composición dinámica de conjuntos de datos 3D y reduciendo la brecha entre la síntesis de vistas novedosas y el aprendizaje autosupervisado. Se necesita más investigación sobre la estructura del modelo, su implementación y los detalles de evaluación, como los preliminares de los modelos de difusión, los hiperparámetros, las técnicas de entrenamiento y los métodos de muestreo. Se recomienda realizar estudios de ablación y variación para comprender mejor las opciones de diseño y explorar mecanismos alternativos, atención cruzada y modulación por capas. Hacerlo puede mejorar el rendimiento en diversas tareas, como la síntesis de vistas novedosas en 3D, la edición de imágenes, la reconstrucción y el aprendizaje de representaciones.
Revisar la Papel y Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 33k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Hola, mi nombre es Adnan Hassan. Soy pasante de consultoría en Marktechpost y pronto seré aprendiz de gestión en American Express. Actualmente estoy cursando una doble titulación en el Instituto Indio de Tecnología, Kharagpur. Me apasiona la tecnología y quiero crear nuevos productos que marquen la diferencia.