
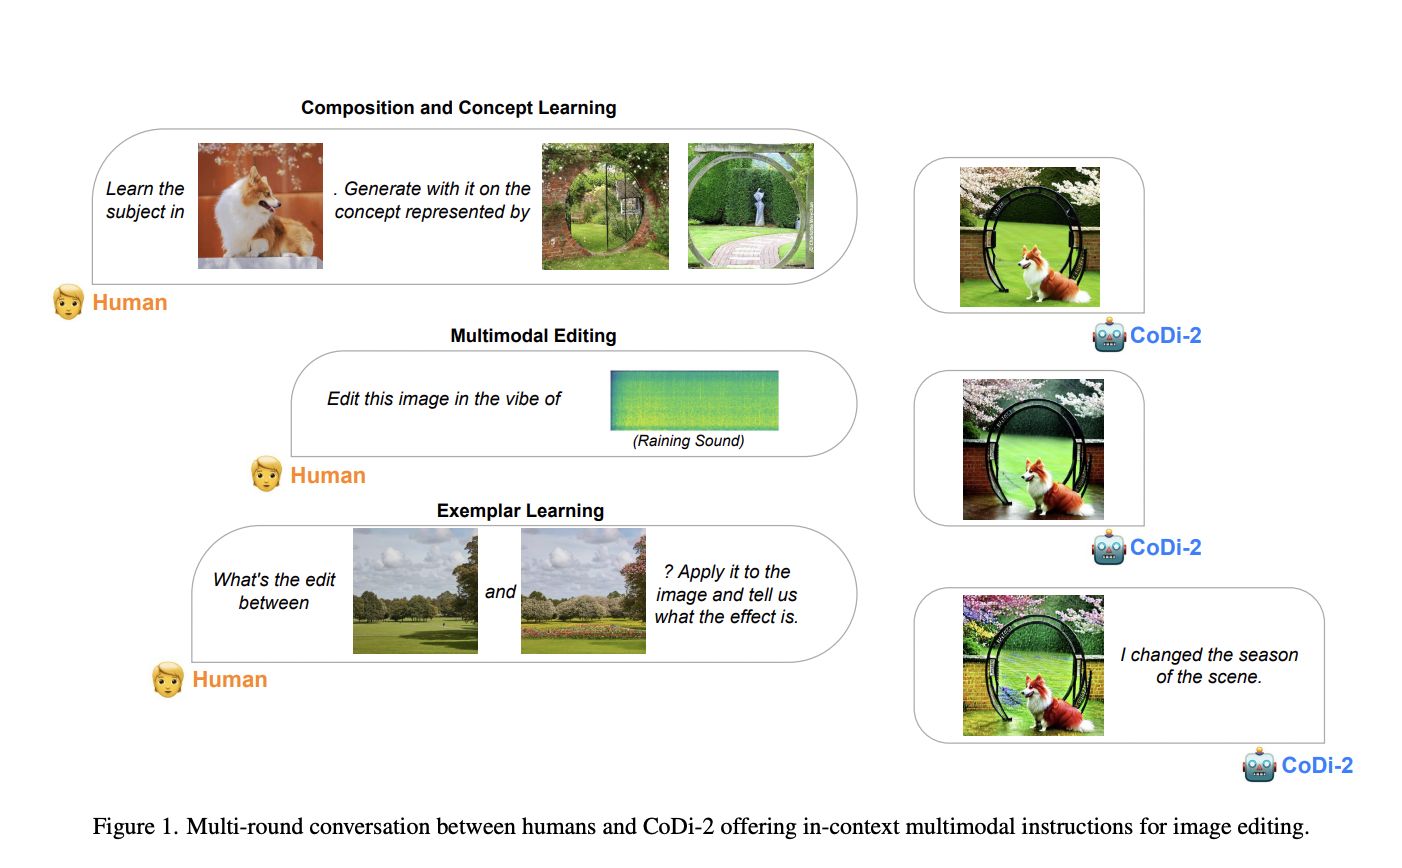
Los investigadores desarrollaron el modelo de lenguaje grande multimodal (MLLM) CoDi-2 de UC Berkeley, Microsoft Azure AI, Zoom y UNC-Chapel Hill para abordar el problema de generar y comprender instrucciones multimodales complejas, así como sobresalir en la generación de imágenes basadas en sujetos. , transformación de visión y tareas de edición de audio. Este modelo representa un avance significativo en el establecimiento de una base multimodal integral.
CoDi-2 amplía las capacidades de su predecesor, CoDi, al sobresalir en tareas como la generación de imágenes basadas en sujetos y la edición de audio. La arquitectura del modelo incluye codificadores y decodificadores para entradas de audio y visión. El entrenamiento incorpora la pérdida de píxeles de los modelos de difusión junto con la pérdida de tokens. CoDi-2 muestra notables habilidades de disparo cero y de pocos disparos en tareas como la adaptación de estilo y la generación basada en sujetos.
CoDi-2 aborda los desafíos en la generación multimodal, enfatizando el control detallado de disparo cero, el seguimiento de instrucciones intercaladas por modalidades y el chat multimodal de múltiples rondas. Utilizando un LLM como cerebro, CoDi-2 alinea las modalidades con el lenguaje durante la codificación y generación. Este enfoque permite que el modelo comprenda instrucciones complejas y produzca resultados multimodales coherentes.
La arquitectura CoDi-2 incorpora codificadores y decodificadores para entradas de audio y visión dentro de un modelo de lenguaje grande multimodal. CoDi-2, entrenado con un conjunto de datos de diversas generaciones, utiliza la pérdida de píxeles de los modelos de difusión junto con la pérdida de tokens durante la fase de entrenamiento. Al demostrar capacidades superiores de disparo cero, supera a los modelos anteriores en generación de imágenes basadas en sujetos, transformación de visión y edición de audio, mostrando un rendimiento competitivo y generalización en nuevas tareas invisibles.
CoDi-2 exhibe amplias capacidades de disparo cero en una generación multimodal, sobresaliendo en aprendizaje en contexto, razonamiento y generación de modalidad de cualquiera a cualquier a través de una conversación interactiva de múltiples rondas. Los resultados de la evaluación demuestran un rendimiento cero altamente competitivo y una sólida generalización a tareas nuevas e invisibles. CoDi-2 supera las tareas de manipulación de audio, logrando un rendimiento superior al agregar, eliminar y reemplazar elementos dentro de las pistas de audio, como lo indican las puntuaciones más bajas en todas las métricas. Destaca la importancia de la edad en contexto, el aprendizaje de conceptos, la edición y el control detallado en el avance de la generación multimodal de alta fidelidad.
En conclusión, CoDi-2 es un sistema de inteligencia artificial avanzado que destaca en diversas tareas, incluido seguir instrucciones complejas, aprender en contexto, razonar, chatear y editar en diferentes modos de entrada y salida. Su capacidad para adaptarse a diferentes estilos y generar contenido basado en diversos temas y su habilidad en la manipulación de audio lo convierten en un gran avance en el modelado básico multimodal. CoDi-2 representa una exploración impresionante en la creación de un sistema integral que pueda manejar muchas tareas, incluso aquellas para las que aún no ha sido entrenado.
Las direcciones futuras para CoDi-2 planean mejorar sus capacidades de generación multimodal refinando el aprendizaje en contexto, ampliando las habilidades conversacionales y respaldando modalidades adicionales. Su objetivo es mejorar la fidelidad de la imagen y el audio mediante el uso de técnicas como los modelos de difusión. Las investigaciones futuras también pueden implicar evaluar y comparar CoDi-2 con otros modelos para comprender sus fortalezas y limitaciones.
Revisar la Papel, GitHuby Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 33k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Hola, mi nombre es Adnan Hassan. Soy pasante de consultoría en Marktechpost y pronto seré aprendiz de gestión en American Express. Actualmente estoy cursando una doble titulación en el Instituto Indio de Tecnología, Kharagpur. Me apasiona la tecnología y quiero crear nuevos productos que marquen la diferencia.