
Los avances en Inteligencia Artificial (IA) y Aprendizaje Profundo han traído una gran transformación en la forma en que los humanos interactúan con las computadoras. Con la introducción de los modelos de difusión, el modelado generativo ha demostrado capacidades notables en diversas aplicaciones, incluida la generación de texto, generación de imágenes, síntesis de audio y producción de video.
Aunque los modelos de difusión han mostrado un rendimiento superior, estos modelos frecuentemente tienen altos costos computacionales, que están relacionados principalmente con el tamaño engorroso del modelo y el procedimiento de eliminación de ruido secuencial. Estos modelos tienen una velocidad de inferencia muy lenta, para solucionar lo cual los investigadores han realizado una serie de esfuerzos, incluida la reducción del número de pasos de muestra y la reducción de la sobrecarga de inferencia del modelo por paso utilizando técnicas como poda, destilación y cuantificación de modelos.
Los métodos convencionales para comprimir modelos de difusión suelen necesitar una gran cantidad de reentrenamiento, lo que plantea dificultades prácticas y financieras. Para superar estos problemas, un equipo de investigadores ha introducido DeepCache, un paradigma nuevo y único sin formación que optimiza la arquitectura de los modelos de difusión para acelerar la difusión.
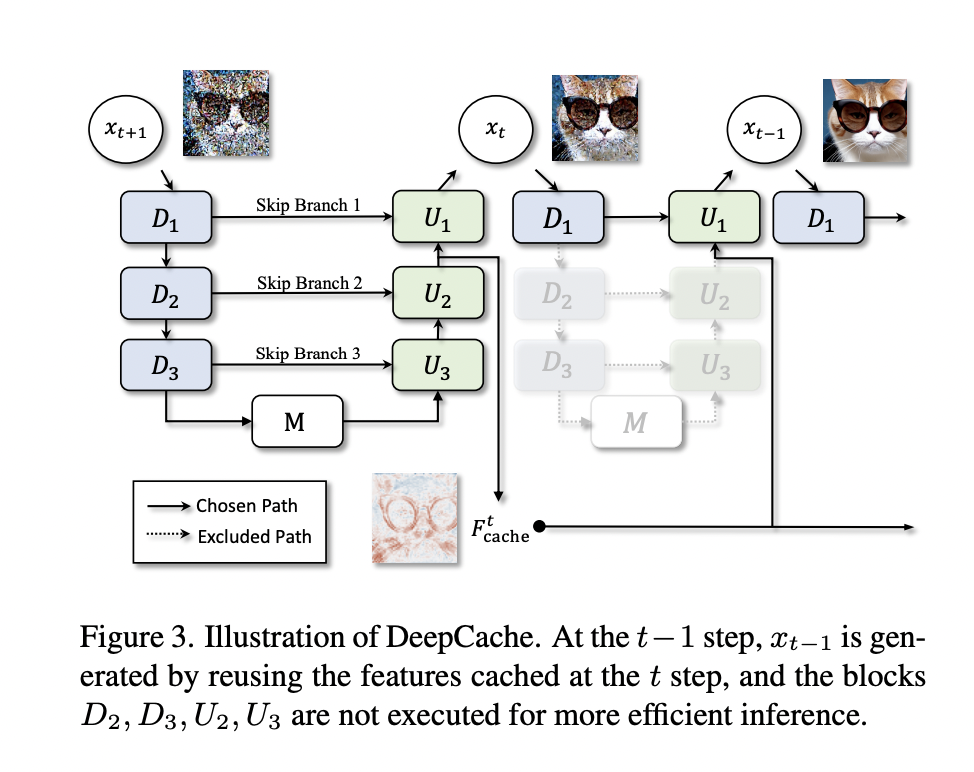
DeepCache aprovecha la redundancia temporal que es intrínseca a las sucesivas etapas de eliminación de ruido de los modelos de difusión. La razón de esta redundancia es que algunas funciones se repiten en pasos sucesivos de eliminación de ruido. Reduce sustancialmente los cálculos duplicados al introducir un método de almacenamiento en caché y recuperación para estas propiedades. El equipo ha compartido que este enfoque se basa en la propiedad U-Net, que permite reutilizar funciones de alto nivel y al mismo tiempo actualizar de forma eficaz y económica las funciones de bajo nivel.
El enfoque creativo de DeepCache produce un factor de aceleración significativo de 2,3× para Stable Diffusion v1.5 con solo una ligera caída de puntuación CLIP de 0,05. También ha demostrado una impresionante aceleración de 4,1× para LDM-4-G, aunque con una pérdida de 0,22 en FID en ImageNet.
El equipo ha evaluado DeepCache y las comparaciones experimentales han demostrado que DeepCache funciona mejor que las técnicas actuales de poda y destilación, que normalmente requieren un reentrenamiento. Incluso se ha demostrado que es compatible con los métodos de muestreo existentes. Ha mostrado un rendimiento similar, o ligeramente mejor, con DDIM o PLMS con el mismo rendimiento y, por lo tanto, maximiza la eficiencia sin sacrificar el calibre de los resultados producidos.
Los investigadores han resumido las principales contribuciones de la siguiente manera.
- DeepCache funciona bien con los muestreadores rápidos actuales, lo que demuestra la posibilidad de lograr capacidades de generación similares o incluso mejores.
- Mejora la velocidad de generación de imágenes sin necesidad de entrenamiento adicional al comprimir dinámicamente los modelos de difusión durante el tiempo de ejecución.
- Al utilizar funciones almacenables en caché, DeepCache reduce los cálculos duplicados mediante el uso de coherencia temporal en funciones de alto nivel.
- DeepCache mejora la flexibilidad del almacenamiento en caché de funciones al introducir una técnica personalizada para intervalos de almacenamiento en caché extendidos.
- DeepCache muestra una mayor eficacia en los modelos DDPM, LDM y Stable Diffusion cuando se prueba en CIFAR, LSUN-Bedroom/Churches, ImageNet, COCO2017 y PartiPrompt.
- DeepCache funciona mejor que los algoritmos de poda y destilación que requieren reentrenamiento, manteniendo su mayor eficacia bajo las condiciones
En conclusión, DeepCache definitivamente es muy prometedor como acelerador de modelos de difusión, ya que proporciona un sustituto útil y asequible de las técnicas de compresión convencionales.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 33k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Tanya Malhotra es estudiante de último año de la Universidad de Estudios de Petróleo y Energía, Dehradun, y cursa BTech en Ingeniería en Ciencias de la Computación con especialización en Inteligencia Artificial y Aprendizaje Automático.
Es una entusiasta de la Ciencia de Datos con buen pensamiento analítico y crítico, junto con un ardiente interés en adquirir nuevas habilidades, liderar grupos y gestionar el trabajo de manera organizada.