
CLIP, que significa Contrastive Language-Image Pretraining, es un modelo de aprendizaje profundo desarrollado por OpenAI en 2021. Las incrustaciones de CLIP para imágenes y texto comparten el mismo espacio, lo que permite comparaciones directas entre las dos modalidades. Esto se logra entrenando el modelo para acercar imágenes y textos relacionados mientras separa los no relacionados.
Algunas aplicaciones de CLIP incluyen:
- Clasificación y recuperación de imágenes: CLIP se puede utilizar para tareas de clasificación de imágenes asociando imágenes con descripciones en lenguaje natural. Permite sistemas de recuperación de imágenes más versátiles y flexibles donde los usuarios pueden buscar imágenes mediante consultas textuales.
- Moderación de contenido: CLIP se puede utilizar para moderar contenido en plataformas en línea mediante el análisis de imágenes y el texto que las acompaña para identificar y filtrar contenido inapropiado o dañino.
El modelo CLIP original tenía como objetivo unir modalidades de imagen y texto dentro de un espacio de incrustación compartido. Este concepto, junto con sus técnicas, se extiende más allá de las imágenes y el texto para abarcar otras modalidades. netflix, en esta publicación de blogentrenó un modelo combinando modalidades de video y texto en el espacio de incrustación común para mejorar la búsqueda dentro de las aplicaciones de video. Preentrenamiento de lenguaje contrastivo y audio (CLAP) es otro modelo que integra modalidades de texto y audio dentro del mismo espacio de incrustación, lo que lo hace valioso para mejorar las funcionalidades de búsqueda dentro de las aplicaciones de audio.
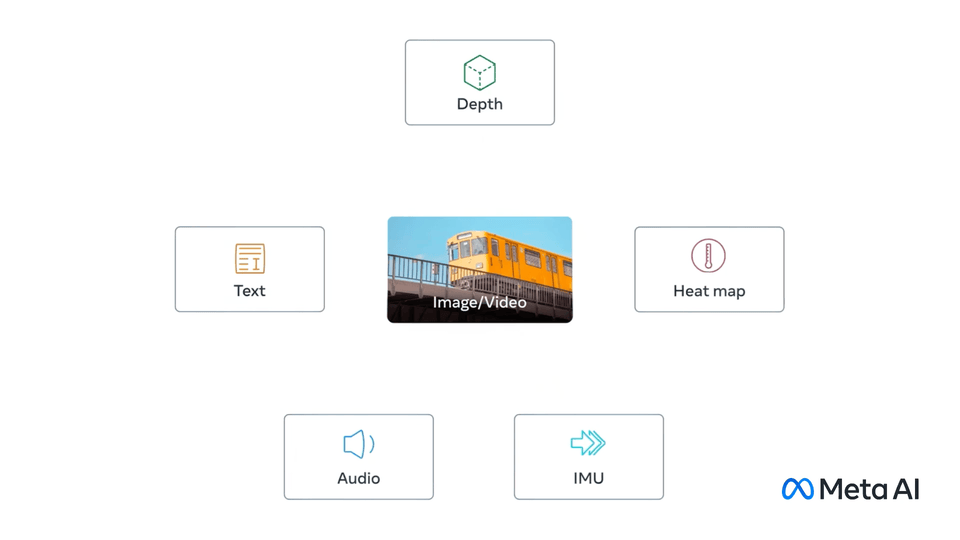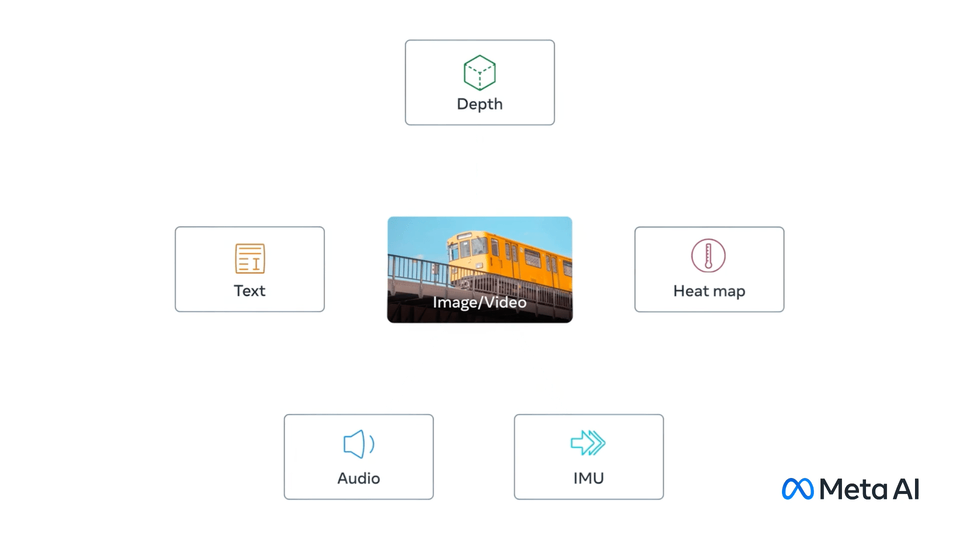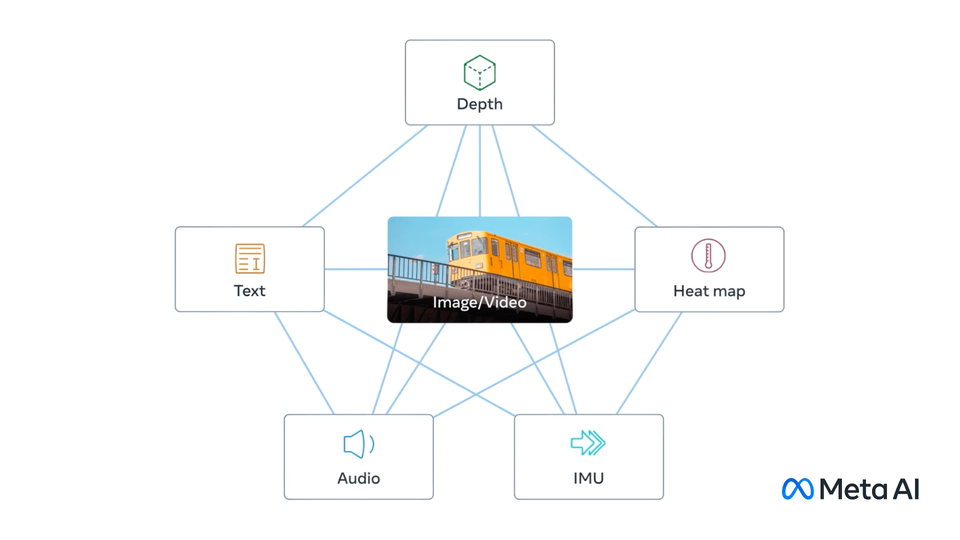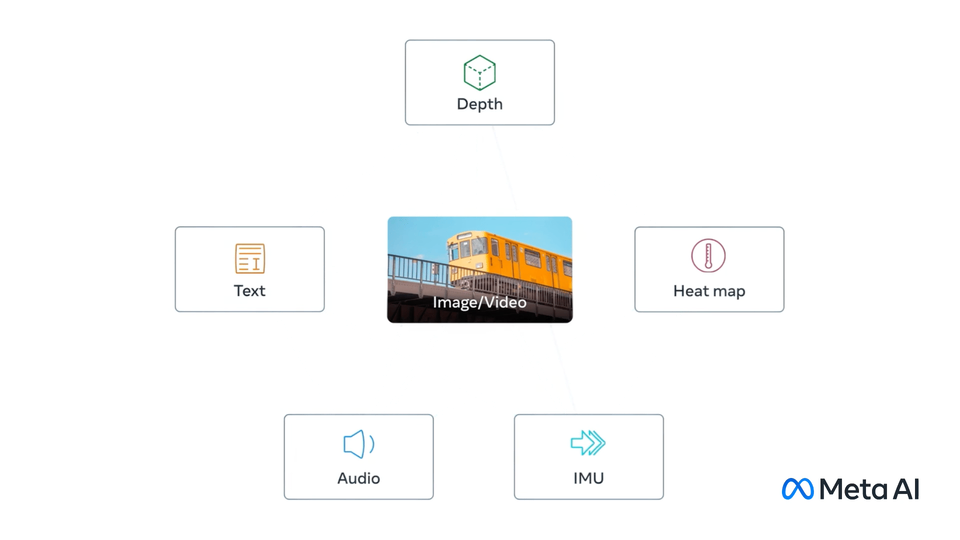
La tecnología subyacente de CLIP es extremadamente simple pero muy poderosa, y abre la puerta a muchas técnicas de aprendizaje automático multimodelo. Meta AI lanzada recientemente Enlace de imagen, que aprende una incrustación conjunta en seis modalidades: imágenes, texto, audio, profundidad, térmica y datos IMU. CLIP, el primer modelo de IA a gran escala que acepta dos modalidades, es un requisito previo para comprender ImageBind y otros sistemas de IA multimodales.
¿Qué es CLIP?
CLIP está diseñado para predecir qué N × N pares potenciales (imagen, texto) dentro del lote son coincidencias reales. Para lograr esto, CLIP establece un espacio de incrustación multimodal mediante el entrenamiento conjunto de un codificador de imágenes y un codificador de texto. La pérdida CLIP tiene como objetivo maximizar la similitud del coseno entre la imagen y las incrustaciones de texto para los N pares genuinos en el lote y al mismo tiempo minimizar la similitud del coseno para los N² – N pares incorrectos. El proceso de optimización implica el uso de una función de pérdida de entropía cruzada simétrica que opera con estas puntuaciones de similitud. A continuación se presenta un pseudocódigo (tomado del artículo original) que describe la implementación principal de CLIP.
# image_encoder - ResNet or Vision Transformer
# text_encoder - CBOW or Text Transformer
# I[n, h, w, c] - minibatch of aligned images
# T[n, l] - minibatch of aligned texts
# W_i[d_i, d_e] - learned proj of image to embed
# W_t[d_t, d_e] - learned proj of text to embed
# t - learned temperature parameter
# extract feature representations of each modality
I_f = image_encoder(I) #[n, d_i]
T_f = text_encoder(T) #[n, d_t]
# joint multimodal embedding [n, d_e]
I_e = l2_normalize(np.dot(I_f, W_i), axis=1)
T_e = l2_normalize(np.dot(T_f, W_t), axis=1)
# scaled pairwise cosine similarities [n, n]
logits = np.dot(I_e, T_e.T) * np.exp