
En una era en la que prolifera la información digital, la capacidad de la inteligencia artificial (IA) para digerir y comprender textos extensos es más crítica que nunca. A pesar de su destreza lingüística, los modelos de lenguajes grandes (LLM) tradicionales fallan cuando se enfrentan a documentos largos, principalmente debido a limitaciones inherentes al procesamiento de entradas extensas. Esta limitación obstaculiza su utilidad en escenarios donde la comprensión de textos extensos es esencial, lo que subraya una necesidad apremiante de soluciones innovadoras que reflejen la flexibilidad cognitiva humana al tratar con información extensa.
La búsqueda de trascender estos límites llevó a los investigadores de Google DeepMind y Google Research a ser pioneros en ReadAgent. Este innovador sistema se inspira en estrategias de lectura humana para mejorar significativamente las capacidades de comprensión de textos de la IA. A diferencia de los enfoques convencionales que amplían la ventana de contexto que los LLM pueden percibir o dependen de sistemas externos de recuperación de datos para solucionar las deficiencias en la comprensión, ReadAgent introduce un método más matizado y similar al humano para navegar de manera eficiente a través de documentos extensos.
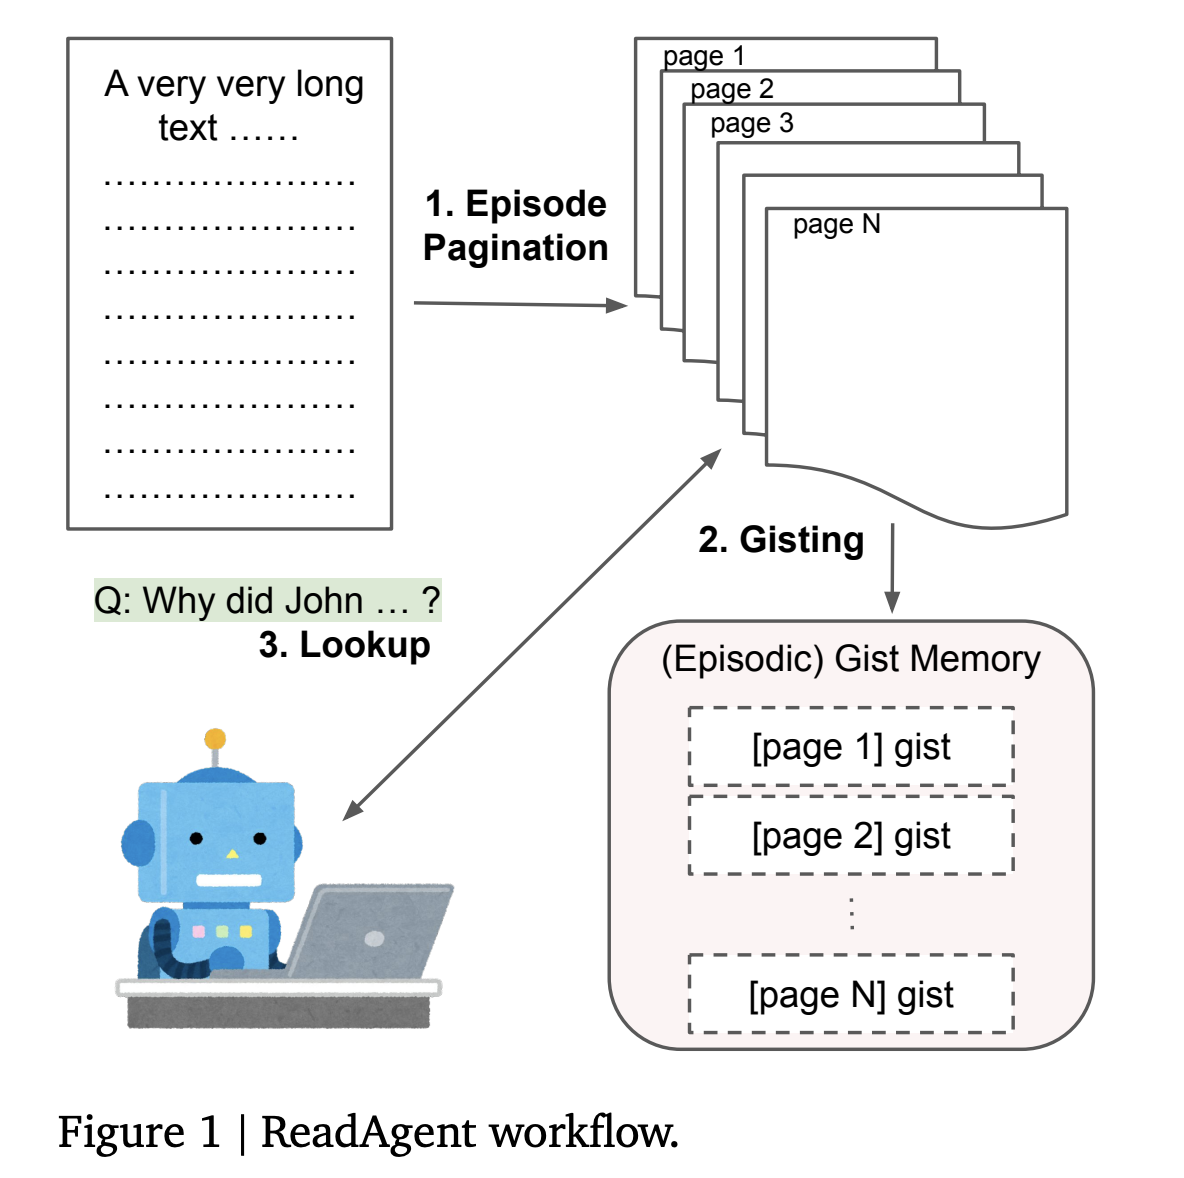
En el corazón del diseño de ReadAgent se encuentra una emulación inteligente de los comportamientos de lectura humanos, específicamente la práctica de resumir y recordar. Este método implica un proceso de tres pasos:
- Segmentar el texto en partes manejables
- Condensar estos segmentos en resúmenes concisos y esenciales
- Recordar dinámicamente información detallada de estos resúmenes según sea necesario
Este enfoque innovador permite a la IA captar la narrativa o el argumento general de un documento, a pesar de su extensión, centrándose en la información central y revisando estratégicamente los detalles cuando sea necesario.
La metodología detrás de ReadAgent es simple e ingeniosa. Inicialmente, el sistema segmenta un texto largo en episodios basándose en puntos de pausa naturales, similares a capítulos o secciones de la lectura humana. Luego, estos segmentos se comprimen en “memorias esenciales”, que capturan la esencia del texto en una fracción del tamaño original. Cuando se requiere información específica para abordar una consulta o tarea, ReadAgent revisa los segmentos detallados relevantes, aprovechando estos recuerdos esenciales como una hoja de ruta hacia el texto original. Este proceso no solo imita las estrategias humanas para manejar textos largos, sino que también amplía significativamente la longitud efectiva del contexto que los LLM pueden manejar, superando efectivamente una de las principales limitaciones de los modelos actuales de IA.
La eficacia de ReadAgent queda subrayada por su desempeño en varias tareas de comprensión de documentos extensos. En experimentos, ReadAgent demostró una mejora sustancial con respecto a los métodos existentes, ampliando la longitud efectiva del contexto hasta 20 veces. Específicamente, en el conjunto de pruebas NarrativeQA Gutenberg, ReadAgent mejoró la calificación LLM en un 12,97 % y ROUGE-L en un 31,98 % con respecto a la mejor base de recuperación, lo que demuestra su capacidad superior para comprender y procesar documentos extensos. Este notable desempeño resalta no solo el potencial de la IA para asimilar estrategias de lectura y comprensión similares a las humanas, sino también la aplicabilidad práctica de tales enfoques para mejorar la comprensión de textos complejos por parte de la IA.
Desarrollado por las mentes innovadoras de Google DeepMind y Google Research, ReadAgent representa un importante avance en las capacidades de comprensión de texto de la IA. La incorporación de estrategias de lectura humana amplía la aplicabilidad de la IA en dominios que requieren una comprensión profunda del texto y allana el camino para sistemas de IA más sofisticados y de tipo cognitivo. Este avance muestra el potencial del desarrollo de la IA inspirada en el ser humano y establece un nuevo punto de referencia para el papel de la IA en la navegación en el panorama de la información digital en constante expansión.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 37k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

Muhammad Athar Ganaie, pasante de consultoría en MarktechPost, es un defensor del aprendizaje profundo eficiente, con especial atención en la capacitación dispersa. Cursando un M.Sc. en Ingeniería Eléctrica, con especialización en Ingeniería de Software, combina conocimientos técnicos avanzados con aplicaciones prácticas. Su esfuerzo actual es su tesis sobre “Mejora de la eficiencia en el aprendizaje por refuerzo profundo”, que muestra su compromiso de mejorar las capacidades de la IA. El trabajo de Athar se encuentra en la intersección “Capacitación escasa en DNN” y “Aprendizaje por refuerzo profundo”.