
En los modelos de lenguajes grandes (LLM), el panorama de los datos de preentrenamiento es una rica combinación de diversas fuentes. Abarca desde el inglés común hasta idiomas menos comunes, incluidas conversaciones informales y textos académicos, e incluso se extiende a modalidades como imágenes y discursos. Dentro de esta combinación, los datos interactúan de maneras complejas, a veces alineándose bien, divergiendo y ocasionalmente entrando en conflicto. El desafío radica en ajustar las proporciones de esta combinación, aprovechando las fortalezas de cada dominio y al mismo tiempo minimizando los conflictos potenciales a través de los cuales los modelos resultantes obtienen capacidades mejoradas, un testimonio de los valiosos conocimientos obtenidos del uso extensivo en el mundo real.
A pesar de ser difíciles de alcanzar a la hora de encontrar una combinación ideal de datos de entrenamiento, la mayoría de las prácticas existentes ajustan la combinación mediante heurísticas para muestrear una proporción de datos de alta calidad o subrepresentados sin revelar los criterios concretos en detalle. Es difícil predecir si estas estrategias de datos son efectivas antes de finalizar la ejecución de entrenamiento. Inspirado por los avances en las leyes de escala que muestran que las pérdidas del modelo en un conjunto determinado de datos de evaluación son cuantitativamente predecibles para una amplia gama de variables, existe una perspectiva interesante. Si este principio también se aplica a las proporciones de la mezcla, podrían estimar el rendimiento del modelo resultante incluso antes de comenzar el entrenamiento.
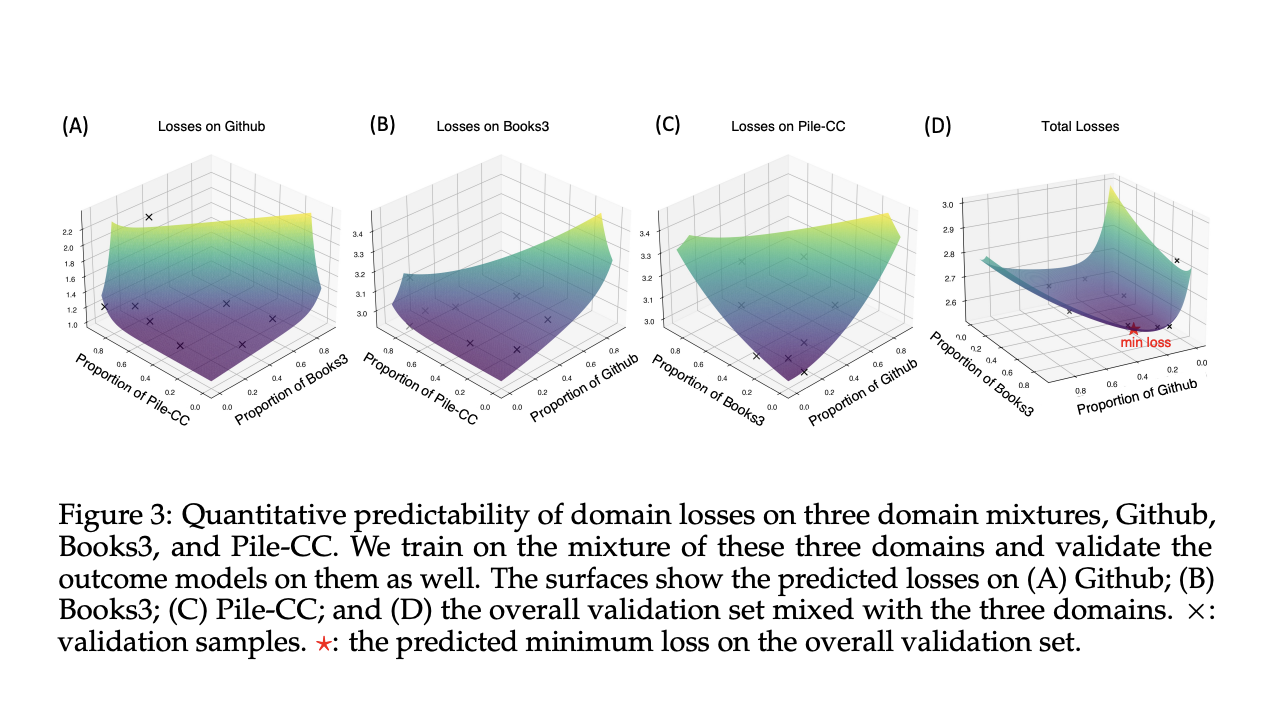
Investigadores de la Universidad de Fudan y el Laboratorio de IA de Shanghai introdujeron una ley de combinación de datos y un canal de predicción, que resuelve el problema de predecir con precisión la pérdida de validación para una combinación de dominios de entrenamiento bajo un tamaño de modelo fijo y una cantidad de datos de entrenamiento. Los investigadores llevaron a cabo un estudio piloto sobre pérdidas de dominio en mezclas de dos dominios para predecir las pérdidas del modelo con respecto a las mezclas de datos. Esto se logra entrenando modelos de lenguaje de 70M y 160M en la combinación de subconjuntos de Github y Pile-CC del conjunto de datos de Pile con cinco proporciones de mezcla diferentes para Github. Todos los modelos se entrenan con un tamaño de lote de 1 millón de tokens para 30 mil pasos, que son 30 mil millones de tokens.
Este documento aborda varios desafíos en la optimización de las combinaciones de datos. Algunos de ellos son (a) Descubrimiento de la previsibilidad cuantitativa del desempeño del modelo con respecto a la mezcla de datos, resumiendo esto en una relación funcional, es decir, las leyes de mezcla de datos. (b) Propuso un proceso para predecir el rendimiento del modelo de entrenamiento a gran escala en diferentes proporciones de mezcla, pero solo experimentos en modelos pequeños con pocos datos de entrenamiento a través de leyes de escalado anidadas de pasos de entrenamiento, tamaños de modelos y leyes de mezcla de datos. (c) Verificación experimental de la confiabilidad de las leyes de combinación de datos y el proceso de predicción, que muestra su eficacia para optimizar el rendimiento del modelo, equilibrar las capacidades del modelo y las perspectivas de guiar el diseño del programa de datos.
Desarrollar un canal para la predicción de pérdidas implicó entrenar los modelos en la mezcla de RedPajama y validarlos con el conjunto de validación de Pile. Se entrenó una serie de modelos 70M, 160M, 305M y 410M para tokens 30B para cumplir con las leyes de escala de los pasos de entrenamiento y los tamaños de los modelos. Sorprendentemente, el modelo entrenado con la mezcla optimizada logra un rendimiento comparable al de uno entrenado con la mezcla predeterminada, pero con solo el 73% de los pasos. Con el tiempo, supera el rendimiento de la mezcla predeterminada y requiere un 48 % más de pasos, lo que subraya la eficacia del canal en la optimización de la mezcla.
En conclusión, este artículo presenta la ley de combinación de datos y el proceso de predicción, que resuelve el problema de predecir con precisión la pérdida de validación para una combinación de dominios de entrenamiento bajo un tamaño de modelo fijo y una cantidad de datos de entrenamiento. El uso anidado de leyes de escala de pasos de entrenamiento, tamaños de modelos y combinación de datos realiza predicciones solo con experimentos a pequeña escala, lo que permite la reutilización de experimentos existentes y reduce los costos de cálculo. Este estudio facilitará aún más los estudios cuantitativos y el análisis teórico con un enfoque cada vez mayor en la ingeniería de datos.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML

Sajjad Ansari es un estudiante de último año de IIT Kharagpur. Como entusiasta de la tecnología, profundiza en las aplicaciones prácticas de la IA centrándose en comprender el impacto de las tecnologías de IA y sus implicaciones en el mundo real. Su objetivo es articular conceptos complejos de IA de una manera clara y accesible.