
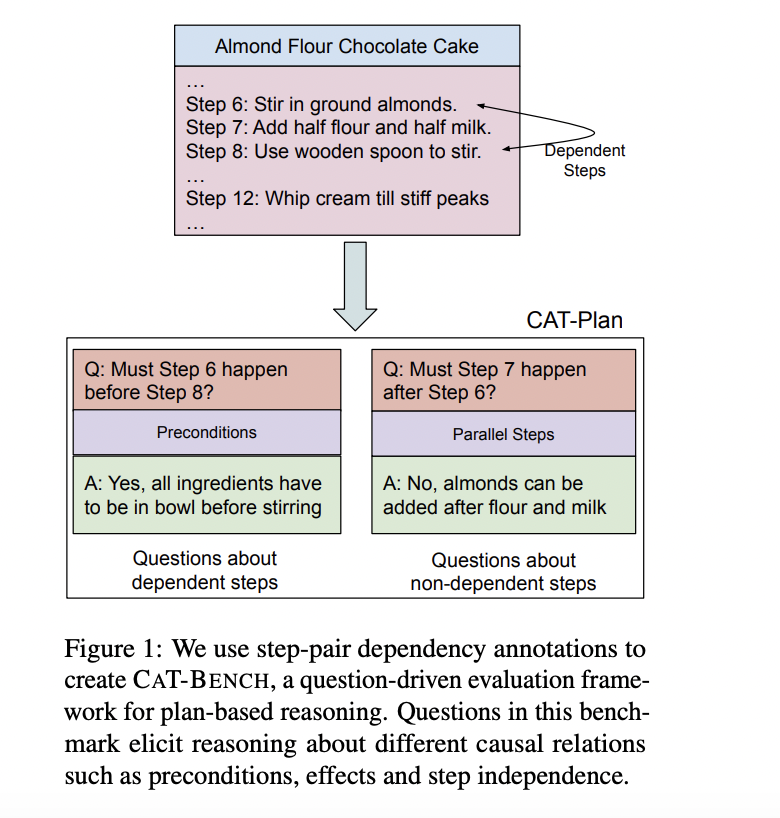
Comprender cómo los LLM comprenden los planes de lenguaje natural, como instrucciones y recetas, es crucial para su uso confiable en sistemas de toma de decisiones. Un aspecto crítico de los planes es su secuencia temporal, que refleja las relaciones causales entre los pasos. La planificación, parte integral de los procesos de toma de decisiones, se ha estudiado ampliamente en dominios como la robótica y los entornos corporales. La utilización, revisión o personalización efectiva de los planes requiere la capacidad de razonar sobre los pasos involucrados y sus conexiones causales. Si bien la evaluación en dominios como Blocksworld y entornos simulados es común, los planes de lenguaje natural del mundo real plantean desafíos únicos debido a su incapacidad de ejecutarse físicamente para probar su corrección y confiabilidad.
Investigadores de la Universidad Stony Brook, la Academia Naval de EE. UU. y la Universidad de Texas en Austin han desarrollado CAT-BENCH, un punto de referencia para evaluar la capacidad de modelos de lenguaje avanzados para predecir la secuencia de pasos en recetas de cocina. Su estudio revela que los modelos de lenguaje más avanzados actuales necesitan ayuda con esta tarea, incluso con técnicas como el aprendizaje de pocas tomas y las indicaciones basadas en explicaciones, logrando puntuaciones bajas en F1. Si bien estos modelos pueden generar planes coherentes, la investigación enfatiza desafíos importantes en la comprensión de las relaciones causales y temporales dentro de los textos instructivos. Las evaluaciones indican que incitar a los modelos a explicar sus predicciones después de generarlas mejora el rendimiento en comparación con las incitaciones tradicionales en cadena de pensamiento, lo que resalta las inconsistencias en el razonamiento del modelo.
Las primeras investigaciones hicieron hincapié en la comprensión de los planes y las metas. La generación de planes implica razonamiento temporal y seguimiento de estados de entidad. NaturalPlan se centra en algunas tareas del mundo real que implican la interacción con el lenguaje natural. PlanBench demostró los desafíos en el desarrollo de planes efectivos bajo una sintaxis estricta: modelos de tareas de construcción de guiones orientados a objetivos para producir secuencias de pasos para objetivos específicos. ChattyChef utiliza configuraciones conversacionales para refinar el orden de los pasos. CoPlan revisa los pasos para cumplir con las restricciones. Estudios como los estados de entidad, la vinculación de acciones y la predicción del próximo evento exploran la comprensión del plan. Varios conjuntos de datos abordan las dependencias en las instrucciones y la ramificación de decisiones. Sin embargo, es necesario que más conjuntos de datos se centren en predecir y explicar las restricciones del orden temporal en los planes de instrucción.
CAT-BENCH evalúa la capacidad de los modelos para reconocer dependencias temporales entre pasos en recetas de cocina. Basado en las relaciones causales dentro del gráfico acíclico dirigido (DAG) de la receta, plantea preguntas sobre si un paso debe ocurrir antes o después de otro. Por ejemplo, determinar si colocar la masa en una bandeja para hornear debe preceder a retirar un pastel horneado para enfriarlo depende de comprender las condiciones previas y los efectos de los pasos. CAT-BENCH contiene 2.840 preguntas en 57 recetas, divididas equitativamente entre preguntas que prueban las relaciones temporales “antes” y “después”. Los modelos se evalúan según su precisión, recuperación y puntuación F1 para predecir estas dependencias, junto con su capacidad para proporcionar explicaciones válidas para sus juicios.
Se evaluaron varios modelos en CAT-BENCH para determinar su desempeño en la predicción de dependencias de pasos. En la configuración de disparo cero, GPT-4-turbo y GPT-3.5-turbo mostraron los puntajes F1 más altos, y GPT-4o tuvo un desempeño inesperadamente peor. Agregar explicaciones junto con las respuestas generalmente mejoró el desempeño del modelo, mejorando notablemente el puntaje F1 de GPT-4o de manera significativa. Sin embargo, los modelos estaban sesgados hacia la predicción de dependencia, lo que impactó su precisión general y el equilibrio de recuperación. La evaluación humana de las explicaciones generadas por el modelo indicó una calidad variada, y los modelos más grandes generalmente superaron a los más pequeños. Los modelos necesitaban consistencia para predecir el orden de los pasos, particularmente cuando se agregaron explicaciones. Un análisis más detallado reveló errores comunes como la falta de comprensión de las dependencias de múltiples saltos y la imposibilidad de identificar relaciones causales entre los pasos.
CAT-BENCH introduce un nuevo punto de referencia para evaluar las capacidades de razonamiento causal y temporal de los modelos lingüísticos en la comprensión de textos procedimentales como recetas de cocina. A pesar de los avances en los modelos de última generación (LLM), ninguno determina con precisión si un paso de un plan debe preceder o suceder a otro, particularmente en el reconocimiento de no dependencias. Los modelos también muestran inconsistencia en sus predicciones. Solicitar a los LLM que proporcionen una respuesta seguida de una explicación mejora significativamente su desempeño en comparación con el razonamiento seguido de una respuesta. Sin embargo, la evaluación humana de estas explicaciones revela un margen sustancial de mejora en la comprensión de las dependencias de los pasos por parte de los modelos. Estos hallazgos subrayan las limitaciones actuales en los LLM para aplicaciones de razonamiento basado en planes.
Revisar la Papel. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo.
Únete a nuestro Canal de Telegram y LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Subreddit de más de 45 000 millones de usuarios

Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en el IIT Madrás, es un apasionado de la aplicación de la tecnología y la IA para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una perspectiva nueva a la intersección de la IA y las soluciones de la vida real.