
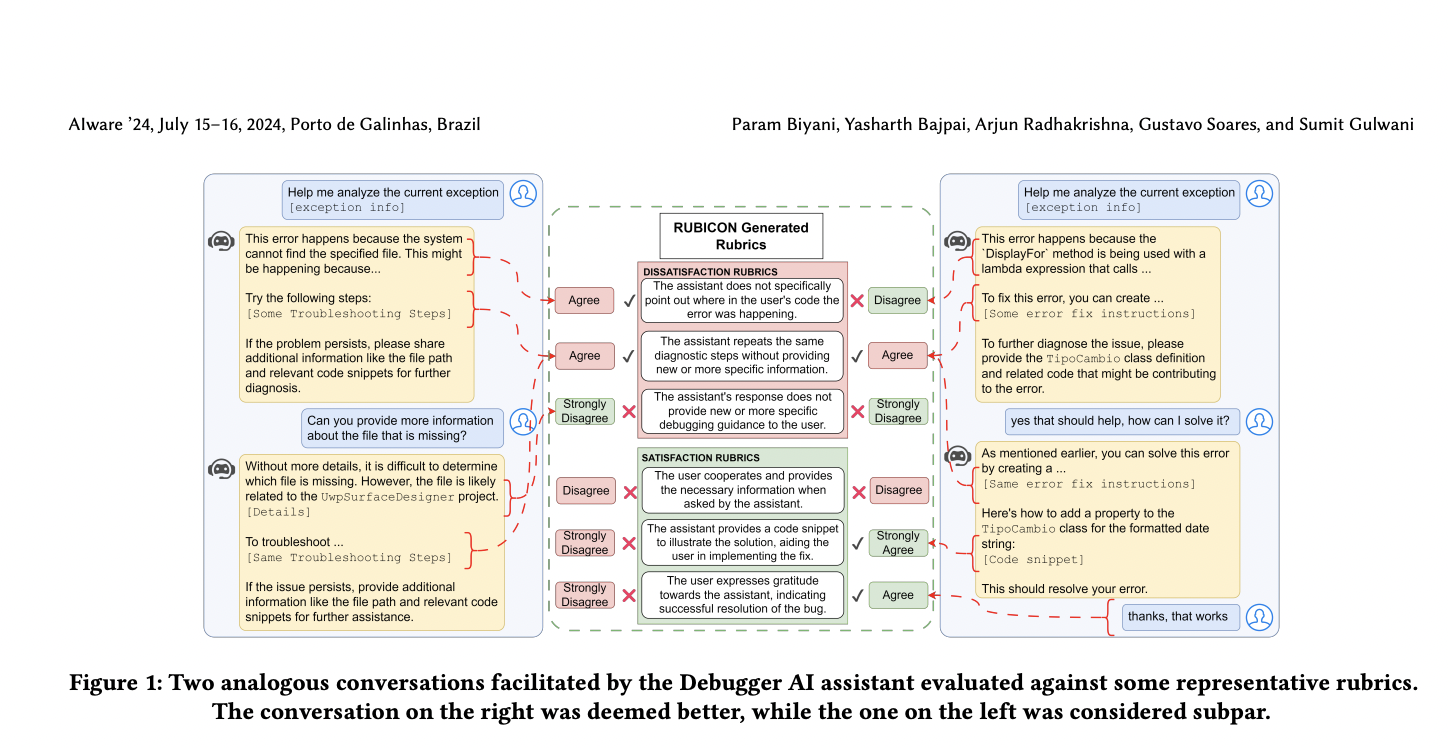
Evaluar los asistentes de IA conversacionales, como GitHub Copilot Chat, es un desafío debido a su dependencia de modelos de lenguaje e interfaces basadas en chat. Las métricas existentes para la calidad conversacional deben revisarse para diálogos específicos de dominio, lo que dificulta que los desarrolladores de software evalúen la efectividad de estas herramientas. Si bien las técnicas como SPUR utilizan grandes modelos de lenguaje para analizar la satisfacción del usuario, pueden pasar por alto matices específicos del dominio. El estudio se centra en generar automáticamente rúbricas de alta calidad y conscientes de las tareas para evaluar los asistentes de IA conversacionales orientados a las tareas, enfatizando la importancia del contexto y la progresión de las tareas para mejorar la precisión de la evaluación.
Investigadores de Microsoft presentan RUBICON, una técnica para evaluar conversaciones entre humanos e inteligencia artificial específicas de un dominio utilizando grandes modelos de lenguaje. RUBICON genera rúbricas candidatas para evaluar la calidad de la conversación y selecciona las que tienen mejor rendimiento. Mejora SPUR al incorporar señales específicas del dominio y máximas de Grice, creando un grupo de rúbricas evaluadas de forma iterativa. RUBICON se probó en 100 conversaciones entre desarrolladores y un asistente basado en chat para la depuración de C#, utilizando GPT-4 para la generación y evaluación de rúbricas. Superó a los conjuntos de rúbricas alternativos, logrando una alta precisión en la predicción de la calidad de la conversación y demostrando la eficacia de sus componentes a través de estudios de ablación.
Las conversaciones en lenguaje natural son fundamentales para las aplicaciones modernas de IA, pero las métricas tradicionales de PNL como BLEU y Perplexity son inadecuadas para evaluar conversaciones de formato largo, especialmente en LLM. Si bien la satisfacción del usuario ha sido una métrica clave, el análisis manual consume muchos recursos y afecta la privacidad. Los enfoques recientes utilizan modelos de lenguaje para evaluar la calidad de la conversación a través de afirmaciones en lenguaje natural, capturando temas de participación y experiencia del usuario. Técnicas como SPUR generan rúbricas para conversaciones de dominio abierto, pero necesitan contextos más específicos del dominio. Este estudio enfatiza un enfoque holístico, que integra las expectativas del usuario y el progreso de la interacción, y explora la selección óptima de indicaciones utilizando métodos de bandido para mejorar la precisión de la evaluación.
RUBICON estima la calidad de la conversación para asistentes específicos de dominio mediante el aprendizaje de rúbricas de satisfacción (SAT) e insatisfacción (DSAT) a partir de conversaciones etiquetadas. Implica tres pasos: generar rúbricas diversas, seleccionar un conjunto de rúbricas optimizado y puntuar las conversaciones. Las rúbricas son afirmaciones en lenguaje natural que capturan los atributos de la conversación. Las conversaciones se evalúan utilizando una escala Likert de 5 puntos, normalizada a un [0, 10] La generación de rúbricas implica una extracción y un resumen supervisados, mientras que la selección optimiza las rúbricas para lograr precisión y cobertura. Las pérdidas de precisión y nitidez guían la selección de un subconjunto óptimo de rúbricas, lo que garantiza una evaluación eficaz y precisa de la calidad de la conversación.
La evaluación de RUBICON involucra tres preguntas clave: su efectividad comparada con otros métodos, el impacto de la Sensibilización de Dominio (DS) y los Principios de Diseño de Conversaciones (CDP), y el desempeño de su política de selección. Los datos de conversación, obtenidos de un asistente de C# Debugger Copilot, fueron filtrados y anotados por desarrolladores experimentados, lo que resultó en una división de prueba-entrenamiento 50:50. Se evaluaron métricas como exactitud, precisión, recuperación, puntaje F1, puntaje ΔNetSAT y tasa de rendimiento. Los resultados mostraron que RUBICON supera las líneas base en la separación de conversaciones positivas y negativas y la clasificación de conversaciones con alta precisión, lo que resalta la importancia de las instrucciones DS y CDP.
La validez interna se ve amenazada por la naturaleza subjetiva de las etiquetas de verdad fundamental asignadas manualmente a pesar del alto acuerdo entre anotadores. La validez externa está limitada por la falta de diversidad del conjunto de datos, que es específico de las tareas de depuración de C# en una empresa de software, lo que potencialmente afecta la generalización a otros dominios. Los problemas de validez de constructo incluyen la dependencia de un sistema de puntuación automatizado y suposiciones realizadas al convertir las respuestas de la escala Likert en una [0, 10] Escala. El trabajo futuro abordará diferentes métodos de cálculo para la puntuación NetSAT. RUBICON ha logrado mejorar la calidad de la rúbrica y diferenciar la efectividad de la conversación, lo que demuestra su valor en la implementación en el mundo real.
Revisar la Papel y Detalles. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo.
Únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Subreddit de más de 46 000 millones de usuarios

Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en el IIT Madrás, es un apasionado de la aplicación de la tecnología y la IA para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una perspectiva nueva a la intersección de la IA y las soluciones de la vida real.