
Los modelos de lenguajes grandes (LLM) han revolucionado el campo de la inteligencia artificial al realizar una amplia gama de tareas en diferentes dominios. Se espera que estos modelos funcionen a la perfección en varios idiomas, resolviendo problemas complejos y garantizando al mismo tiempo la seguridad. Sin embargo, el desafío radica en mantener la seguridad sin comprometer el rendimiento, especialmente en entornos multilingües. A medida que las tecnologías de IA se vuelven omnipresentes a nivel mundial, es esencial abordar las preocupaciones de seguridad que surgen cuando los modelos entrenados predominantemente en inglés se implementan en varios idiomas y contextos culturales.
La cuestión central gira en torno a equilibrar el rendimiento y la seguridad en los LLM. Los problemas de seguridad surgen cuando los modelos producen resultados sesgados o dañinos, particularmente en idiomas con datos de entrenamiento limitados. Normalmente, los métodos para abordar esto implican ajustar modelos en conjuntos de datos mixtos, combinando tareas de propósito general y de seguridad. Sin embargo, estos enfoques pueden conducir a compensaciones indeseables. En muchos casos, aumentar las medidas de seguridad en los LLM puede afectar negativamente su capacidad para desempeñarse bien en tareas generales. Por lo tanto, el desafío es desarrollar un enfoque que mejore tanto la seguridad como el desempeño en los LLM multilingües sin requerir cantidades masivas de datos específicos de la tarea.
Los métodos actuales utilizados para equilibrar estos objetivos a menudo se basan en técnicas de combinación de datos. Esto implica crear un modelo único entrenándolo en varios conjuntos de datos de diversas tareas e idiomas. Si bien estos métodos ayudan a lograr cierto nivel de capacidad para realizar múltiples tareas, pueden dar lugar a problemas de seguridad que no se abordan correctamente en otros idiomas además del inglés. Además, la complejidad de gestionar numerosas tareas simultáneamente a menudo reduce la capacidad del modelo para desempeñarse bien en cualquiera de ellas. La falta de atención especializada a cada tarea y lenguaje limita la capacidad del modelo para abordar la seguridad y el desempeño general de manera efectiva.
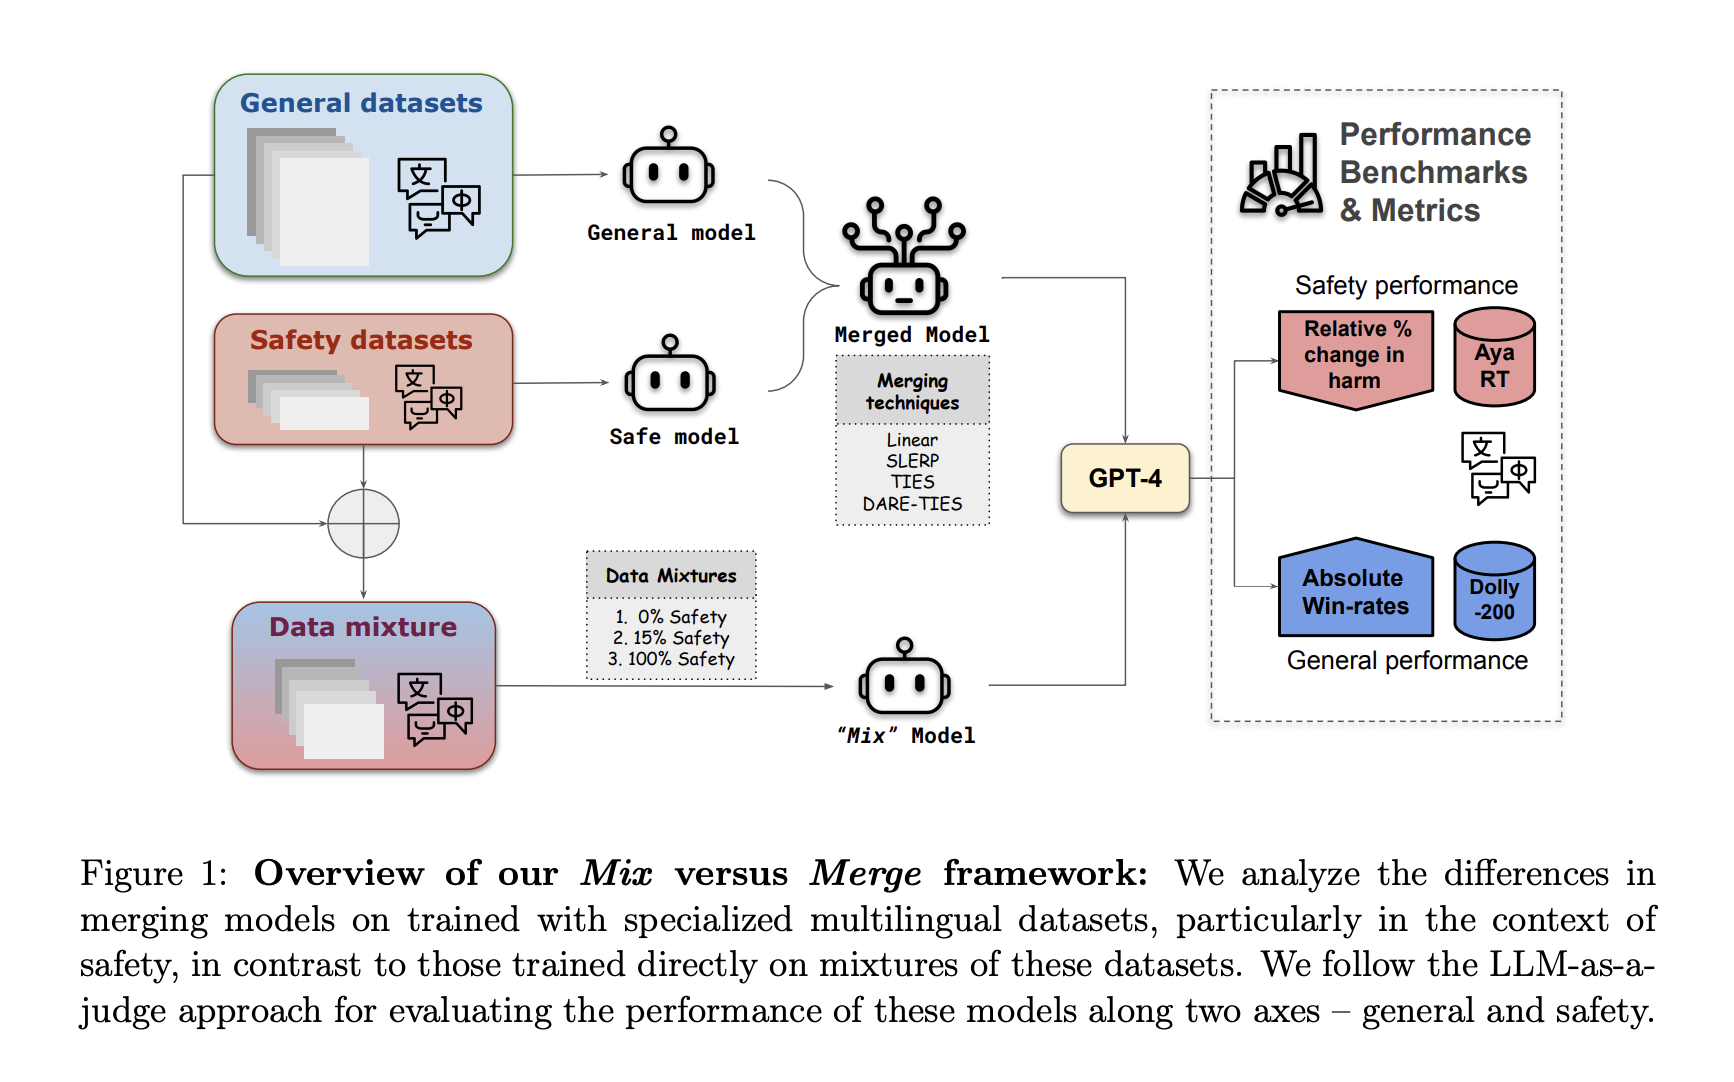
Para superar estas limitaciones, los investigadores de Cohere AI han introducido un enfoque innovador basado en la fusión de modelos. En lugar de confiar en el método tradicional de combinación de datos, donde un único modelo se entrena en múltiples tareas e idiomas, los investigadores proponen fusionar modelos separados que han sido ajustados de forma independiente para tareas e idiomas específicos. Este método permite una mejor especialización dentro de cada modelo antes de fusionarlos en un sistema unificado. Al hacerlo, los modelos conservan sus capacidades únicas y ofrecen mejoras en seguridad y rendimiento general en diversos idiomas.
El proceso de fusión se lleva a cabo mediante múltiples técnicas. El método principal introducido por los investigadores es la interpolación lineal esférica (SLERP), que permite transiciones suaves entre diferentes modelos combinando sus pesos a lo largo de una trayectoria esférica. Esta técnica garantiza que se conserven las propiedades únicas de cada modelo, lo que permite que el modelo fusionado maneje diversas tareas sin comprometer la seguridad o el rendimiento. Otro método, TIES (Estrategia de eliminación de interferencias de tareas), se centra en resolver conflictos entre modelos ajustados para tareas específicas ajustando los parámetros del modelo para alinearse mejor. Las técnicas de fusión también incluyen fusión lineal y DARE-TIES, que mejoran aún más la solidez del modelo final al abordar los problemas de interferencia y garantizar que los parámetros del modelo contribuyan positivamente al rendimiento.
Los resultados de esta investigación muestran claras mejoras tanto en el rendimiento general como en la seguridad. Por ejemplo, la fusión SLERP logró una impresionante mejora del 7% en el rendimiento general y una reducción del 3,1% en resultados dañinos en comparación con los métodos tradicionales de combinación de datos. Por otro lado, la fusión de TIES produjo una notable reducción del 10,4% en los resultados nocivos, aunque redujo ligeramente el rendimiento general en un 7,4%. Estos números indican que la fusión de modelos supera significativamente la combinación de datos al equilibrar la seguridad y el rendimiento. Además, cuando los modelos se ajustaron para idiomas individuales y se fusionaron, los investigadores observaron una reducción de hasta el 6,6 % en resultados dañinos y una mejora del 3,8 % en los puntos de referencia generales, lo que demuestra aún más la eficacia de la fusión de modelos específicos de idiomas sobre el entrenamiento de modelos multilingües.

Las mejoras en el rendimiento fueron particularmente notables en algunos idiomas, siendo el ruso el que mostró la mayor reducción de generaciones dañinas (hasta un 15%) mediante la fusión TIES. Mientras tanto, el español mostró una mejora del 10% en el rendimiento general con los métodos SLERP y TIES. Sin embargo, no todos los idiomas se benefician por igual. Los modelos ingleses, por ejemplo, mostraron una disminución en el desempeño de seguridad cuando se fusionaron, destacando la variabilidad en los resultados basados en los datos de entrenamiento subyacentes y la estrategia de fusión.
La investigación proporciona un marco integral para crear LLM multilingües más seguros y eficaces. Al fusionar modelos ajustados para la seguridad y el rendimiento en tareas e idiomas específicos, los investigadores de Cohere AI demostraron un método más eficiente y escalable para mejorar los LLM. El enfoque reduce la necesidad de cantidades masivas de datos de capacitación y permite una mejor alineación de los protocolos de seguridad en todos los idiomas, lo cual es de vital importancia en el panorama actual de la IA.
En conclusión, la fusión de modelos representa un paso adelante prometedor para abordar el equilibrio entre el rendimiento y los desafíos de seguridad en los LLM, particularmente en entornos multilingües. Este método mejora significativamente la capacidad de los LLM para ofrecer resultados seguros y de alta calidad, especialmente cuando se aplica a idiomas de bajos recursos. A medida que la IA evoluciona, técnicas como la fusión de modelos podrían convertirse en herramientas esenciales para garantizar que los sistemas de IA sean sólidos y seguros en diversos contextos lingüísticos y culturales.
Mira el Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de telegramas y LinkedIn Grarriba. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa.. No olvides unirte a nuestro SubReddit de más de 50.000 ml.
[Upcoming Live Webinar- Oct 29, 2024] La mejor plataforma para ofrecer modelos optimizados: motor de inferencia Predibase (promocionado)

Nikhil es consultor interno en Marktechpost. Está cursando una doble titulación integrada en Materiales en el Instituto Indio de Tecnología de Kharagpur. Nikhil es un entusiasta de la IA/ML que siempre está investigando aplicaciones en campos como los biomateriales y la ciencia biomédica. Con una sólida experiencia en ciencia de materiales, está explorando nuevos avances y creando oportunidades para contribuir.