
publicó una demostración de su último modelo de voz a voz. Un agente de IA conversacional que es en realidad Bueno para hablar, proporcionan respuestas relevantes, hablan con expresiones y, sinceramente, son muy divertidos e interactivos para jugar.
Tenga en cuenta que un documento técnico aún no está fuera, pero tienen un Publicación de blog corta Eso proporciona mucha información sobre las técnicas que utilizaron y los algoritmos anteriores en los que construyeron.
Afortunadamente, me proporcionaron suficiente información para escribir este artículo y hacer un Video de YouTube fuera de eso. ¡Sigue leyendo!
Capacitar a un modelo de habla conversacional
Sesame es un Modelo de habla conversacionalo un CSM. Ingresa tanto texto como de audio, y genera habla como audio. Si bien no han revelado sus fuentes de datos de capacitación en los artículos, aún podemos tratar de adivinar. El blog Cita en gran medida otro CSM, Moshi de 2024y afortunadamente, los creadores de Moshi revelaron sus fuentes de datos en su papel. Moshi usa 7 millones de horas de datos del habla no supervisados, 170 horas de conversaciones naturales y con guiones (para entrenamiento múltiple), y 2000 horas más de conversaciones telefónicas (el conjunto de datos Fischer).
Pero, ¿qué se necesita realmente para generar audio?
En forma bruta, el audio es solo una larga secuencia de valores de amplitud– Una forma de onda. Por ejemplo, si está probando audio a 24 kHz, está capturando 24,000 valores de flotación cada segundo.

Por supuesto, es bastante intensivo en recursos procesar 24000 valores de flotación por solo un segundo de datos especialmente porque los cálculos del transformador se escalan cuadráticamente con la longitud de secuencia. Sería genial si pudiéramos comprimir esta señal y reducir el número de muestras necesarias para procesar el audio.
Tomaremos una inmersión profunda en el Codificador mimiy específicamente Cuantizadores de vectores residuales (RVQ)que son la columna vertebral del modelado de audio/discurso en Aprendizaje profundo hoy. Terminaremos el artículo aprendiendo cómo Sesame genera audio utilizando su arquitectura especial de doble transformador.
Audio de preprocesamiento
La compresión y la extracción de características son donde nos ayuda la convolución. Sesame usa el codificador de discursos MIMI para procesar el audio. Mimi fue introducido en el mencionado Papel moshi también . MIMI es un modelo de codificador de codificador de audio auto-supervisado que convierte las formas de onda de audio en tokens discretos “latentes” primero, y luego reconstruye la señal original. Sesame solo usa la sección del codificador de MIMI para tokenizar los tokens de audio de entrada. Aprendamos cómo.
MIMI ingresa la forma de onda del habla en bruto a 24 kHz, los pasa a través de varias capas de convolución estridadas para reducir la señal, con un factor de zancada de 4, 5, 6, 8 y 2. Esto significa que el primer bloque CNN muestrean el audio por 4x, luego 5x, luego 6x, y así sucesivamente. Al final, se reduce por un factor de 1920, lo que lo reduce a solo 12.5 cuadros por segundo.
Los bloques de convolución también proyectan los valores de flotación originales a una dimensión de incrustación de 512. Cada la incrustación agrega las características locales de la forma de onda 1D original. 1 segundo de audio ahora se representa como alrededor de 12 vectores de tamaño 512. De esta manera, MIMI reduce la longitud de secuencia de 24000 a solo 12 y los convierte en vectores continuos densos.
¿Qué es la cuantificación de audio?
Dadas las incrustaciones continuas obtenidas después de la capa de convolución, queremos tokenizar el discurso de entrada. Si podemos representar el discurso como una secuencia de tokens, podemos aplicar transformadores de aprendizaje de idiomas estándar para entrenar modelos generativos.
Mimi usa un Cuantizador vectorial residual o tokenizador RVQPara lograr esto. Pronto hablaremos sobre la parte residual, pero primero, veamos lo que hace un simple cuantizador de vector de vainilla.
Cuantización vectorial
La idea detrás de la cuantización de vectores es simple: capacita un libro de códigos, que es una colección de, por ejemplo, 1000 codifica el vector aleatorio, todo el tamaño 512 (igual que su dimensión de incrustación).
Luego, dado el vector de entrada, lo asignaremos al vector más cercano en nuestro libro de códigos, básicamente rompiendo un punto a su centro de clúster más cercano. Esto significa que hemos creado efectivamente un vocabulario fijo de tokens para representar cada marco de audio, porque cualquiera que sea la incrustación del marco de entrada, lo representaremos con el centroide de clúster más cercano. Si desea obtener más información sobre la cuantización de Vector, consulte mi video sobre este tema donde me profundice mucho más con esto.
https://www.youtube.com/watch?v=ezdsRevdgnq
Cuantización vectorial residual
El problema con la cuantización del vector simple es que la pérdida de información puede ser demasiado alta porque estamos mapeando cada vector al centroide de su clúster. Este “quebrar” rara vez es perfecto, por lo que siempre hay un error entre la incrustación original y el libro de códigos más cercano.
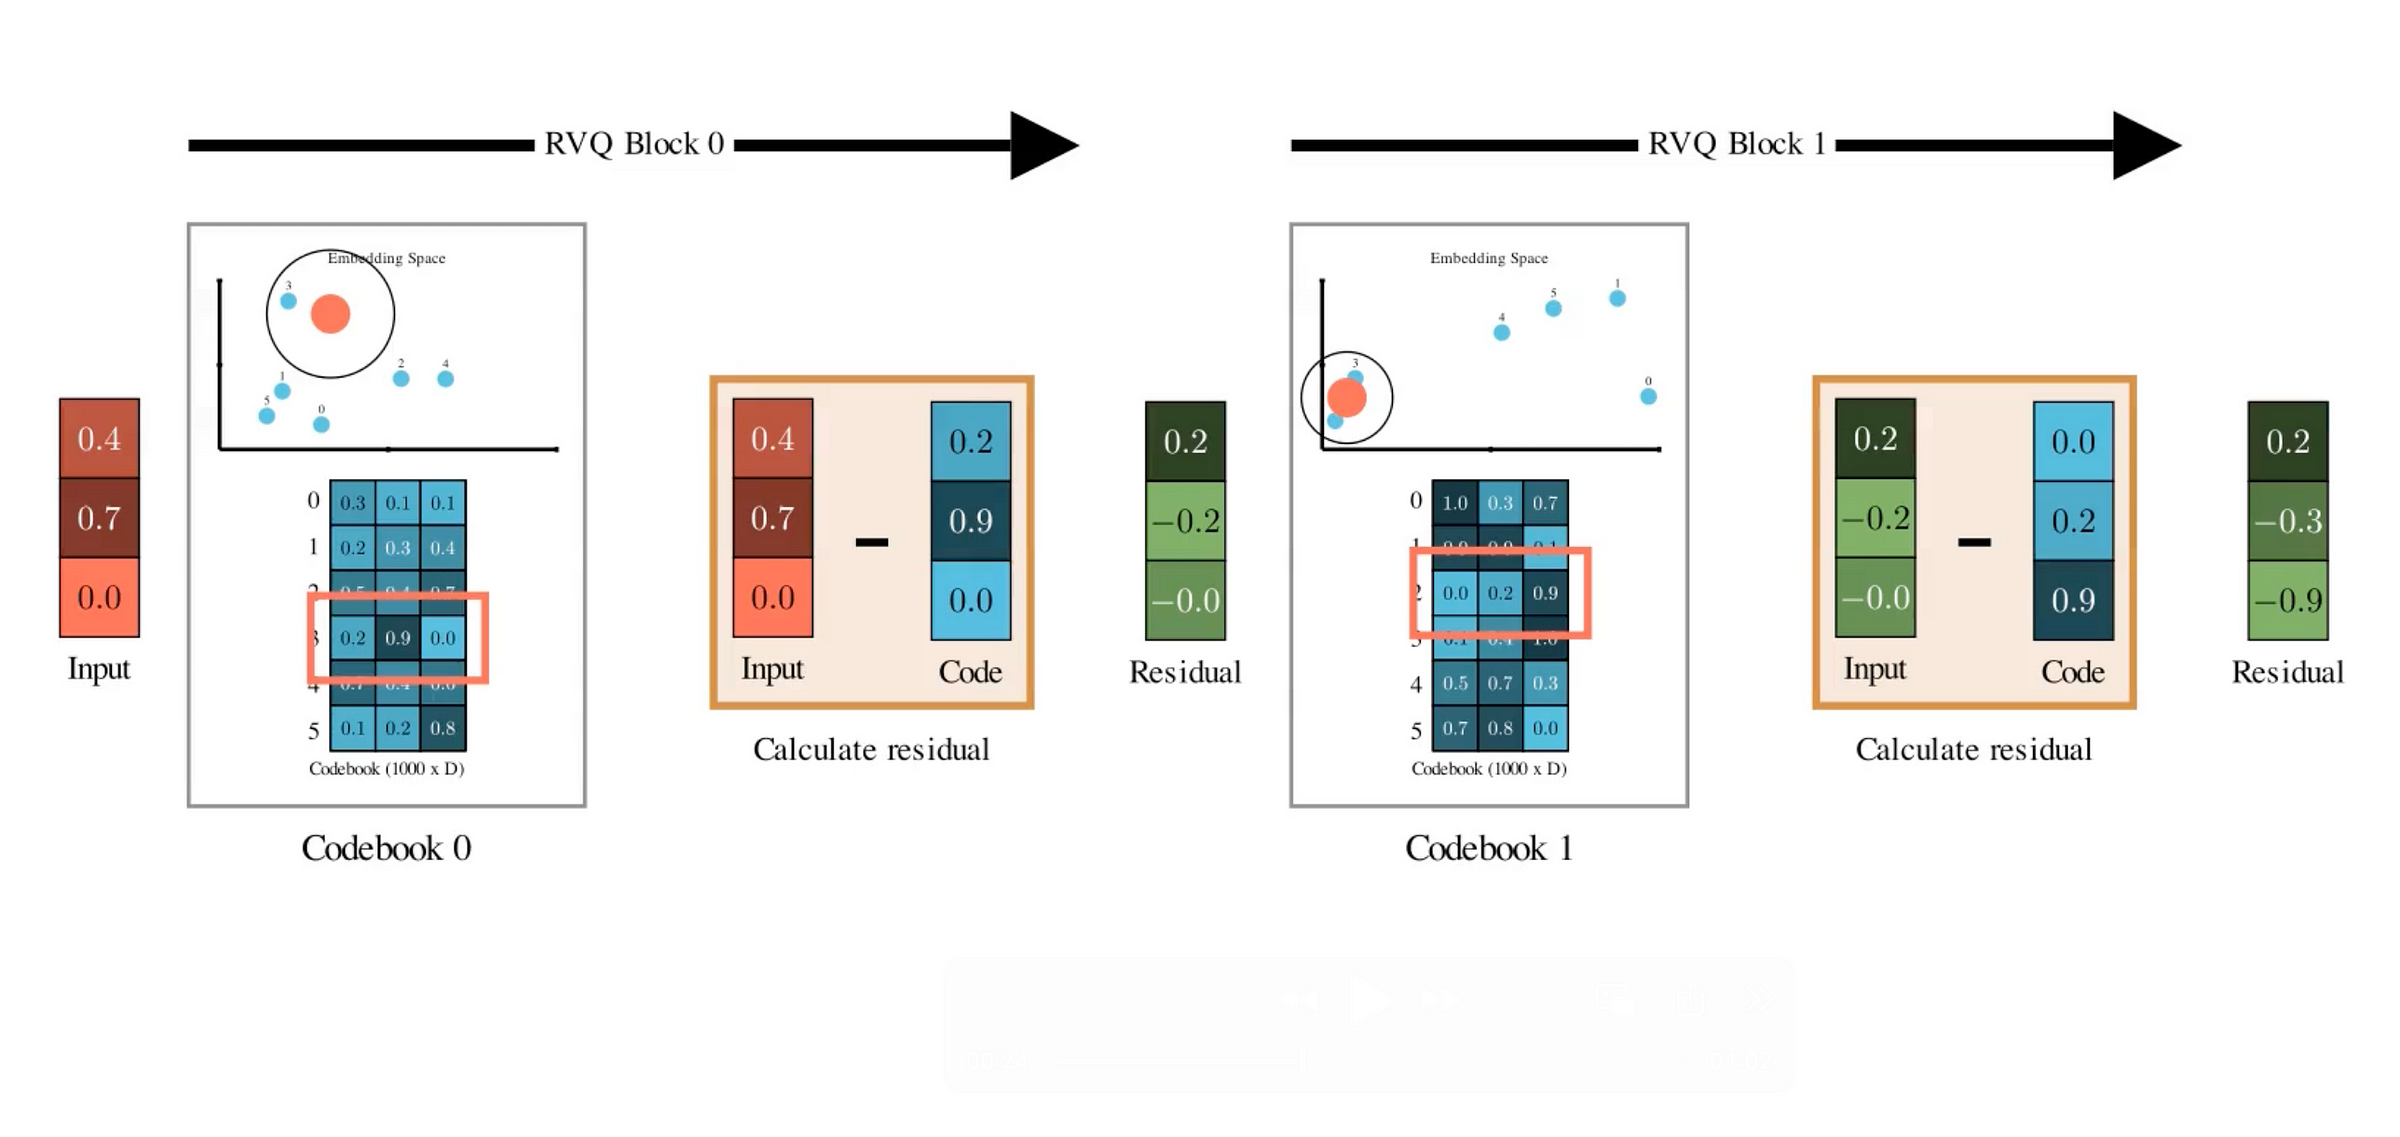
La gran idea de Cuantización vectorial residual es que no se detiene para tener solo un libro de códigos. En su lugar, intenta usar múltiples libros de códigos para representar el vector de entrada.
- Primerocuantifica el vector original utilizando el primer libro de códigos.
- Entoncesrestas ese centroide de tu vector original. Lo que te queda es el residual – El error que no fue capturado en la primera cuantización.
- Ahora toma este residual y Cuantielo de nuevo usando un Segundo libro de códigos lleno de vectores de código nuevo– Nuevamente chocándolo al centroide más cercano.
- Sustraer eso también, y obtienes un residual más pequeño. Cuantite nuevamente con un tercer libro de códigos … y puede seguir haciendo esto para tantos libros de códigos como desee.
Cada paso captura jerárquicamente un poco más de detalle que se perdió en la ronda anterior. Si repite esto para, digamos, n libros de códigos, obtiene una colección de n tokens discretos de cada etapa de cuantificación para representar un marco de audio.
Lo mejor de RVQS es que están diseñados para tener un alto sesgo inductivo para capturar el contenido más esencial en el primer cuantizador. En los cuantificadores posteriores, aprenden más y más características de grano fino.
Si está familiarizado con PCA, puede pensar que el primer libro de códigos que contiene los componentes principales principales, capturando la información más crítica. Los libros de códigos posteriores representan componentes de orden superior, que contienen información que agrega más detalles.
Libros de códigos acústicos vs semánticos
Dado que MIMI está entrenado en la tarea de reconstrucción de audio, el codificador comprime la señal al espacio latente discretizado, y el decodificador lo reconstruye desde el espacio latente. Al optimizar para esta tarea, los libros de códigos RVQ aprenden a capturar el contenido acústico esencial del audio de entrada dentro del espacio latente comprimido.
Mimi también entrena por separado un solo libro de códigos (Vanilla VQ) que solo se enfoca en integrar el contenido semántico del audio. Por eso Mimi se llama tokenizer Split-RVQ– Divide el proceso de cuantización en dos rutas paralelas independientes: una para información semántica y otra para información acústica.
Para capacitar representaciones semánticas, Mimi utilizó la destilación de conocimiento con un modelo de habla existente llamado Wavlm como maestro semántico. Básicamente, MIMI introduce una función de pérdida adicional que disminuye la distancia coseno entre el código RVQ semántico y la incrustación generada por WAVLM.
Decodificador de audio
Dada una conversación que contiene texto y audio, primero los convertimos en una secuencia de insertos de token utilizando el texto y los tokenizadores de audio. Esta secuencia de tokens se ingresa en un modelo de transformador como una serie temporal. En la publicación del blog, este modelo se conoce como el transformador de red troncal autorregresivo. Su tarea es procesar esta serie de tiempo y generar el token del libro de códigos “Zeroth”.
Un transformador de peso más ligero llamado decodificador de audio luego reconstruye los próximos tokens de libro de códigos condicionados en este código Zeroth generado por el transformador de la troncal. Tenga en cuenta que el código Zeroth ya contiene mucha información sobre la historia de la conversación ya que el transformador de la columna vertebral tiene visibilidad de toda la secuencia pasada. El decodificador de audio liviano solo funciona en el token Zeroth y genera el otro N-1códigos. Estos códigos se generan mediante el uso de capas lineales distintas N-1 que generan la probabilidad de elegir cada código de sus libros de códigos correspondientes.
Puede imaginar este proceso como predicción de un token de texto del vocabulario en un LLM de solo texto. Solo que un LLM basado en texto tiene un solo vocabulario, pero el RVQ-Tokenizer tiene múltiples vocabularios en forma de los N libro de códigos, por lo que debe entrenar una capa lineal separada para modelar los códigos para cada uno.
Finalmente, después de que se generan todos los codewords, los agregamos para formar la incrustación de audio continua combinada. El trabajo final es volver a convertir este audio a una forma de onda. Para esto, aplicamos capas convolucionales transpositadas para mejorar la incrustación de 12.5 Hz de regreso a KHz WaveForm Audio. Básicamente, revertir las transformaciones que habíamos aplicado originalmente durante el preprocesamiento de audio.
En resumen
https://www.youtube.com/watch?v=thg9ebbmhp8
Entonces, aquí está el resumen general del modelo de sésamo en algunos puntos de bala.
- Sesame se basa en un modelo de discurso de conversación multimodal o un CSM.
- El texto y el audio se tokenizan juntos para formar una secuencia de tokens y la entrada en el transformador de la troncal que procesa autorregresivamente la secuencia.
- Si bien el texto se procesa como cualquier otro LLM basado en texto, el audio se procesa directamente desde su representación de forma de onda. Utilizan el codificador MIMI para convertir la forma de onda en códigos latentes utilizando un tokenizador RVQ Split.
- Los transformadores de columna vertebral multimodal consumen una secuencia de tokens y predicen el próximo Zeroth Codeword.
- Otro transformador liviano llamado decodificador de audio predice los próximos codewords del Zeroth Codeword.
- La representación final del marco de audio se genera a partir de la combinación de todas las codewords generadas y se muestreó a la representación de la forma de onda.
¡Gracias por leer!
Referencias y documentos de lectura obligada
Sesame BlogPost y demostración
Documentos relevantes:
Moshi: https://arxiv.org/abs/2410.00037
Soundstream: https://arxiv.org/abs/2107.03312
Hubert: https://arxiv.org/abs/2106.07447
Tokenizer del habla: https://arxiv.org/abs/2308.16692