
Estamos emocionados de anunciar que Importación de modelos personalizados de Amazon Bedrock ahora es compatible Qwen modelos. Ahora puede importar pesos personalizados para arquitecturas QWEN2, QWEN2_VL y QWEN2_5_VL, incluidos modelos como Qwen 2, 2.5 Coder, Qwen 2.5 VL y QWQ 32B. Puede llevar sus propios modelos QWEN personalizados a Amazon Bedrock e implementarlos en un entorno totalmente administrado y sin servidor, sin tener que administrar la infraestructura o la porción de modelos.
En esta publicación, cubrimos cómo implementar modelos Qwen 2.5 con la importación del modelo personalizado de rock de Amazon, haciéndolos accesibles para las organizaciones que buscan usar capacidades de IA de última generación dentro de la infraestructura de AWS a un costo efectivo.
Descripción general de los modelos Qwen
Qwen 2 y 2.5 son familias de modelos de idiomas grandes, disponibles en una amplia gama de tamaños y variantes especializadas para satisfacer diversas necesidades:
- Modelos de idiomas generales: Modelos que van desde 0.5B a 72B de parámetros, con versiones base e instructores para tareas de propósito general
- Qwen 2.5 codificador: Especializado para la generación y finalización de código
- Qwen 2.5-math: Centrado en el razonamiento matemático avanzado
- QWEN 2.5-VL (idioma de visión): Capacidades de procesamiento de imágenes y videos, habilitando aplicaciones multimodales
Descripción general de la importación del modelo personalizado de Amazon Bedrock
La importación del modelo personalizado de Amazon Bedrock permite la importación y uso de sus modelos personalizados junto con modelos de base existentes (FMS) a través de una sola API unificada sin servidor. Puede acceder a sus modelos personalizados importados a pedido y sin la necesidad de administrar la infraestructura subyacente. Acelere su desarrollo generativo de aplicaciones de inteligencia artificial integrando sus modelos personalizados con compatible con herramientas y características nativas de roca madre de Amazon, como bases de conocimiento de roca madre de Amazon, barandas de roca madre de Amazon y agentes de roca madre de Amazon. La importación del modelo personalizado de Amazon Bedrock generalmente está disponible en las regiones US-East (N. Virginia), US-West (Oregon) y Europa (Frankfurt) AWS. Ahora, exploraremos cómo puede usar modelos Qwen 2.5 para dos casos de uso comunes: como asistente de codificación y para la comprensión de la imagen. QWEN2.5-Coder es un modelo de código de última generación, capacidades de coincidencia de modelos patentados como GPT-4O. Admite más de 90 lenguajes de programación y sobresale en la generación de códigos, la depuración y el razonamiento. QWEN 2.5-VL trae capacidades multimodales avanzadas. Según Qwen, QWEN 2.5-VL no solo es competente para reconocer objetos como flores y animales, sino también para analizar gráficos, extraer texto de imágenes, interpretar diseños de documentos y procesar videos largos.
Requisitos previos
Antes de importar el modelo QWEN con la importación del modelo personalizado de Amazon Bedrock, asegúrese de tener lo siguiente en su lugar:
- Una cuenta de AWS activa
- Un Amazon Simple Storage Service (Amazon S3) cubo para almacenar los archivos de modelo QWEN
- Permisos suficientes Para crear trabajos de importación de modelos de rock de Amazon
- Verificado que tu La región es compatible con la importación del modelo personalizado de Amazon Bedrock
Caso de uso 1: Asistente de codificación de Qwen
En este ejemplo, demostraremos cómo construir un asistente de codificación utilizando el modelo QWEN2.5coder-7b-Instructo
- Ir a Cara abrazada y busque y copie el ID de modelo QWEN/QWEN2.5-CODER-7B-Instructo:
Usarás Qwen/Qwen2.5-Coder-7B-Instruct por el resto del tutorial. No demostramos pasos ajustados, pero también puede afinar antes de importar.
- Use el siguiente comando para descargar una instantánea del modelo localmente. La biblioteca de Python para la cara de abrazo proporciona una utilidad llamada descarga de instantáneas para esto:
Dependiendo del tamaño de su modelo, esto podría tomar unos minutos. Cuando se complete, su carpeta de modelo QWEN Coder 7B contendrá los siguientes archivos.
- Archivos de configuración: Incluido
config.json,generation_config.json,tokenizer_config.json,tokenizer.jsonyvocab.json - Archivos de modelo: Cuatro
safetensorarchivos ymodel.safetensors.index.json - Documentación:
LICENSE,README.mdymerges.txt

- Cargar el modelo a Amazon S3, usando
boto3o la línea de comando:
aws s3 cp ./extractedfolder s3://yourbucket/path/ --recursive
- Inicie el trabajo del modelo de importación utilizando la siguiente llamada API:
También puede hacerlo utilizando la consola de administración de AWS para Amazon Bedrock.
- En la consola de rock de Amazon, elija Modelos importados En el panel de navegación.
- Elegir Importar un modelo.
- Ingrese los detalles, incluido un Nombre del modelo, Nombre del trabajo de importacióny modelo Ubicación S3.
- Cree un nuevo rol de servicio o use un rol de servicio existente. Luego elija el modelo de importación
- Después de elegir Importar En la consola, debe ver el estado como importación cuando se importa el modelo:
Si está utilizando su propio rol, asegúrese de agregar la siguiente relación de confianza como se describe en Crear un rol de servicio para la importación del modelo.
Después de importar su modelo, espere a que la inferencia del modelo esté lista, y luego chatee con el modelo en el patio de recreo o a través de la API. En el siguiente ejemplo, agregamos Python Para solicitar al modelo que emita directamente el código Python que enumere los elementos en un cubo S3. Recuerde usar la plantilla de chat correcta para las indicaciones de entrada en el formato requerido. Por ejemplo, puede obtener la plantilla de chat correcta para cualquier modelo compatible en la cara de abrazo usando el siguiente código:
Tenga en cuenta que al usar el invoke_model API, debe usar el nombre completo de recursos de Amazon (ARN) para el modelo importado. Puede encontrar el modelo ARN en la consola Batedrock, navegando a la sección de modelos importados y luego viendo la página Detalles del modelo, como se muestra en la siguiente figura
Después de que el modelo esté listo para la inferencia, puede usar el patio de chat en la consola o las API en la base para invocar el modelo.
Caso de uso 2: Qwen 2.5 VL Comprensión de la imagen
Qwen2.5-VL-* ofrece capacidades multimodales, combinando la visión y la comprensión del lenguaje en un solo modelo. Esta sección demuestra cómo implementar Qwen2.5-VL utilizando la importación del modelo personalizado de rock de roca de Amazon y probar sus capacidades de comprensión de imágenes.
Importar QWEN2.5-VL-7B a Amazon Bedrock
Descargue el modelo de Huggingface Face y cárguelo a Amazon S3:
A continuación, importe el modelo a Amazon Bedrock (ya sea a través de la consola o la API):
Prueba las capacidades de visión
Después de completar la importación, pruebe el modelo con una entrada de imagen. El modelo Qwen2.5-Vl-* requiere el formateo adecuado de las entradas multimodales:
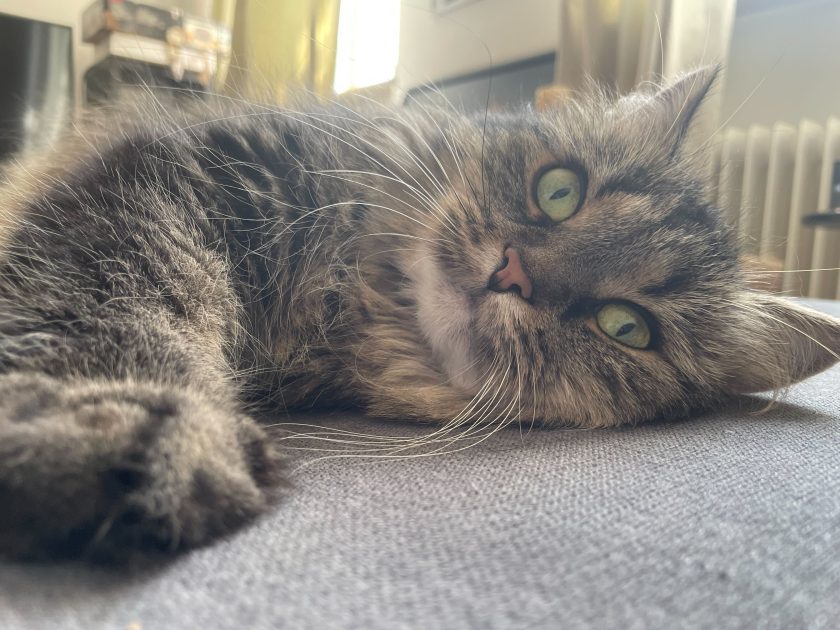
Cuando se le proporciona una imagen de ejemplo de un gato (como la siguiente imagen), el modelo describe con precisión características clave como la posición del gato, el color de piel, el color de los ojos y la apariencia general. Esto demuestra la capacidad del modelo QWEN2.5-VL-* para procesar la información visual y generar descripciones de texto relevantes.
La respuesta del modelo:
Fijación de precios
Puede usar Amazon Bedrock Custom Model Import para usar sus pesos de modelos personalizados dentro de Amazon Bedrock para arquitecturas compatibles, sirviéndolos junto con FMS alojados de Amazon Bedrock de manera totalmente administrada a través del modo a pedido. La importación del modelo personalizado no se cobra por la importación del modelo. Se le cobra por inferencia en función de dos factores: el número de copias del modelo activo y su duración de la actividad. La facturación ocurre en incrementos de 5 minutos, comenzando desde la primera invocación exitosa de cada copia modelo. El precio por copia modelo por minuto varía según los factores que incluyen arquitectura, longitud de contexto, región y versión de la unidad de cómputo, y está nivelado por el tamaño de la copia del modelo. El modelo personalizado requerido para el alojamiento depende de la arquitectura del modelo, el recuento de parámetros y la longitud de contexto. Amazon Bedrock administra automáticamente la escala en función de sus patrones de uso. Si no hay invocaciones durante 5 minutos, se escala a cero y escala cuando sea necesario, aunque esto podría implicar una latencia de inicio frío de hasta un minuto. Se agregan copias adicionales si el volumen de inferencia excede constantemente los límites de concurrencia de una sola copia. El máximo rendimiento y concurrencia por copia se determina durante la importación, en función de factores como la mezcla de token de entrada/salida, tipo de hardware, tamaño del modelo, arquitectura y optimizaciones de inferencia.
Para más información, ver Precio de roca madre de Amazon.
Limpiar
Para evitar cargos continuos después de completar los experimentos:
- Elimine sus modelos QWEN importados de la importación del modelo personalizado de rock de Amazon con la consola o la API.
- Opcionalmente, elimine los archivos de modelo de su cubo S3 si ya no los necesita.
Recuerde que si bien la importación del modelo personalizado de Amazon Bedrock no cobra por el proceso de importación en sí, se le factura por el uso y el almacenamiento de la inferencia de modelos.
Conclusión
Amazon Bedrock Custom Model Import permite a las organizaciones utilizar modelos poderosos disponibles públicamente como Qwen 2.5, entre otros, al tiempo que se beneficia de la infraestructura de grado empresarial. La naturaleza sin servidor de Amazon Bedrock elimina la complejidad de administrar las implementaciones y operaciones de modelos, lo que permite a los equipos centrarse en la creación de aplicaciones en lugar de la infraestructura. Con características como escalado automático, precios de pago por uso e integración perfecta con los servicios de AWS, Amazon Bedrock proporciona un entorno listo para la producción para cargas de trabajo de IA. La combinación de las capacidades de IA avanzadas de Qwen 2.5 y la infraestructura administrada de roca madre de Amazon ofrece un equilibrio óptimo de rendimiento, costo y eficiencia operativa. Las organizaciones pueden comenzar con modelos más pequeños y ampliar según sea necesario, al tiempo que mantienen el control total sobre sus implementaciones de modelos y se benefician de las capacidades de seguridad y cumplimiento de AWS.
Para obtener más información, consulte el Guía del usuario de Amazon Bedrock.
Sobre los autores
Ajit Mahareddy es un líder experimentado de productos y actuación del mercado (GTM) con más de 20 años de experiencia en gestión de productos, ingeniería y mercado. Antes de su rol actual, Ajit lideró a los productos AI/ML de la gestión de productos en las principales empresas de tecnología, incluidas Uber, Turing y EHealth. Le apasiona avanzar en tecnologías generativas de IA e impulsar el impacto del mundo real con IA generativa.
Shreyas subramaniano es un científico principal de datos y ayuda a los clientes mediante el uso de IA generativa y el aprendizaje profundo para resolver sus desafíos comerciales utilizando los servicios de AWS. Shreyas tiene antecedentes en la optimización a gran escala y ML y en el uso de ML y el aprendizaje de refuerzo para acelerar las tareas de optimización.
Yanyan Zhang Es una científica de datos de IA generativa senior en Amazon Web Services, donde ha estado trabajando en tecnologías de IA/ML de vanguardia como especialista generativo de IA, ayudando a los clientes a usar IA generativa para lograr los resultados deseados. Yanyan se graduó de la Universidad de Texas A&M con un doctorado en Ingeniería Eléctrica. Fuera del trabajo, le encanta viajar, hacer ejercicio y explorar cosas nuevas.
Dharinee gupta es una gerente de ingeniería en AWS Bedrock, donde se enfoca en permitir que los clientes utilicen modelos de código abierto a través de soluciones sin servidor. Su equipo se especializa en optimizar estos modelos para ofrecer el mejor saldo de costo-rendimiento para los clientes. Antes de su rol actual, obtuvo una amplia experiencia en sistemas de autenticación y autorización en Amazon, desarrollando soluciones de acceso seguras para las ofertas de Amazon. Dharinee es un apasionado de hacer que las tecnologías AI avanzadas sean accesibles y eficientes para los clientes de AWS.
Lokeshwaran Ravi es ingeniero de compiladores de aprendizaje profundo de AWS, especializado en optimización de ML, aceleración del modelo y seguridad de IA. Se enfoca en mejorar la eficiencia, reducir los costos y construir ecosistemas seguros para democratizar las tecnologías de IA, hacer que la ML de vanguardia sea accesible e impactante en todas las industrias.
June ganó es gerente principal de productos de Amazon Sagemaker JumpStart. Se enfoca en hacer que los modelos de base sean fácilmente descubiertos y utilizables para ayudar a los clientes a construir aplicaciones generativas de inteligencia artificial. Su experiencia en Amazon también incluye aplicaciones de compras móviles y entrega de la última milla.