
Resumen: artículo de opinión para la audiencia general de TDS. Sostengo que la IA es más transparente que los humanos de maneras tangibles. Las afirmaciones de que la IA es una “caja negra” carece de perspectiva y comparación con la opacidad en los estudios de inteligencia humana, que de alguna manera está detrás de los estudios de inteligencia artificial.
lector, es una caja negra. Tu mente es misteriosa. No puedo saber cómo estás pensando. No puedo saber qué harás y no puedo saber si tus palabras son honestas y si justificas tus acciones honestamente y sin pretexto. Aprendemos a comprender y confiar en los humanos de muchos años de introspección y experiencia interactuando con los demás. Pero la experiencia también nos dice que la comprensión se limita a aquellos con antecedentes de vida y confianza de suficientes suficientes para aquellos con motivaciones contrarias a la nuestra.
La inteligencia artificial, mientras sigue siendo misteriosa, es clara en comparación. Puedo investigar una IA por su equivalente a pensamientos y motivaciones y saber que estoy obteniendo la verdad. Además, el equivalente de IA de “antecedentes de vida”, sus datos de entrenamiento y el equivalente de “motivaciones”, su objetivo de entrenamiento, en su mayoría son, si no son completamente conocidos y abiertos al escrutinio y el análisis. Si bien todavía nos falta años de experiencia con los sistemas de IA modernos, sostengo que no hay ningún problema de opacidad; Por el contrario, la relativa transparencia de los sistemas de IA a la inspección, su naturaleza de “caja blanca”, puede ser una base para la comprensión y la confianza.
Es posible que haya oído hablar de la IA como una “caja negra” en dos sentidos: AI como el chatgpt de OpenAi o antrópico Claude son cajas negras Porque no puede inspeccionar su código o parámetros (cuadro negro acceso). En el sentido más general, incluso si pudieras inspeccionar esas cosas (blanco Acceso a la caja), serían de poca ayuda para comprender cómo opera la IA en cualquier medida generalizable. Puede seguir todas las instrucciones que define chatgpt y no obtener más información que si simplemente lea su salida, un corolario para la habitación china argumento. Una mente (humana), sin embargo, es más opaca que incluso la IA de acceso restringido. Dado que las barreras físicas y las restricciones éticas limitan el interrogatorio de los mecanismos del pensamiento humano y nuestros modelos de la arquitectura y los componentes del cerebro son incompletos, la mente humana es más una caja negra, aunque una de las cosas orgánicas, “natural” basadas en el carbono, incluso los modelos AI propietario y de código cerrado. Comparemos lo que la ciencia actual nos cuenta sobre el funcionamiento interno del cerebro humano, por un lado, por un lado y los modelos de IA, por el otro.
A partir de 2025, las únicas estructuras neuronales estáticas que han sido mapeado—Se de una mosca, tiene una pequeña fracción de la complejidad del cerebro humano. Funcionalmente, experimentos utilizando Imágenes de resonancia magnética funcional (fMRI) puede precisar la actividad neuronal a aproximadamente 1 mm3 volúmenes de materia cerebral. La Figura 2 muestra un ejemplo de la estructura neuronal capturada como parte de un estudio de fMRI. El hardware requerido incluye una máquina por valor de al menos $ 200,000, acceso constante al helio líquido y un suministro de humanos muy pacientes dispuestos a mantenerse quieto, mientras que una tonelada de superconductor gira a centímetros de sus cabezas. Mientras que los estudios de fMRI pueden establecer que, por ejemplo, el procesamiento de Las representaciones visuales de caras y casas se asocian con ciertas regiones cerebralesgran parte de lo que sabemos sobre el Funciones del cerebro es gracias a los accidentes literalque por supuesto no son éticamente escalables. Los enfoques experimentales éticos y menos invasivos proporcionan relaciones de señal / ruido relativamente bajas.

Los modelos de código abierto (acceso de caja blanca), incluidos los modelos de lenguaje grande (LLM), se cortan regularmente y se cortan en cubitos (virtualmente) y de otro modo se interrogan de maneras mucho más invasivas de lo posible en los humanos, incluso con la máquina FMRI más cara y el bisturí más agudo, esto utilizando hardware de juegos de computadoras de consumo. Cada bit de cada conexión neuronal puede inspeccionarse y registrarse repetidamente y consistentemente bajo un gran espacio de entradas. La IA no se cansa en el proceso, ni se ve afectado de ninguna manera. Este nivel de acceso, control y repetibilidad nos permite extraer una cantidad masiva de señal de la que podemos realizar mucho análisis de grano fino. Controlar lo que observa una IA nos permite conectar conceptos familiares a componentes y procesos dentro y fuera de una IA de manera útil:
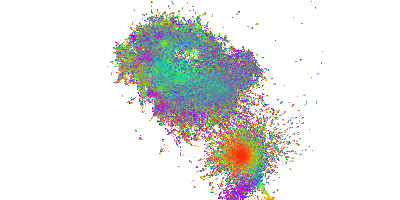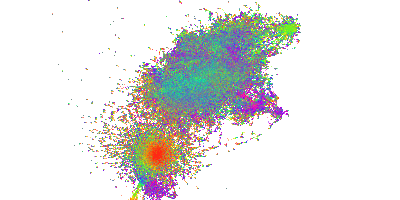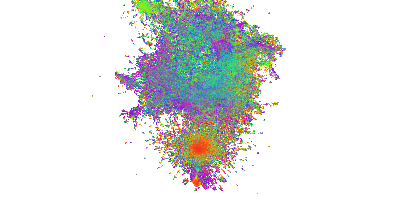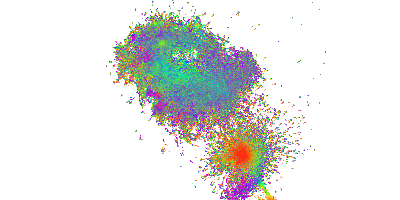
- Asociar actividad neuronal con sobreEPTS similar a un fmri. Podemos decir si una IA está “pensando” en un concepto particular. ¿Qué tan bien podemos saber cuándo un humano está pensando en un concepto en particular? Figs. 1 y 3 son dos representaciones de conceptos de Gemacope que proporciona anotaciones de los conceptos de los modelos Gemma2 de Google a los conceptos.
- Determinar el importancia de entradas particulares a las salidas. Podemos saber si una parte específica de un aviso fue importante para producir la respuesta de una IA. ¿Podemos saber si la decisión de un humano se ve afectada por una preocupación particular?
- Atributo transporte de conceptos como caminos a través de una IA. Esto significa que podemos decir exactamente en qué parte de una red neuronal un concepto recorrió las palabras de entrada a las salidas eventuales. La figura 4 muestra un ejemplo de tal traza de ruta para un concepto gramatical de acuerdo de número de tema. ¿Podemos hacer lo mismo por los humanos?
Los humanos pueden, por supuesto, las respuestas de autoinforme a las dos primeras preguntas anteriores. Puede preguntarle a un gerente de contratación en qué estaban pensando cuando leían su currículum o qué factores fueron importantes en su decisión de ofrecerle un trabajo (o no). Desafortunadamente, los humanos mienten, ellos mismos no saben las razones de sus acciones, o son sesgado de una manera que no son conscientes de. Si bien este también es el caso de la IA generativa, los métodos para la interpretabilidad en el espacio de IA no se basan en las respuestas de IA, veraz, imparcialconsciente de sí mismo, o de otra manera. No necesitamos confiar en los resultados de la IA para saber si está pensando en un concepto particular. Literalmente lo leemos una sonda (virtual) pegada a sus neuronas. Para los modelos de código abierto, esto es trivial, ridículamente tan considerando lo que se necesita para sacar este tipo de información (éticamente) de un humano.
¿Qué pasa con la IA de “caja de caja negra” de fuente cerrada? Se puede inferir mucho solo desde Black Box Access. Se conoce el linaje de los modelos, y también su arquitectura general. Sus componentes básicos son estándar. También pueden ser interrogados a un ritmo mucho más alto de lo que un humano soportaría, y de una manera más controlada y reproducible. La repetibilidad bajo las entradas elegidas es a menudo un reemplazo para el acceso abierto. Se pueden inferir partes de los modelos o su semántica copiada por “destilación”. Por lo tanto, Black-Box no es un impedimento absoluto para la comprensión y la confianza, pero la forma más inmediata de hacer que la IA sea más transparente es permitir el acceso abierto a toda su especificación, a pesar de las tendencias actuales entre los prominentes constructores de IA.
Los humanos pueden ser las máquinas de pensamiento más complejas, por lo que las comparaciones anteriores pueden no parecer justas. Y estamos más inclinados a sentir que entendemos y podemos confiar en los humanos debido a que nuestros años de experiencia son humanos e interactuan con otros humanos (presuntos). Nuestra experiencia con varios AIS está creciendo rápidamente, y también lo son sus capacidades. Si bien los tamaños de los modelos de alto rendimiento también están creciendo, sus arquitecturas generales han sido estables. No hay indicios de que perderemos el tipo de transparencia en su operación descrita anteriormente, incluso cuando logran y posteriormente superen las capacidades humanas. Tampoco hay indicios de que la exploración del cerebro humano sea probable que produzca un avance lo suficientemente significativo como para hacer que la inteligencia menos opaca. La IA no es, y probablemente no se convertirá, la caja negra que el sentimiento humano popular dice que es.
Piotr MardzielCabeza de Ai, Realmlabs.ai.
Sophia Merow y Saurabh shintre contribuido a esta publicación.