
Este artículo es una continuación del modelado de temas de inteligencia de código abierto (OSINT) de la API de OpenAlex. En un artículo anterior, doy una introducción al modelado de temas, los datos utilizados y un enfoque tradicional de PNL utilizando la Asignación Latente de Dirichlet (LDA).
Vea el artículo anterior aquí:
Este artículo utiliza un enfoque más avanzado del modelado de temas aprovechando modelos de representación, IA generativa y otras técnicas avanzadas. Aprovechamos a Bertópica para reunir varios modelos en una sola línea, visualizar nuestros temas y explorar las variaciones de los modelos temáticos.
La tubería de Bertópica
El uso de un enfoque tradicional para el modelado de temas puede ser difícil, la necesidad de construir su propia tubería para limpiar sus datos, tokenizar, lemmatizar, crear características, etc. Los modelos tradicionales como LDA o LSA también son computacionalmente caros y a menudo producen malos resultados.
Bertópica aprovecha la arquitectura del transformador a través de modelos de incrustación e incorpora otros componentes como la reducción de la dimensionalidad y los modelos de representación de temas, para crear modelos de temas de alto rendimiento. Bertopic también proporciona variaciones de modelos para adaptarse a una variedad de datos y casos de uso, visualizaciones para explorar los resultados y más.

La mayor ventaja de Bertópica es su modularidad. Visto arriba, la tubería se compone de varios modelos diferentes:
- Modelo de incrustación
- Modelo de reducción de dimensionalidad
- Modelo de agrupación
- Tokenizador
- Esquema de ponderación
- Modelo de representación (opcional)
Por lo tanto, podemos experimentar con diferentes modelos en cada componente, cada uno con sus propios parámetros. Por ejemplo, podemos probar diferentes modelos de incrustación, cambiar la reducción de la dimensionalidad de PCA a UMAP o intentar ajustar los parámetros en nuestro modelo de agrupación. Esta es una gran ventaja que nos permite ajustar un modelo de tema a nuestros datos y caso de uso.
Primero, necesitamos importar a los módulos necesarios. La mayoría de estos son para construir los componentes de nuestro modelo Bertópico.
#import packages for data management
import pickle

#import packages for topic modeling
from bertopic import BERTopic
from bertopic.representation import KeyBERTInspired
from bertopic.vectorizers import ClassTfidfTransformer
from sentence_transformers import SentenceTransformer
from umap.umap_ import UMAP
from hdbscan import HDBSCAN
from sklearn.feature_extraction.text import CountVectorizer

#import packages for data manipulation and visualization
import pandas as pd
import matplotlib.pyplot as plt
from scipy.cluster import hierarchy as sch
Modelo de incrustación
El componente principal del modelo Bertópico es el modelo de incrustación. Primero, inicializamos el modelo usando el transformador de oraciones. Luego puede especificar el modelo de incrustación que le gustaría usar.
En este caso, estoy usando un modelo relativamente pequeño (~ 30 millones de parámetros). Si bien probablemente podamos obtener mejores resultados utilizando modelos de incrustación más grandes, decidí usar un modelo más pequeño para enfatizar la velocidad en esta tubería. Puede encontrar y comparar modelos de incrustación en función de su tamaño, rendimiento, uso previsto, etc. utilizando la tabla de clasificación MTEB de la cara abrazada (https://huggingface.co/spaces/mteb/leaderboard).
#initalize embedding model
embedding_model = SentenceTransformer('thenlper/gte-small')

#calculate embeddings
embeddings = embedding_model.encode(data['all_text'].tolist(), show_progress_bar=True)
Una vez que ejecutamos nuestro modelo, podemos usar la función .shape para ver el tamaño de los vectores producidos. A continuación, podemos ver que cada incrustación contiene 384 valores que constituyen el significado de cada documento.
#invesigate shape and size of vectors
embeddings.shape

#output: (6102, 384)
Modelo de reducción de dimensionalidad
El siguiente componente del modelo Bertópico es el modelo de reducción de dimensionalidad. Como los datos de alta dimensión pueden ser problemáticos para modelar, podemos usar un modelo de reducción de dimensionalidad para representar los incrustaciones en una representación dimensional más baja sin perder demasiada información.
Existen varios tipos diferentes de modelos de reducción de dimensionalidad, siendo el análisis de componentes principales (PCA) los más populares. En este caso, utilizaremos un modelo de aproximación y proyección de múltiples uniformes (UMAP). El modelo UMAP es un modelo no lineal y es probable que maneje mejor las relaciones complejas en nuestros datos mejor que PCA.
#initialize dimensionality reduction model and reduce embeddings
umap_model = UMAP(n_neighbors=5, min_dist=0.0, metric='cosine', random_state=42)
reduced_embeddings = umap_model.fit_transform(embeddings)
Es importante tener en cuenta que la reducción de la dimensionalidad no es una resolución de datos de alta dimensión. La reducción de la dimensionalidad presenta una compensación entre la velocidad y la precisión a medida que se pierde la información. Estos modelos deben ser bien pensados y experimentados para evitar perder demasiada información mientras mantienen la velocidad y la escalabilidad.
Modelo de agrupación
El tercer paso es usar los incrustaciones reducidas y crear grupos. Si bien la agrupación no suele ser necesaria para el modelado de temas, Podemos aprovechar los modelos de agrupación basados en densidad para aislar valores atípicos y eliminar el ruido en nuestros datos. A continuación, inicializamos la agrupación espacial basada en la densidad jerárquica de aplicaciones con el modelo de ruido (HDBSCAN) y creamos nuestros clústeres.
#initialize clustering model and cluster
hdbscan_model = HDBSCAN(min_cluster_size=30, metric='euclidean', cluster_selection_method='eom').fit(reduced_embeddings)
clusters = hdbscan_model.labels_
Un enfoque basado en la densidad nos brinda algunas ventajas. Los documentos no se ven obligados a los grupos a los que no deben asignarse, por lo tanto, aislar valores atípicos y reducir el ruido en nuestros datos. Además, a diferencia de los modelos basados en centroides, no especificamos el número de grupos, y es más probable que los grupos estén bien definidos.
Vea mi guía para los algoritmos de agrupación:
Consulte el siguiente código para visualizar los resultados del modelo de agrupación.
#create dataframe of reduced embeddings and clusters
df = pd.DataFrame(reduced_embeddings, columns = ['x', 'y'])
df['Cluster'] = [str(c) for c in clusters]

#split between clusters and outliers
to_plot = df.loc[df.Cluster != '-1', :]
outliers = df.loc[df.Cluster == '-1', :]

#plot clusters
plt.scatter(outliers.x, outliers.y, alpha = 0.05, s = 2, c = 'grey')
plt.scatter(to_plot.x, to_plot.y, alpha = 0.6, s = 2, c = to_plot.Cluster.astype(int), cmap = 'tab20b')
plt.axis('off')Podemos ver grupos bien definidos que no se superponen. También podemos ver algunos grupos de grupos más pequeños juntos para compensar temas de nivel superior. Por último, podemos ver que varios documentos están abiertos e identificados como valores atípicos.
Creando una tubería de Bertópica
Ahora tenemos los componentes necesarios para construir nuestra tubería Bertópica (modelo de incrustación, modelo de reducción de dimensionalidad, modelo de agrupación). Podemos usar los modelos que hemos inicializado y encajarlos a nuestros datos utilizando la función Bertópica.
#use models above to BERTopic pipeline
topic_model = BERTopic(
  embedding_model=embedding_model,          # Step 1 - Extract embeddings
  umap_model=umap_model,                    # Step 2 - Reduce dimensionality
  hdbscan_model=hdbscan_model,              # Step 3 - Cluster reduced embeddings
  verbose = True).fit(data['all_text'].tolist(), embeddings)
Como sé que ingirí documentos sobre las interfaces de la máquina humana (realidad aumentada, realidad virtual), veamos qué tema se alinea con el término “realidad aumentada”.
#topics most similar to 'augmented reality'
topic_model.find_topics("augmented reality")

#output: ([18, 3, 16, 24, 12], [0.9532771, 0.9498462, 0.94966936, 0.9451431, 0.9417263])
De la salida anterior, podemos ver que los temas 18, 3, 16, 24 y 12 se alinean altamente con el término “realidad aumentada”. Todo este tema debería (con suerte) contribuir al tema más amplio de la realidad aumentada, pero cada uno cubre un aspecto diferente.
Para confirmar esto, investigemos las representaciones del tema. Una representación del tema es una lista de términos que tienen como objetivo representar adecuadamente el tema subyacente del tema. Por ejemplo, los términos “pastel”, “velas”, “familia” y “regalos” pueden representar colectivamente el tema de los cumpleaños o las fiestas de cumpleaños.
Podemos usar la función get_topic () para investigar la representación del tema 18.
#investigate topic 18
topic_model.get_topic(18)En la representación anterior, vemos algunos términos útiles como “realidad”, “virtual”, “aumentado”, etc. Sin embargo, esto no es útil en su conjunto, ya que vemos varias palabras de parada como “y” y “el”. Esto se debe a que Bertópica usa una bolsa de palabras como la forma predeterminada de representar temas. Esta representación también puede igualar otras representaciones sobre la realidad aumentada.
A continuación, mejoraremos nuestra tubería Bertópica para crear representaciones de temas más significativas que nos dan más información sobre estos temas.
Mejora de las representaciones de temas
Podemos mejorar las representaciones del tema agregando un esquema de ponderación, que resaltará los términos más importantes y diferenciará mejor nuestros temas.
Esto no reemplaza el modelo de la bolsa de palabras, sino que lo mejora. A continuación agregamos un modelo TF-IDF para determinar mejor la importancia de cada término. Usamos la función Update_Topics () para actualizar nuestra tubería.
#initialize tokenizer model
vectorizer_model = CountVectorizer(stop_words="english")

#initialize ctfidf model to weight terms
ctfidf_model = ClassTfidfTransformer()

#add tokenizer and ctfidf to pipeline
topic_model.update_topics(data['all_text'].tolist(), vectorizer_model=vectorizer_model, ctfidf_model=ctfidf_model)
#investigate how topic representations have changed
topic_model.get_topic(18)Con TF-IDF, estas representaciones de temas son mucho más útiles. Podemos ver que las palabras de parada sin sentido se han ido, aparecen otros términos que ayudan a describir el tema, y los términos se reordenan por su importancia.
Pero no tenemos que parar aquí. Gracias a innumerables desarrollos nuevos en el mundo de la IA y la PNL, hay métodos que podemos aprovechar para ajustar estas representaciones.
Para afinar, podemos adoptar uno de los dos enfoques:
- Un modelo de representación
- Un modelo generativo
Ajuste fino con un modelo de representación
Primero, agregemos el modelo KeyBertInspired como nuestro modelo de representación. Esto aprovecha a Bert para comparar la similitud semántica de las representaciones TF-IDF con los documentos mismos para determinar mejor la relevancia de cada término, en lugar de la importancia.
Vea todas las opciones de modelo de representación aquí: https://maartengr.github.io/bertopic/getting_started/representation/representation.html#keybertinspired
#initilzae representation model and add to pipeline
representation_model = KeyBERTInspired()
topic_model.update_topics(data['all_text'].tolist(), vectorizer_model=vectorizer_model, ctfidf_model=ctfidf_model, representation_model=representation_model)Aquí, vemos un cambio bastante importante en los términos, con algunos términos y acrónimos adicionales. Comparando esto con la representación TF-IDF, nuevamente comprendemos mejor de lo que se trata este tema. También observe que los puntajes cambiaron de los pesos TF-IDF, que no tenían ningún significado sin contexto, a puntajes entre 0–1. Estos nuevos puntajes representan los puntajes de similitud semántica.
Visualizaciones del modelo de tema
Antes de pasar a modelos generativos para el ajuste, exploremos algunas de las visualizaciones que ofrece Bertópica. Visualizar los modelos de temas es crucial para comprender sus datos y cómo funciona el modelo.
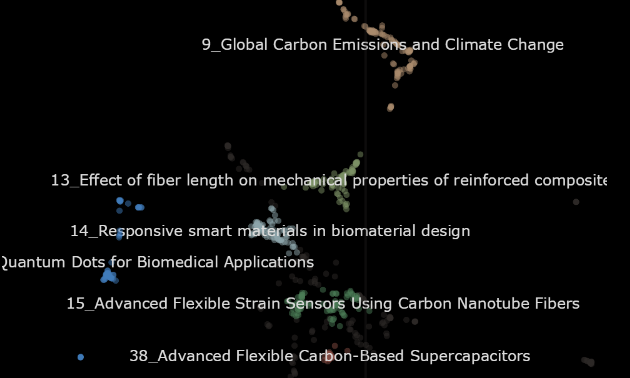
Primero, podemos visualizar nuestros temas en un espacio bidimensional, lo que nos permite ver el tamaño de los temas y qué otros temas son similares. A continuación, podemos ver que tenemos muchos temas, con grupos de temas que forman temas más grandes. También podemos ver un tema grande y aislado, lo que indica que hay una gran cantidad de investigaciones similares con respecto a CRISPR.
Acercemos de estos grupos de temas para ver cómo descomponen los temas de nivel superior. A continuación, ampliamos temas sobre la realidad aumentada y virtual y vemos cómo algunos temas cubren diferentes dominios y aplicaciones.
También podemos visualizar rápidamente los términos más importantes o más relevantes en cada tema. Nuevamente, esto depende de su enfoque de las representaciones del tema.
También podemos usar un mapa de calor para explorar la similitud entre los temas.
Estas son solo algunas de las visualizaciones que ofrece Bertópica. Vea la lista completa aquí: https://maartengr.github.io/bertopic/getting_started/visualization/visualization.html
Aprovechando modelos generativos
Para nuestro último paso de ajustar nuestras representaciones de temas, podemos aprovechar la IA generativa para producir representaciones que sean descripciones coherentes del tema.
Bertópica ofrece una manera fácil de aprovechar los modelos GPT de OpenAI para interactuar con el modelo de tema. Primero establecemos un mensaje que muestra el modelo los datos y la representación actual de los temas. Luego le pedimos que genere una etiqueta corta para cada tema.
Luego inicializamos el cliente y el modelo, y actualizamos nuestra tubería.
import openai
from bertopic.representation import OpenAI
#promt for GPT to create topic labels
prompt = """
I have a topic that contains the following documents:
[DOCUMENTS]
The topic is described by the following key words: [KEYWORDS]
Based on the information above, extract a short topic label in the following format:
topic: <short topic label>
"""
#import GPT
client = openai.OpenAI(api_key='API KEY')
#add GPT as representation model
representation_model = OpenAI(client, model = 'gpt-3.5-turbo', exponential_backoff=True, chat=True, prompt=prompt)
topic_model.update_topics(data['all_text'].tolist(), representation_model=representation_model)Ahora, volvamos al tema de la realidad aumentada.
#investigate how topic representations have changed
topic_model.get_topic(18)
#output: [('Comparative analysis of virtual and augmented reality for immersive analytics',1)]La representación del tema ahora dice “Análisis comparativo de la realidad virtual y aumentada para el análisis inmersivo”. El tema ahora es mucho más claro, ya que podemos ver los objetivos, las tecnologías y el dominio incluidos en estos documentos.
A continuación se muestra la lista completa de nuestras nuevas representaciones de temas.
No se necesita mucho código para ver cuán potente es la IA generativa para apoyar nuestro modelo de tema y sus representaciones. Por supuesto, es extremadamente importante profundizar y validar estas salidas a medida que construye su modelo y hacer mucha experimentación con diferentes modelos, parámetros y enfoques.
Aprovechando variaciones de modelos de temas
Por último, BerTopic proporciona varias variaciones de los modelos de temas para proporcionar soluciones para diferentes datos y casos de uso. Estos incluyen series de tiempo, jerárquicas, supervisadas, semi-supervisadas y muchos más.
Vea la lista completa y la documentación aquí: https://maartengr.github.io/bertopic/getting_started/topicsovertime/topicsovertime.html
Exploremos rápidamente una de estas posibilidades con el modelado de temas jerárquicos. A continuación, creamos una función de enlace usando Scipy, que establece distancias entre nuestros temas. Podemos encajar fácilmente en nuestros datos y visualizar la jerarquía de temas.
#create linkages between topics
linkage_function = lambda x: sch.linkage(x, 'single', optimal_ordering=True)
hierarchical_topics = topic_model.hierarchical_topics(data['all_text'], linkage_function=linkage_function)

#visualize topic model hierarchy
topic_model.visualize_hierarchy(hierarchical_topics=hierarchical_topics)En la visualización anterior, podemos ver cómo los temas se unen para crear temas más amplios y más amplios. Por ejemplo, vemos que los temas 25 y 30 se unen para formar “ciudades inteligentes y desarrollo sostenible”. Este modelo proporciona una capacidad increíble de poder acercar y decidir cuán amplios o estrechos nos gustaría que fueran nuestros temas.
Conclusión
En este artículo, pudimos ver el poder de Bertópica para el modelado de temas. El uso de los transformadores bertopos y los modelos de incrustación mejora drásticamente los resultados de los enfoques tradicionales. La tubería de Bertópica también ofrece potencia y modularidad, aprovechando varios modelos y le permite enchufar otros modelos para que se ajusten a sus datos. Todos estos modelos se pueden ajustar y armar para crear un modelo de tema poderoso.
También puede integrar la representación y los modelos generativos para mejorar las representaciones de los temas y mejorar la interpretabilidad. Bertópica también ofrece varias visualizaciones para explorar realmente sus datos y validar su modelo. Por último, BerTopic ofrece varias variaciones del modelado de temas, como la serie de tiempo o el modelado de temas jerárquicos, para adaptarse mejor a su caso de uso.
¡Espero que hayas disfrutado de mi artículo! No dude en comentar, hacer preguntas o solicitar otros temas.
Conéctese conmigo en LinkedIn: https://www.linkedin.com/in/alexdavis2020/