
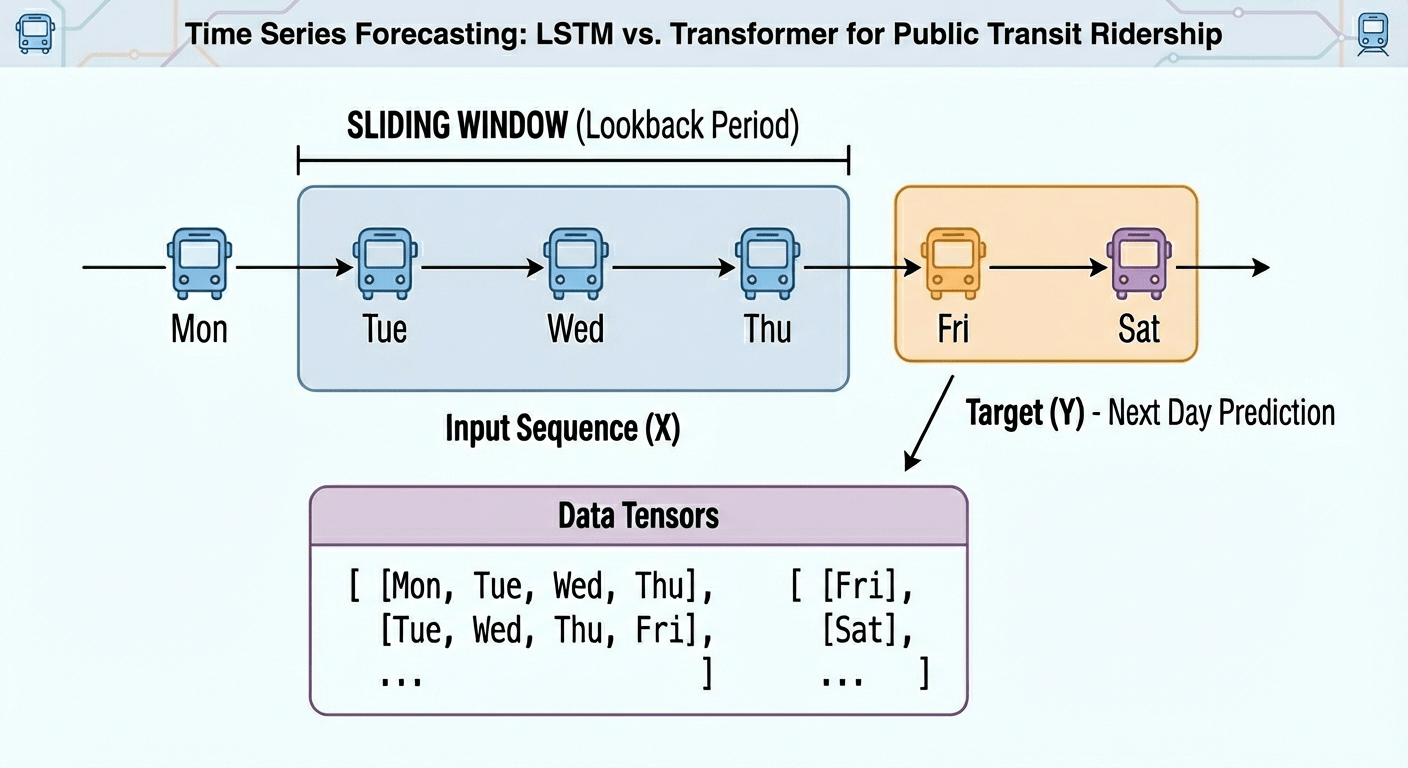
En este artículo, aprenderá cómo construir, entrenar y comparar un LSTM y un transformador para realizar pronósticos de series temporales univariadas del día siguiente a partir de datos reales de transporte público.
Los temas que cubriremos incluyen:
Estructurar y ventanar una serie temporal para el aprendizaje supervisado. Implementación de arquitecturas compactas de LSTM y transformadores en PyTorch. Evaluación y comparación de modelos con MAE y RMSE sobre datos retenidos.
Muy bien, a todo vapor.
Transformer vs LSTM para series temporales: ¿cuál funciona mejor?
Imagen del editor
Introducción
Desde las mediciones meteorológicas diarias o las lecturas de los sensores de tráfico hasta los precios de las acciones, los datos de series temporales están presentes en casi todas partes. Cuando estos conjuntos de datos de series temporales se vuelven más desafiantes, los modelos con un mayor nivel de sofisticación (como métodos de conjunto o incluso arquitecturas de aprendizaje profundo) pueden ser una opción más conveniente que las técnicas clásicas de análisis y pronóstico de series temporales.
El objetivo de este artículo es mostrar cómo se entrenan y utilizan dos arquitecturas de aprendizaje profundo para manejar datos de series temporales: la memoria a corto plazo (LSTM) y el transformador. El objetivo principal no es simplemente aprovechar los modelos, sino comprender sus diferencias al manejar series temporales y si una arquitectura supera claramente a la otra. Se recomiendan conocimientos básicos de Python y conceptos básicos del aprendizaje automático.
Configuración y preparación de problemas
Para esta comparación ilustrativa, consideraremos una tarea de pronóstico en una serie de tiempo univariada: dados los N pasos de tiempo anteriores ordenados temporalmente, predice el (N+1)ésimo valor.
En particular, utilizaremos una versión disponible públicamente del conjunto de datos de viajes de Chicago, que contiene registros diarios de pasajeros de autobús y tren en la red de transporte público de Chicago que se remontan a 2001.
Este fragmento de código inicial importa las bibliotecas y módulos necesarios y carga el conjunto de datos. Importaremos pandas, NumPy, Matplotlib y PyTorch, todo para el trabajo pesado, junto con las métricas de scikit-learn en las que confiaremos para la evaluación.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
from sklearn.metrics import mean_squared_error, mean_absolute_error
url = “https://data.cityofchicago.org/api/views/6iiy-9s97/rows.csv?accessType=DOWNLOAD”
df = pd.read_csv(url, parse_dates=[“service_date”])
print(df.head())
import pandas as pd
import numpy as np
import matplotlib . pyplot as plt
import torch
import torch . nn as nn
from sklearn . metrics import mean_squared_error , mean_absolute_error
url = “https://data.cityofchicago.org/api/views/6iiy-9s97/rows.csv?accessType=DOWNLOAD”
df = pd . read_csv ( url , parse_dates = [ “service_date” ] )
print ( df . head ( ) )
Dado que el conjunto de datos contiene datos reales posteriores a la COVID sobre el número de pasajeros (que pueden inducir a error grave en el poder predictivo de nuestros modelos debido a que están distribuidos de manera muy diferente a los datos anteriores a la COVID), filtraremos los registros a partir del 1 de enero de 2020 en adelante.
df_filtered = df[df[‘service_date’] <= ‘2019-12-31’]
print(“Filtered DataFrame head:”)
display(df_filtered.head())
print(“nShape of the filtered DataFrame:”, df_filtered.shape)
df = df_filtered
df_filtered = df [ df [ ‘service_date’ ] <= ‘2019-12-31’ ]
print ( “Filtered DataFrame head:” )
display ( df_filtered . head ( ) )
print ( “nShape of the filtered DataFrame:” , df_filtered . shape )
df = df_filtered
Un gráfico simple servirá para mostrar cómo se ven los datos filtrados:
df.sort_values(“service_date”, inplace=True)
ts = df.set_index(“service_date”)[“total_rides”].fillna(0)
plt.plot(ts)
plt.title(“CTA Daily Total Rides”)
plt.show()
df . sort_values ( “service_date” , inplace = True )
ts = df . set_index ( “service_date” ) [ “total_rides” ] . fillna ( 0 )
plt . plot ( ts )
plt . title ( “CTA Daily Total Rides” )
pl . espectáculo ( )

Se traza el conjunto de datos de series temporales de paseos en Chicago
A continuación, dividimos los datos de la serie temporal en conjuntos de entrenamiento y prueba. Es importante destacar que en las tareas de pronóstico de series temporales (a diferencia de la clasificación y la regresión) esta partición no puede realizarse al azar, sino de forma puramente secuencial. En otras palabras, todas las instancias de capacitación aparecen cronológicamente primero, seguidas de las instancias de prueba. Este código toma el primer 80% de la serie temporal como conjunto de entrenamiento y el 20% restante para prueba.
n = len(ts)
train = ts[:int(0.8*n)]
test = ts[int(0.8*n):]
train_vals = train.values.astype(float)
test_vals = test.values.astype(float)
n = len ( ts )
train = ts [ : int ( 0.8 * n ) ]
test = ts [ int ( 0.8 * n ) : ]
train_vals = train . values . astype ( float )
test_vals = test . values . astype ( float )
Además, las series de tiempo sin procesar deben convertirse en secuencias etiquetadas (x, y) que abarquen una ventana de tiempo fija para entrenar adecuadamente modelos basados en redes neuronales sobre ellas. Por ejemplo, si utilizamos una ventana de tiempo de N=30 días, la primera instancia abarcará los primeros 30 días de la serie temporal y la etiqueta asociada para predecir será el día 31, y así sucesivamente. Esto le da al conjunto de datos un formato etiquetado apropiado para tareas de aprendizaje supervisadas sin perder su importante significado temporal:
def create_sequences(data, seq_len=30):
X, y =[],[]para i en rango(len(data)-seq_len): X.append(data[i:i+seq_len]) y.append(data[i+seq_len]) return np.array(X), np.array(y) SEQ_LEN = 30 X_train, y_train = create_sequences(train_vals, SEQ_LEN) X_test, y_test = create_sequences(test_vals, SEQ_LEN) # Convertir nuestros datos formateados en tensores de PyTorch X_train = torch.tensor(X_train).float().unsqueeze(-1) y_train = torch.tensor(y_train).float().unsqueeze(-1) X_test = torch.tensor(X_test).float().unsqueeze(-1) y_test = antorcha.tensor(y_test).float().unsqueeze(-1)
def crear_secuencias ( datos , seq_len = 30 ) :
x , y = [ ] , [ ]
para i en rango ( len ( datos ) – seq_len ) :
X. agregar ( datos [ i : i + seq_len ] )
y . agregar ( datos [ i + seq_len ] )
devolver np . matriz ( X ) , np . matriz ( y )
SEQ_LEN = 30
X_tren , y_tren = crear_secuencias ( train_vals , SEQ_LEN )
X_prueba , y_prueba = crear_secuencias ( test_vals , SEQ_LEN )
# Convertir nuestros datos formateados en tensores de PyTorch
X_tren = antorcha . tensor ( X_train ) . flotar ( ) . descomprimir ( – 1 )
y_tren = antorcha . tensor ( y_train ) . flotar ( ) . descomprimir ( – 1 )
X_prueba = antorcha . tensor ( X_test ) . flotar ( ) . descomprimir ( – 1 )
y_prueba = antorcha . tensor ( y_test ) . flotar ( ) . descomprimir ( – 1 )
¡Ahora estamos listos para entrenar, evaluar y comparar nuestros modelos LSTM y transformadores!
Entrenamiento modelo
Usaremos la biblioteca PyTorch para la etapa de modelado, ya que proporciona las clases necesarias para definir tanto capas LSTM recurrentes como capas transformadoras de solo codificador adecuadas para tareas predictivas.
En primer lugar, tenemos una arquitectura RNN basada en LSTM como esta:
class LSTMModel(nn.Module):
def __init__(self, hidden=32):
super().__init__()
self.lstm = nn.LSTM(1, hidden, batch_first=True)
self.fc = nn.Linear(hidden, 1)
def forward(self, x):
out, _ = self.lstm(x)
return self.fc(out[:, -1])
lstm_model = LSTMModel()
class LSTMModel ( nn . Module ) :
def __init__ ( self , hidden = 32 ) :
super ( ) . __init__ ( )
self . lstm = nn . LSTM ( 1 , hidden , batch_first = True )
self . fc = nn . Linear ( hidden , 1 )
def forward ( self , x ) :
out , _ = self . lstm ( x )
return self . fc ( out [ : , – 1 ] )
lstm_model = LSTMModel ( )
En cuanto al transformador de solo codificador para el pronóstico de series temporales del día siguiente, tenemos:
class SimpleTransformer(nn.Module):
def __init__(self, d_model=32, nhead=4):
super().__init__()
self.embed = nn.Linear(1, d_model)
enc_layer = nn.TransformerEncoderLayer(d_model=d_model, nhead=nhead, batch_first=True)
self.transformer = nn.TransformerEncoder(enc_layer, num_layers=1)
self.fc = nn.Linear(d_model, 1)
def forward(self, x):
x = self.embed(x)
x = self.transformer(x)
return self.fc(x[:, -1])
transformer_model = SimpleTransformer()
class SimpleTransformer ( nn . Module ) :
def __init__ ( self , d_model = 32 , nhead = 4 ) :
super ( ) . __init__ ( )
self . embed = nn . Linear ( 1 , d_model )
enc_capa = nn . TransformerEncoderLayer ( d_modelo = d_modelo , ncabeza = ncabeza , lote_primero = Verdadero )
ser . transformador = nn . TransformerEncoder ( enc_layer , número_capas = 1 )
ser . FC = nn . Lineal ( d_modelo , 1 )
def adelante ( yo , x ) :
incógnita = ser . incrustar ( x )
incógnita = ser . transformador ( x )
devolver ser . fc ( x [ :, – 1 ] )
modelo_transformador = Transformador simple ( )
Tenga en cuenta que la última capa en ambas arquitecturas sigue un patrón similar: su forma de entrada es la dimensionalidad de representación oculta (32 en nuestro ejemplo), y se utiliza una sola neurona para realizar un único pronóstico del total de viajes del día siguiente.
Es hora de entrenar los modelos y evaluar el rendimiento de ambos modelos con los datos de prueba:
def train(model, X, y, epochs=10):
model.train()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_fn = nn.MSELoss()
for epoch in range(epochs):
opt.zero_grad()
out = model(X)
loss = loss_fn(out, y)
loss.backward()
opt.step()
return model
lstm_model = train(lstm_model, X_train, y_train)
transformer_model = train(transformer_model, X_train, y_train)
def train ( model , X , y , epochs = 10 ) :
model . train ( )
opt = torch . optim . Adam ( model . parameters ( ) , lr = 1e – 3 )
loss_fn = nn . MSELoss ( )
for epoch in range ( epochs ) :
opt . zero_grad ( )
out = model ( X )
loss = loss_fn ( out , y )
loss . backward ( )
opt . step ( )
return model
lstm_model = train ( lstm_model , X_train , y_train )
transformer_model = train ( transformer_model , X_train , y_train )
Compararemos el rendimiento de los modelos para una tarea de pronóstico de series de tiempo univariadas utilizando dos métricas comunes: error absoluto medio (MAE) y error cuadrático medio (RMSE).
lstm_model.eval()
transformer_model.eval()
pred_lstm = lstm_model(X_test).detach().numpy().flatten()
pred_trans = transformer_model(X_test).detach().numpy().flatten()
true_vals = y_test.numpy().flatten()
rmse_lstm = np.sqrt(mean_squared_error(true_vals, pred_lstm))
mae_lstm = mean_absolute_error(true_vals, pred_lstm)
rmse_trans = np.sqrt(mean_squared_error(true_vals, pred_trans))
mae_trans = mean_absolute_error(true_vals, pred_trans)
print(f”LSTM RMSE={rmse_lstm:.1f}, MAE={mae_lstm:.1f}”)
print(f”Trans RMSE={rmse_trans:.1f}, MAE={mae_trans:.1f}”)
lstm_model . eval ( )
transformer_model . eval ( )
pred_lstm = lstm_model ( X_test ) . detach ( ) . numpy ( ) . flatten ( )
pred_trans = transformer_model ( X_test ) . detach ( ) . numpy ( ) . flatten ( )
true_vals = y_test . numpy ( ) . flatten ( )
rmse_lstm = np . sqrt ( mean_squared_error ( true_vals , pred_lstm ) )
mae_lstm = mean_absolute_error ( true_vals , pred_lstm )
rmse_trans = np . sqrt ( mean_squared_error ( true_vals , pred_trans ) )
mae_trans = mean_absolute_error ( true_vals , pred_trans )
print ( f “LSTM RMSE={rmse_lstm:.1f}, MAE={mae_lstm:.1f}” )
print ( f “Trans RMSE={rmse_trans:.1f}, MAE={mae_trans:.1f}” )
Discusión de resultados
Aquí están los resultados que obtuvimos:
LSTM RMSE=1350000.8, MAE=1297517.9
Trans RMSE=1349997.3, MAE=1297514.1
LSTM RMSE = 1350000.8 , MAE = 1297517.9
Trans RMSE = 1349997.3 , MAE = 1297514.1
Los resultados son increíblemente similares entre los dos modelos, lo que dificulta determinar si uno es mejor que el otro (si miramos de cerca, el transformador funciona un poquito mejor, pero la diferencia es realmente insignificante).
¿Por qué los resultados son tan similares? El pronóstico de series temporales univariadas sobre datos que siguen un patrón razonablemente consistente a lo largo del tiempo, como el conjunto de datos que consideramos, puede producir resultados similares en estos modelos porque ambos tienen suficiente capacidad para resolver este problema, aunque la complejidad de cada arquitectura aquí es intencionalmente mínima. Le sugiero que intente todo el proceso nuevamente sin filtrar las instancias posteriores a COVID, manteniendo la misma proporción 80/20 para el entrenamiento y las pruebas en todo el conjunto de datos original, y vea si la diferencia entre los dos modelos aumenta (no dude en comentar sus hallazgos a continuación).
Además, la tarea de pronóstico es a muy corto plazo: solo estamos prediciendo el valor del día siguiente, en lugar de tener un conjunto de etiquetas más complejo y que abarque una ventana de tiempo posterior a la considerada para las entradas X. Si predijimos valores con 30 días de anticipación, la diferencia entre los errores de los modelos probablemente se ampliaría, y podría decirse que el transformador superaría al LSTM (aunque este no siempre será el caso).
Concluyendo
Este artículo mostró cómo abordar una tarea de pronóstico de series de tiempo con dos arquitecturas de aprendizaje profundo diferentes: LSTM y Transformer. Lo guiamos a lo largo de todo el proceso, desde la obtención de los datos hasta el entrenamiento de los modelos, su evaluación, comparación e interpretación de los resultados.