
Introducción
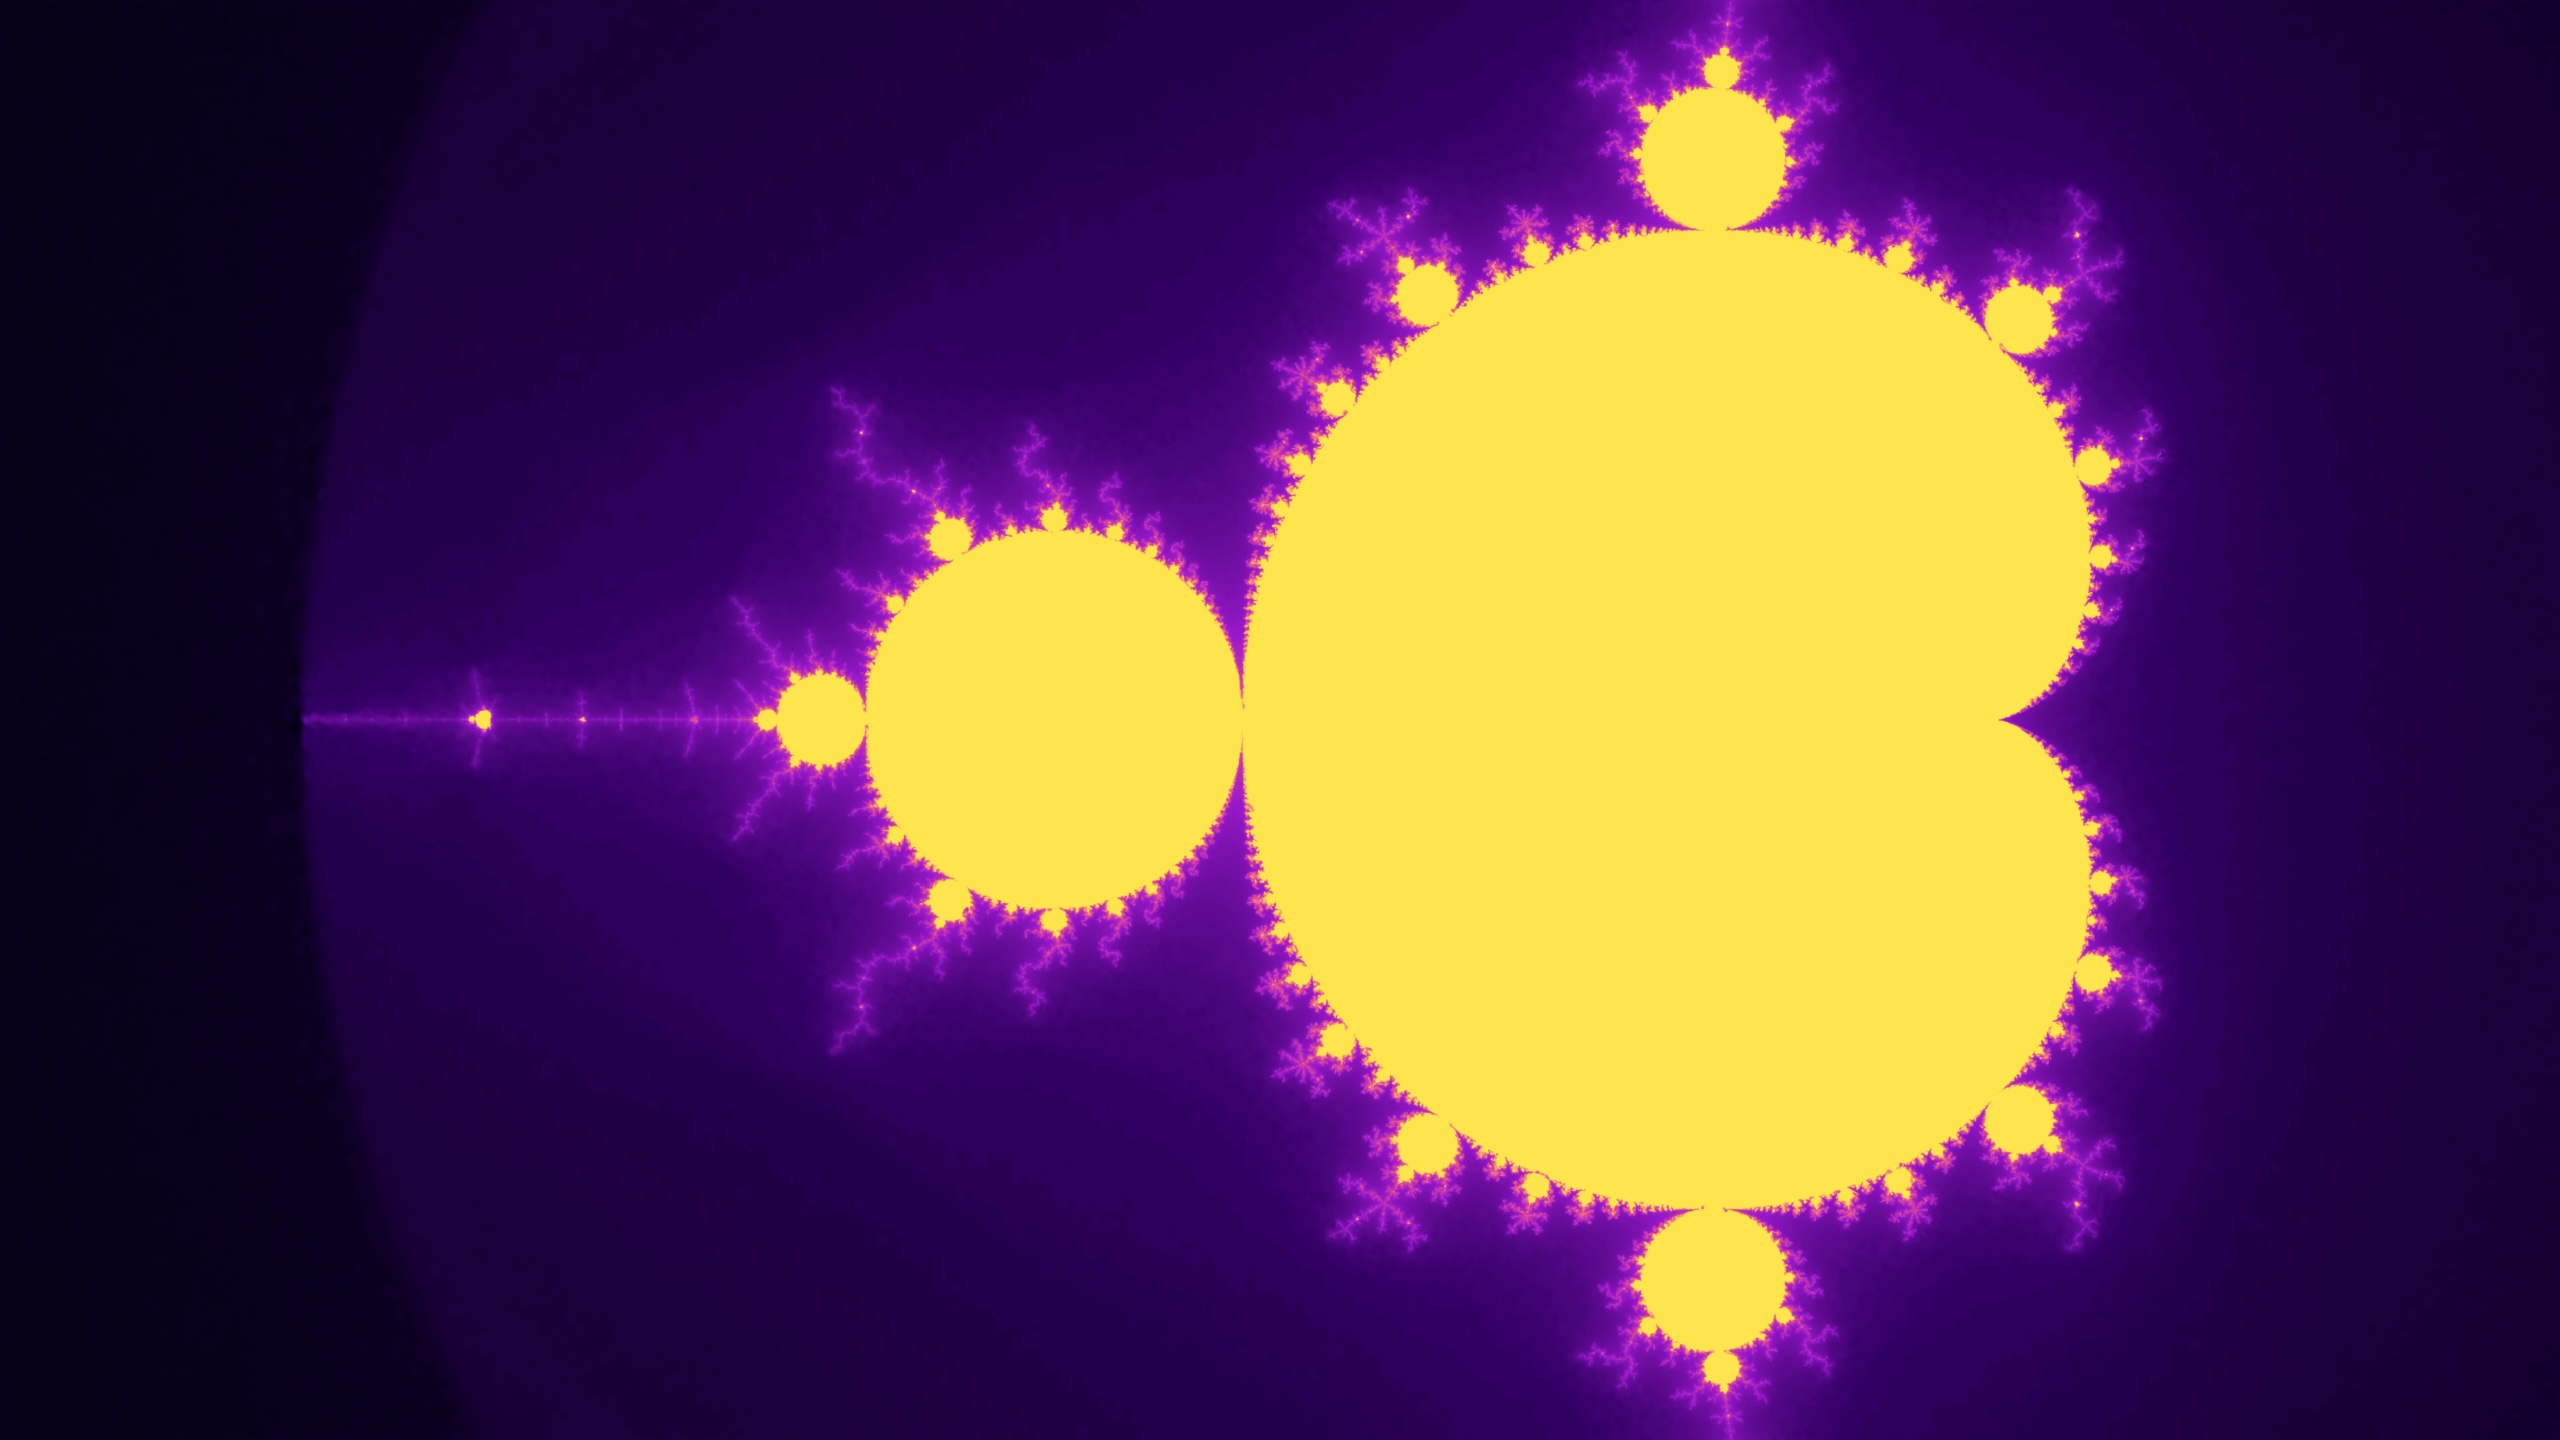
set es uno de los objetos matemáticos más bellos jamás descubiertos, un fractal tan intrincado que no importa cuánto lo acerques, sigues encontrando infinitos detalles. Pero ¿qué pasaría si le pidiéramos a una red neuronal que lo aprendiera?
A primera vista, parece una pregunta extraña. El conjunto de Mandelbrot es totalmente determinista: no hay datos, ni ruido, ni reglas ocultas. Pero esta simplicidad lo convierte en un entorno de pruebas perfecto para estudiar cómo las redes neuronales representan funciones complejas.
En este artículo, exploraremos cómo una red neuronal simple puede aprender a aproximarse al conjunto de Mandelbrot y cómo las características gaussianas de Fourier transforman completamente su rendimiento, convirtiendo aproximaciones borrosas en límites fractales definidos.
A lo largo del camino, profundizaremos en por qué los perceptrones multicapa (MLP) básicos tienen problemas con los patrones de alta frecuencia (el problema del sesgo espectral) y cómo las características de Fourier lo resuelven.
[insertar]https://www.youtube.com/watch?v=dPLnDOixD8g[/embed]
El conjunto de Mandelbrot
El conjunto de Mandelbrot está definido sobre el plano complejo. Para cada número complejo (cin mathbb{C}), consideramos la secuencia iterativa:
$$z_{n+1} = z_n^2 + c, z_0 = 0$$
Si esta secuencia permanece acotada, entonces (c) pertenece al conjunto de Mandelbrot.
En la práctica, aproximamos esta condición utilizando el algoritmo de tiempo de escape. El algoritmo de tiempo de escape itera la secuencia hasta un número máximo fijo de pasos y monitorea la magnitud (|z_n|). Si (|z_n|) excede un radio de escape elegido (normalmente 2), se garantiza que la secuencia diverge y (c) se clasifica como fuera del conjunto de Mandelbrot. Si la secuencia no escapa dentro del número máximo de iteraciones, se supone que (c) pertenece al conjunto de Mandelbrot, y el recuento de iteraciones se utiliza a menudo con fines de visualización.
Convertir el conjunto de Mandelbrot en un problema de aprendizaje
Para entrenar nuestra red neuronal, necesitamos dos cosas. Primero, debemos definir un problema de aprendizaje, es decir, qué debería predecir el modelo y a partir de qué entradas. En segundo lugar, necesitamos datos etiquetados: una gran colección de pares entrada-salida extraídos de ese problema.
Definición del problema de aprendizaje
En esencia, el conjunto de Mandelbrot define una función sobre el plano complejo. Cada punto (c = x +iy in mathbb{C}) se asigna a un resultado: o la secuencia generada por la iteración permanece acotada o diverge. Esto sugiere inmediatamente un problema de clasificación binaria, donde la entrada es un número complejo y la salida indica si el número está dentro del conjunto o no.
Sin embargo, esta formulación plantea dificultades para el aprendizaje. El límite del conjunto de Mandelbrot es infinitamente complejo y perturbaciones arbitrariamente pequeñas en (c) pueden cambiar el resultado de la clasificación. Desde una perspectiva de aprendizaje, esto da como resultado una función objetivo altamente discontinua, lo que hace que la optimización sea inestable e ineficiente para los datos.
Para obtener un objetivo de aprendizaje más fluido e informativo, reformulamos el problema utilizando la información del tiempo de escape presentada en la sección anterior. En lugar de predecir una etiqueta binaria, el modelo está entrenado para predecir una variable continua derivada del recuento de iteraciones en el que se escapa la secuencia.
Para producir una función objetivo continua no utilizamos directamente el recuento de iteraciones de escape sin procesar. El recuento de iteraciones de escape sin procesar es una cantidad discreta; su uso introduciría discontinuidades, particularmente cerca del límite del conjunto de Mandelbrot, donde pequeños cambios en (c) pueden provocar grandes saltos en el recuento de iteraciones. Para solucionar esto, empleamos un valor de tiempo de escape suave, que incorpora el recuento de iteraciones de escape para producir un objetivo continuo. Además, también aplicamos una escala logarítmica que extiende los valores de escape tempranos y comprime los más grandes, lo que produce una distribución objetivo más equilibrada.
def smooth_escape(x: float, y: float, max_iter: int = 1000) -> float: c = complex(x, y) z = 0j para n en rango(max_iter): z = z*z + c r2 = z.real*z.real + z.imag*z.imag si r2 > 4.0: r = math.sqrt(r2) mu = n + 1 – math.log(math.log(r)) / math.log(2.0) # suave # escala logarítmica para difundir pequeño mu v = math.log1p(mu) / math.log1p(max_iter) return float(np.clip(v, 0.0, 1.0)) return 1.0
Con esta definición, el conjunto de Mandelbrot se convierte en un problema de regresión. La red neuronal está entrenada para aproximar una función $$f : mathbb{R}^2 rightarrow [0,1]$$
mapear coordenadas espaciales ((x, y)) en el plano complejo a un valor de tiempo de escape suave.
Estrategia de muestreo de datos
Un muestreo uniforme del plano complejo sería muy ineficiente, la mayoría de los puntos se encuentran lejos del límite y contienen poca información. Para abordar esto, el conjunto de datos está sesgado hacia regiones límite mediante sobremuestreo y filtrado de puntos cuyos valores de escape caen dentro de una banda predefinida.
def build_boundary_biased_dataset( n_total=800_000, frac_boundary=0.7, xlim=(-2.4, 1.0), res_for_ylim=(3840, 2160), ycenter=0.0, max_iter=1000, band=(0.35, 0.95), seed=0, ): """ – Mezcla de muestras uniformes + muestras de banda límite. – 'banda' selecciona puntos con objetivo en (bajo, alto), que tiende a concentrarse cerca del límite """ rng = np.random.default_rng(seed) ylim = Compute_ylim_from_x(xlim, res_for_ylim, ycenter=ycenter) n_boundary = int(n_total * frac_boundary) n_uniform = n_total – n_boundary. # Conjunto uniforme Xu = sample_uniform(n_uniform, xlim, ylim, seed=seed) # Grupo de límites: sobremuestrear, luego filtrar por banda pool_factor = 20 pool = sample_uniform(n_boundary * pool_factor, xlim, ylim, seed=seed + 1) yp = np.empty((pool.shape[0],), dtype=np.float32) para i, (x, y) en enumerate(pool): yp[i] = smooth_escape(float(x), float(y), max_iter=max_iter) máscara = (yp > band[0]) & (yp < banda[1]) Xb = pool[mask] yb = yp[mask] if len(Xb) < n_boundary: # Si la banda es demasiado estricta, la relaja automáticamente keep = min(len(Xb), n_boundary) print(f"[warn] La banda límite es demasiado estricta; obtuve {len(Xb)} puntos de límite, usando {keep}.") Xb = Xb[:keep] yb = yb[:keep] n_boundary = keep n_uniform = n_total – n_boundary Xu = sample_uniform(n_uniform, xlim, ylim, seed=seed) else: Xb = Xb[:n_boundary] yb = yb[:n_boundary] yu = np.empty((Xu.shape[0],), dtype=np.float32) para i, (x, y) en enumerate(Xu): yu[i] = smooth_escape(float(x), float(y), max_iter=max_iter) X = np.concatenate([Xu, Xb], axis=0).astype(np.float32) y = np.concatenate([yu, yb], axis=0).astype(np.float32) # Mezclar una vez perm = rng.permutation(X.shape[0]) devuelve X[perm], y[perm], ylim
Modelo de referencia: un MLP residual profundo
Nuestro primer intento utiliza un MLP residual profundo que toma coordenadas cartesianas sin procesar ((x, y)) como entrada y predice el valor de escape suave.
# Clase de modelo de línea base MLPRes(nn.Module): def __init__( self, hide_dim=256, num_blocks=8, act="silu", dropout=0.0, out_dim=1, ): super().__init__() activación = nn.ReLU if act.lower() == "relu" else nn.SiLU self.in_proj = nn.Linear(2, oculto_dim) self.in_act = activación() self.blocks = nn.Sequential(*[ ResidualBlock(hidden_dim, act=act, dropout=dropout) for _ in range(num_blocks) ]) self.out_ln = nn.LayerNorm(hidden_dim) self.out_act = activación() self.out_proj = nn.Linear(hidden_dim, out_dim) def forward(self, x): x = self.in_proj(x) x = self.in_act(x) x = self.blocks(x) x = self.out_act(self.out_ln(x)) return self.out_proj(x) # Clase de bloque residual ResidualBlock(nn.Module): def __init__(self, dim: int, act: str = "silu", dropout: float = 0.0): super().__init__() activación = nn.ReLU if act.lower() == "relu" else nn.SiLU # pre-norm-ish (LayerNorm ayuda mucho a la estabilidad con MLP residuales profundos) self.ln1 = nn.LayerNorm(dim) self.fc1 = nn.Linear(dim, dim) self.ln2 = nn.LayerNorm(dim) self.fc2 = nn.Linear(dim, dim) self.act = activación() self.drop = nn.Dropout(dropout) si abandono y abandono > 0 else nn.Identity() # opcional: inicio pequeño para que la última capa comience con identidad cercana nn.init.zeros_(self.fc2.weight) nn.init.zeros_(self.fc2.bias) def adelante(self, x): h = self.ln1(x) h = self.act(self.fc1(h)) h = self.drop(h) h = self.ln2(h) h = self.fc2(h) return x + h
Esta red tiene amplia capacidad: profunda, residual y entrenada en un gran conjunto de datos con optimización estable.
Resultado
La forma global del conjunto de Mandelbrot es claramente reconocible. Sin embargo, los detalles finos cerca del límite están visiblemente borrosos. Las regiones que deberían exhibir una estructura fractal intrincada parecen demasiado lisas y los filamentos delgados están mal definidos o faltan por completo.
No es una cuestión de resolución, datos o profundidad. Entonces, ¿qué está pasando mal?
El problema del sesgo espectral
Las redes neuronales tienen un problema bien conocido llamado sesgo espectral:
tienden a aprender primero las funciones de baja frecuencia y les cuesta representar funciones con oscilaciones rápidas o detalles finos.
El límite de Mandelbrot está dominado por estructuras muy irregulares y llenas de estructuras de pequeña escala, especialmente cerca de su límite. Para capturarlo, la red necesitaría representar variaciones de muy alta frecuencia en la salida a medida que cambian (x) e (y).
Funciones de Fourier: codificación de coordenadas en el espacio de frecuencias
Una de las soluciones más elegantes al problema del sesgo espectral fue introducida en 2020 por Tancik et al. en su artículo Las características de Fourier permiten que las redes aprendan funciones de alta frecuencia en dominios de baja dimensión.
La idea es transformar las coordenadas de entrada antes de introducirlas en la red neuronal. En lugar de dar el ((x, y) bruto), pasamos su proyección sinusoidal sin direcciones aleatorias en un espacio de dimensiones superiores.
Formalmente:
$$gamma(x)=[sin(2 pi Bx),cos(2 pi Bx)]$$
donde (B in mathbb{R}^{d_{in}×d_{feat}}) es una matriz gaussiana aleatoria.
Este mapeo actúa como una expansión aleatoria de la base de Fourier, lo que permite que la red represente más fácilmente detalles de alta frecuencia.
clase GaussianFourierFeatures(nn.Module): def __init__(self, in_dim=2, num_feats=256, sigma=5.0): super().__init__() B = torch.randn(in_dim, num_feats) * sigma self.register_buffer("B", B) def forward(self, x): proj = (2 * torch.pi) * (x @ self.B) return torch.cat([torch.sin(proj), torch.cos(proj)], dim=-1)
Funciones de Fourier gaussiano de múltiples escalas
Una escala de frecuencia única podría no ser suficiente. El conjunto de Mandelbrot exhibe estructura en todas las resoluciones (una característica distintiva de la geometría fractal).
Para capturar esto, utilizamos características gaussianas de Fourier de múltiples escalas, combinando varias bandas de frecuencia:
clase MultiScaleGaussianFourierFeatures(nn.Module): def __init__(self, in_dim=2, num_feats=512, sigmas=(2.0, 6.0, 10.0), seed=0): super().__init__() # dividir características en escalas k = len(sigmas) per = [num_feats // k] * k per[0]+= num_feats – suma(por) Bs =[]g = torch.Generator() g.manual_seed(seed) for s, m in zip(sigmas, per): B = torch.randn(in_dim, m, generador=g) * s Bs.append(B) self.register_buffer("B", torch.cat(Bs, dim=1)) def forward(self, x): proj = (2 * torch.pi) * (x @ self.B) return antorcha.cat([antorcha.sin(proyecto), antorcha.cos(proyecto)], tenue=-1)
Esto proporciona efectivamente a la red una base de frecuencia de resolución múltiple, perfectamente alineada con la naturaleza autosemejante de los fractales.
Modelo final
El modelo final tiene la misma arquitectura que el modelo base, la única diferencia es que utiliza MultiScaleGaussianFourierFeatures.
clase MLPFourierRes(nn.Module): def __init__( self, num_feats=256, sigma=5.0, Hidden_dim=256, num_blocks=8, act="silu", dropout=0.0, out_dim=1, ): super().__init__() self.ff = MultiScaleGaussianFourierFeatures( 2, num_feats=num_feats, sigmas=(2.0, 6.0, sigma), seed=0 ) self.in_proj = nn.Linear(2 * num_feats, oculto_dim) self.blocks = nn.Sequential(*[ ResidualBlock(hidden_dim, act=act, dropout=dropout) for _ in range(num_blocks) ]) self.out_ln = nn.LayerNorm(hidden_dim) activación = nn.ReLU if act.lower() == "relu" else nn.SiLU self.out_act = activación() self.out_proj = nn.Linear(hidden_dim, out_dim) def forward(self, x): x = self.ff(x) x = self.in_proj(x) x = self.blocks(x) x = self.out_act(self.out_ln(x)) devolver self.out_proj(x)
Dinámica de entrenamiento
Entrenamiento sin funciones de Fourier
[insertar]https://www.youtube.com/watch?v=dPLnDOixD8g[/embed]
El modelo aprende lentamente la forma general del conjunto de Mandelbrot, pero luego se estanca. La capacitación adicional no agrega más detalles.
Entrenamiento con funciones de Fourier
[insertar]https://www.youtube.com/watch?v=2nljo9Bzxwg[/embed]
Aquí aparecen primero las estructuras burdas, seguidas de detalles progresivamente más finos. El modelo continúa refinando su predicción en lugar de estabilizarse.
Resultados finales
Ambos modelos utilizaron la misma arquitectura, conjunto de datos y procedimiento de entrenamiento. La red es un perceptrón multicapa residual profundo (MLP) entrenado como modelo de regresión en la formulación de tiempo de escape suave.
Conjunto de datos: 1.000.000 de muestras del plano complejo, con el 70% de los puntos concentrados cerca del límite fractal gracias al muestreo de datos sesgado. Arquitectura: MLP residual con 20 bloques residuales y una dimensión oculta de 512 unidades. Función de activación: Entrenamiento SiLU: 100 épocas, tamaño de lote 4096, optimizador basado en Adam, programador de recocido de coseno.
La única diferencia entre los dos modelos es la representación de las coordenadas de entrada. El modelo de referencia utiliza las coordenadas cartesianas sin procesar, mientras que el segundo modelo utiliza las características de Fourier de múltiples escalas para la representación.
Vista global

Zoom 1 Ver
Vista de zoom 2
Conclusiones
Los fractales como el conjunto de Mandelbrot son un ejemplo extremo de funciones dominadas por estructuras de alta frecuencia. Aproximarlos directamente a partir de coordenadas sin procesar obliga a las redes neuronales a sintetizar oscilaciones cada vez más detalladas, una tarea para la que los MLP no son adecuados.
Lo que muestra este artículo es que la limitación no es la capacidad arquitectónica, el volumen de datos ni la optimización. Es representación.
Al codificar las coordenadas de entrada con características gaussianas de Fourier de múltiples escalas, trasladamos gran parte de la complejidad del problema al espacio de entrada. La estructura de alta frecuencia se vuelve explícita, lo que permite que una red neuronal ordinaria se aproxime a una función que sería demasiado compleja en su forma original.
Esta idea se extiende más allá de los fractales. Las redes neuronales basadas en coordenadas se utilizan en gráficos por computadora, aprendizaje basado en física y procesamiento único. En todas estas configuraciones, la elección de la codificación de entrada puede marcar la diferencia entre aproximaciones suaves y una estructura rica y muy detallada.
Nota sobre los recursos visuales
Todas las imágenes, animaciones y videos mostrados en este artículo fueron generados por el autor a partir de los resultados de los modelos de redes neuronales descritos anteriormente. No se utilizaron renderizadores fractales externos ni recursos visuales de terceros. El código completo utilizado para entrenar, renderizar imágenes y generar animaciones está disponible en el repositorio adjunto.
Código completo
repositorio de Github