
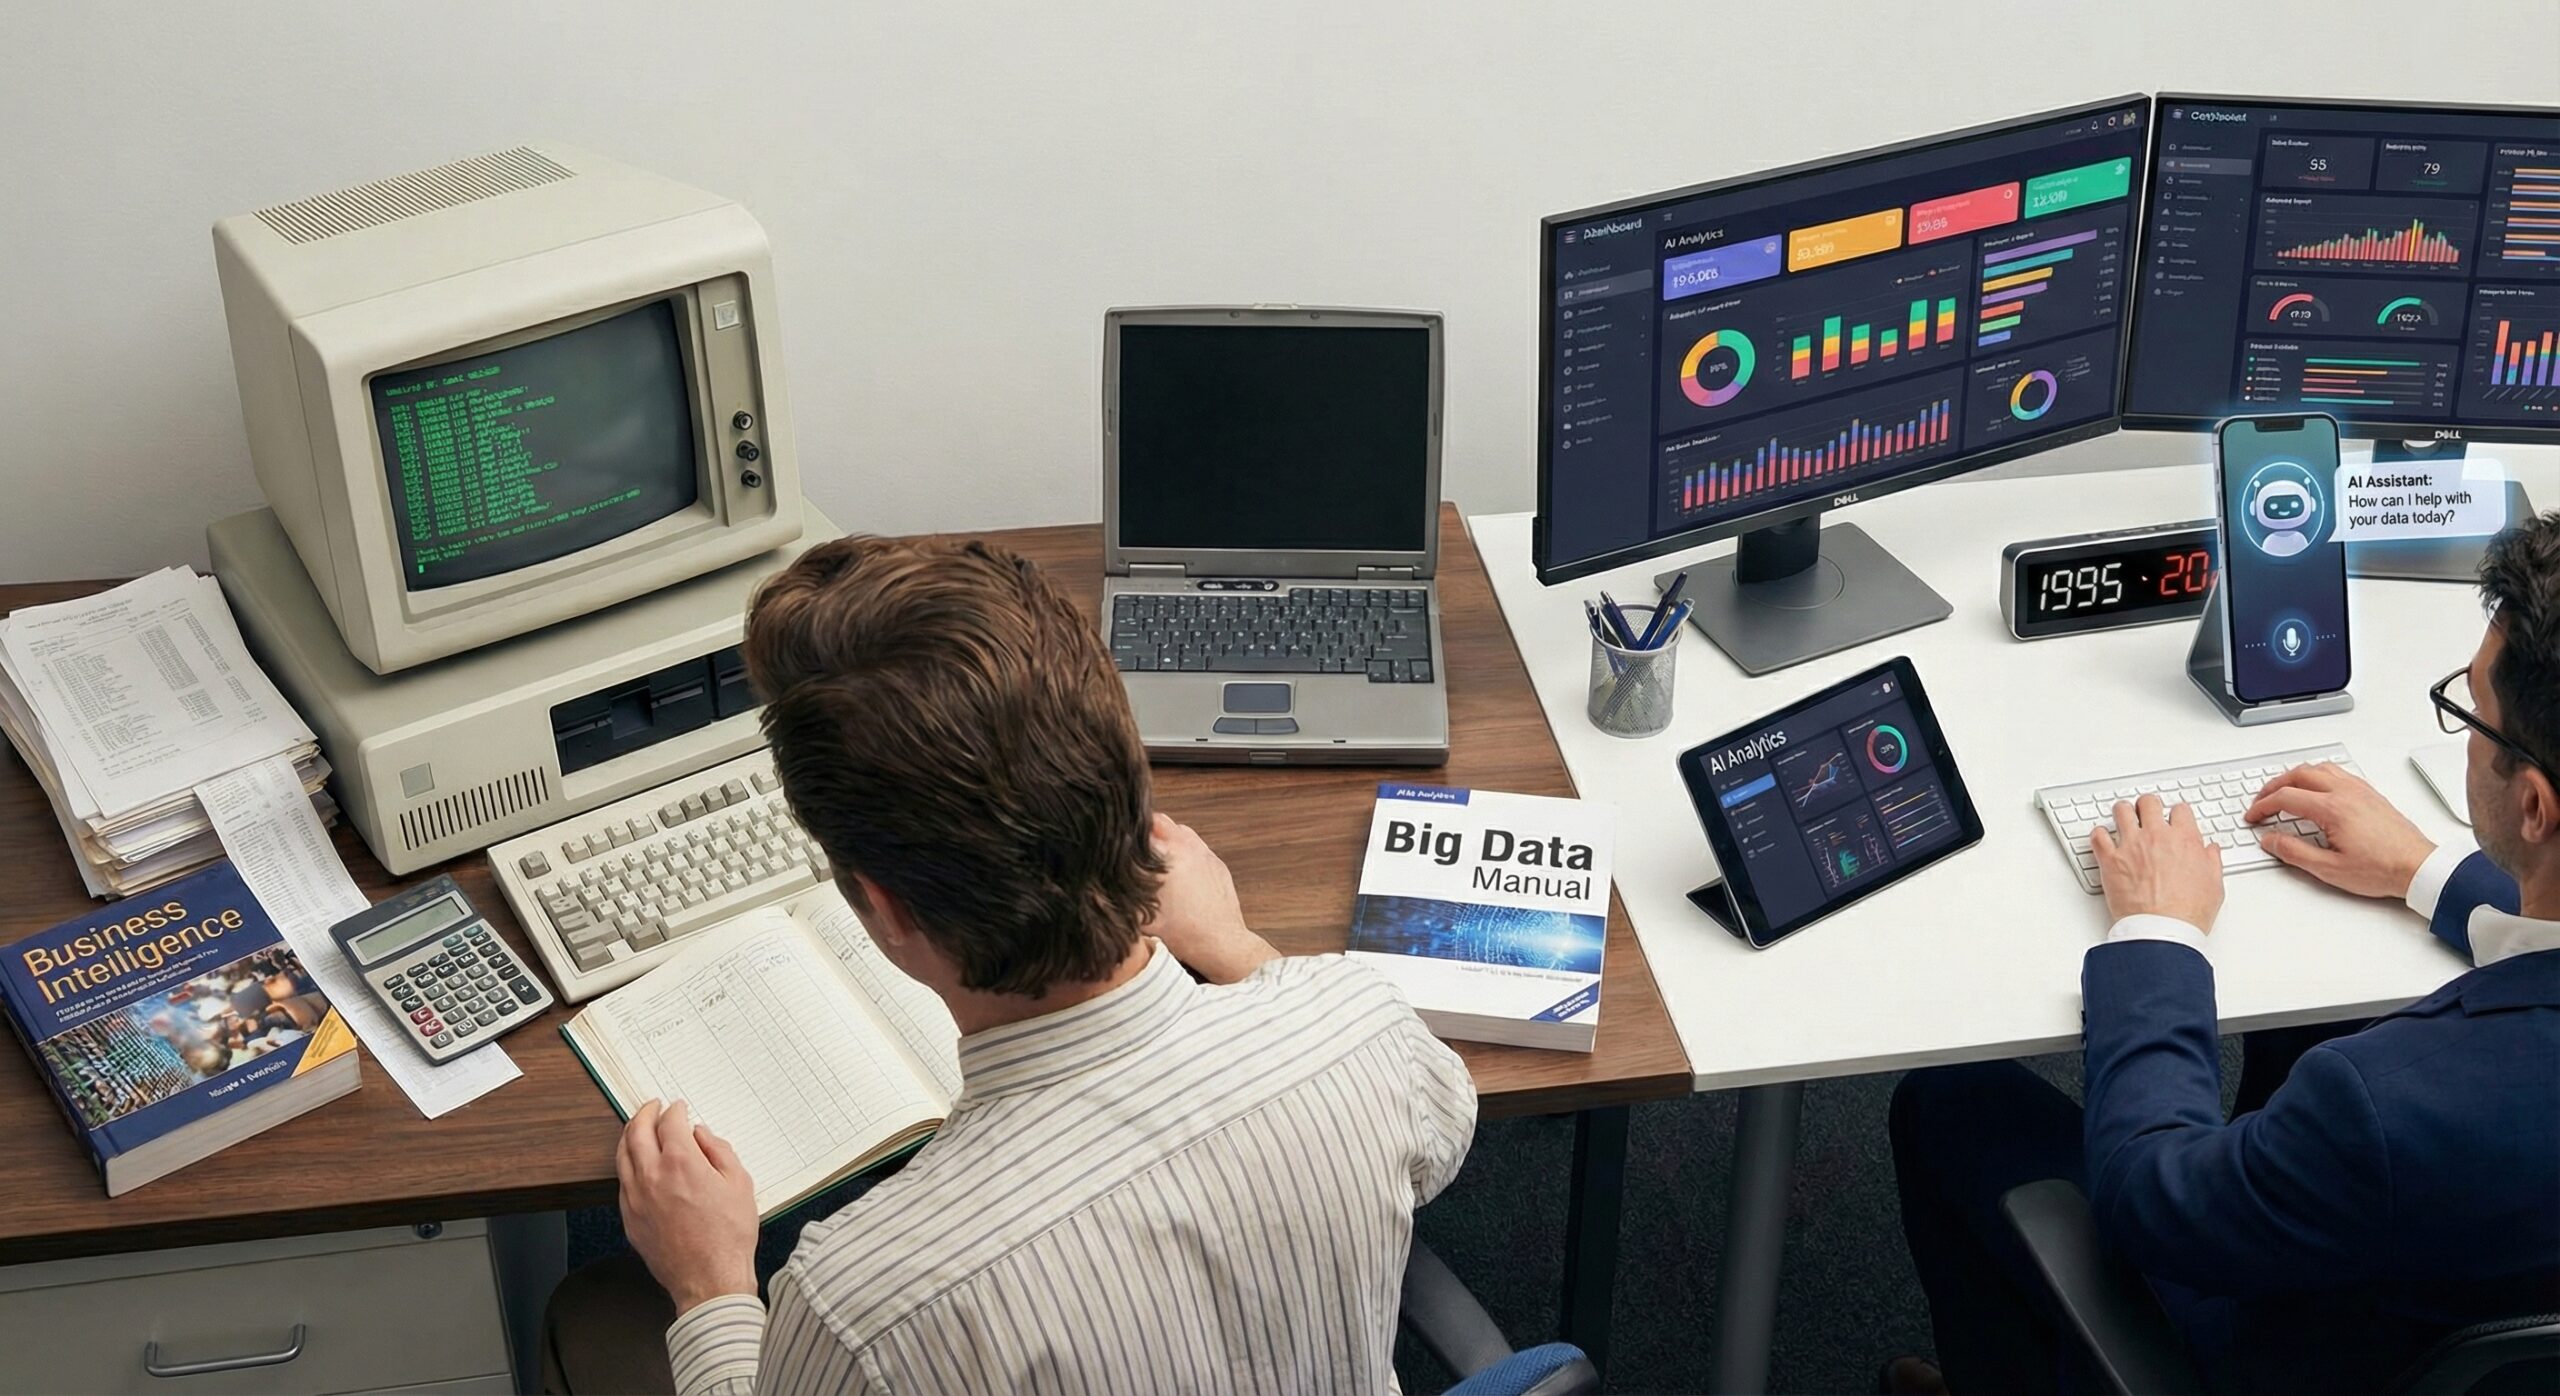
He trabajado en el espacio de Analytics durante más de 20 años. En aquel entonces, no se llamaba “análisis”, sino “Business Intelligence” o incluso “Sistemas de apoyo a la toma de decisiones” en la antigüedad. Los términos cambian, desde almacenes de datos hasta Big Data, pasando por lagos, y ahora con la IA, la esencia y la eterna promesa del análisis de autoservicio sigue siendo la misma: extraer la verdad de los datos para empoderar a los usuarios sin depender de alguien del equipo de datos. ¿IA sin humanos en el circuito? Eso suena controvertido.
Con la llegada de los modelos de lenguajes grandes (LLM), un caso de uso que encuentro fascinante es el desarrollo de interfaces conversacionales para chatear con bases de datos (Text-to-SQL). El potencial aquí es inmenso y promete democratizar el acceso a los datos en todas las organizaciones.
Sin embargo, para este caso de uso específico, la solución debe ser binaria. O funciona o no.
Desafortunadamente, una precisión del 80% o incluso del 90% no es suficiente. Ofrecer a sus usuarios finales una aplicación analítica de IA que alucine tablas o malinterprete los filtros no es una broma. No se puede comprometer la precisión porque inmediatamente erosiona la confianza. ¿Y qué sucede cuando un sistema pierde la confianza? No será utilizado. La adopción disminuirá, sin olvidar el riesgo catastrófico de que las decisiones comerciales se tomen basándose en datos incorrectos.
La complejidad del oleoducto RAG
Comencé mi investigación sobre este tema hace más de un año y medio y rápidamente quedó claro que orquestar una aplicación RAG (generación aumentada de recuperación) de texto a SQL sólida no es trivial. Necesita múltiples componentes en su canalización, trabajando en perfecta armonía:
Un clasificador de intención para detectar el objetivo de la pregunta. Una base de datos vectorial para almacenar contexto adicional (como definiciones comerciales) que necesitan los modelos de lenguaje. Un modelo de incrustaciones para vectorizar este conocimiento adicional. Un mecanismo de recuperación de los datos almacenados. Acceso a la base de datos. La capacidad de generar SQL en el dialecto específico de la base de datos. Y la capacidad de evaluar los resultados.
Creo que esta última parte, la evaluación, a menudo se omite o se trata como una ocurrencia tardía, pero es quizás el componente más crucial para garantizar la confiabilidad necesaria en un entorno empresarial.
BigQuery: un estudio de caso sobre la integración nativa de IA
La gestión de este complejo proceso a menudo requiere la integración de múltiples plataformas. Recientemente me impresionó cómo BigQuery introdujo la fusión de Analytics e IA generativa de forma nativa en su plataforma.
Tiene la capacidad de trabajar con su SQL en BigQuery IDE y usar Gen AI inmediatamente sin tener que ir a otra plataforma o producto. Por ejemplo: puede consultar la base de datos y los resultados recuperados se pueden enviar inmediatamente a Gemini (o a través de Vertex también puede agregar otros modelos). Puedes usar Gemini para clasificar intenciones, crear incrustaciones y almacenarlas en las capacidades de bases de datos vectoriales de BigQuery, realizar una búsqueda semántica y generar SQL.
Todo ello con una sola plataforma, sin la molestia de gestionar múltiples suscripciones.
Eso sí, como todo en la vida, tiene sus inconvenientes.
Una de las principales desventajas es que es posible que BigQuery no sea la base de datos más barata y he escuchado historias de nuevas empresas en las que una sola consulta incorrecta puede agotar su tarjeta de crédito. No me ha pasado a mí, pero puedo entender cómo puede suceder esto. Otra desventaja sería que te quedas completamente atrapado en Google. Quizás eso no sea malo; de la misma manera que todos estamos encerrados en Gmail. Quizás en el futuro la IA sea una mercancía, como lo son ahora los correos electrónicos.
Otro inconveniente es la falta de trazabilidad granular del costo de los tokens y una especie de “LLM simulado” para el desarrollo; realmente no desea utilizar el LLM realmente costoso en su etapa de desarrollo.
Si está de acuerdo con las desventajas anteriores, obtendrá un producto magnífico que combina múltiples herramientas en una única plataforma en la nube que puede manejar big data de forma masiva.
Creé el siguiente repositorio que fue parte del hackathon de Kaggle, donde exploré más a fondo estas capacidades nativas de BigQuery. Para obtener más información, visite el repositorio aquí:
https://github.com/garyzava/bigq-ethereum-rag
La pieza que falta: evaluación rigurosa
Ahora, volvamos a los marcos de evaluación. Plataformas como BigQuery simplifican la arquitectura, pero no resuelven automáticamente el problema de precisión. Veo múltiples soluciones disponibles, pero la mayoría de ellas carecen de capacidades de evaluación sólidas.
Si aceptamos que Text-to-SQL debe ser binario (correcto o incorrecto), necesitamos estrategias de evaluación que reflejen la confusa realidad de los datos empresariales, no los entornos prístinos de los conjuntos de datos académicos o de demostración.
Evaluar un sistema de texto a SQL es muy difícil debido a la naturaleza declarativa de SQL y a lo complejo que es el esquema de su base de datos. ¿Tiene miles de mesas? ¿Están esas tablas bien documentadas? Probablemente no. ¿Las convenciones de nomenclatura son consistentes en todas las tablas? Dos consultas pueden verse completamente diferentes desde el punto de vista sintáctico (por ejemplo, diferentes órdenes de unión, alias o uso de CTE) pero producir resultados idénticos.
Para comparar realmente su aplicación RAG durante el desarrollo y la producción, debe utilizar las métricas correctas.
Métricas que importan
Volviendo a la promesa de BI o análisis de autoservicio, esto significa que el usuario final confía 100% en sí mismo; desafortunadamente, no hay ningún experto en datos o una persona al tanto para validar los resultados. Debido a esto, necesitamos establecer una IA explicable o un marco de evaluación con un conjunto de métricas para medir la calidad del SQL generado.
El cambio hacia la precisión de ejecución (EX): los primeros puntos de referencia se basaban en la coincidencia exacta (EM), que comparaba la cadena SQL predicha con la verdad fundamental. Esto era profundamente defectuoso, ya que penalizaba las variaciones sintácticas válidas. El estándar moderno es la precisión de ejecución (EX). Esta métrica ejecuta tanto el SQL previsto como el SQL “Gold” (verdad fundamental) con la base de datos real y compara los conjuntos de resultados devueltos. Esto valida correctamente las consultas independientemente de cómo estén escritas. Evaluación enfocada: en contextos empresariales, una consulta puede devolver columnas adicionales no esenciales (por ejemplo, una columna de ID utilizada para una unión). Una precisión de ejecución estricta podría marcar esto como un fracaso. La “evaluación enfocada basada en la ejecución” permite una comparación más matizada, verificando si las columnas y valores de destino son correctos, al mismo tiempo que es más indulgente con los datos superfluos o el orden de las filas. La métrica “Soft-F1”: para mitigar la naturaleza binaria de la precisión de ejecución (donde una celda incorrecta falla toda la prueba), Soft-F1 se utiliza cada vez más. Esta métrica proporciona crédito parcial al calcular la superposición entre los resultados previstos y los de oro. Si una consulta devuelve 99 de 100 filas correctas, Soft-F1 refleja un alto rendimiento, mientras que EX devolvería 0. Esto es crucial para la depuración. LLM-as-a-Judge: a veces la ejecución es imposible (por ejemplo, faltan datos privados, errores ambientales). En estos casos, se puede pedir a un LLM avanzado que compare la lógica semántica del SQL previsto con el Gold SQL. Si bien es menos objetivo que la ejecución, se correlaciona altamente con el juicio humano.
Spider 2.0: la verificación de la realidad empresarial
Actualmente existen tres marcos de evaluación notables: Spider 2.0, BIRD (BIg Bench for LaRge-scale Database Grounded Text-to-SQL) y SynSQL (basado en datos sintéticos). Sin embargo, la industria ha estado sufriendo una falsa sensación de seguridad creada por puntos de referencia obsoletos. Durante años, la industria confió en Spider 1.0. Se centró en bases de datos SQLite pequeñas y limpias (con un promedio de menos de 10 tablas). Los modelos lograban una precisión superior al 90%, lo que llevó a muchos a creer que el problema estaba “resuelto”.
El marco que siempre enfatizo, que incorpora estas métricas modernas y realmente prueba la preparación empresarial, es Spider 2.0.
Spider 2.0 (lanzado junto con ICLR 2025) es un cambio de paradigma, diseñado para abordar esta “brecha de realidad” al introducir las complejidades que rompen los LLM en producción:
Escala masiva: los esquemas empresariales son enormes. Las bases de datos Spider 2.0 tienen un promedio de 812 columnas, y algunas superan las 3000. Esta escala a menudo excede los límites de contexto del LLM, lo que obliga a los modelos a emplear estrategias de “enlace de esquemas” (recuperación) solo para identificar las tablas relevantes antes de generar SQL. Diversidad de dialectos: las empresas reales utilizan Snowflake, BigQuery y T-SQL, no solo SQLite. Spider 2.0 impone la diversidad de dialectos, lo que requiere que los modelos dominen una sintaxis específica (por ejemplo, manejar datos JSON anidados usando UNNEST o FLATTEN). Conocimiento externo: la lógica empresarial (como la definición de “tasa de abandono”) reside en la documentación o en las bases de código del proyecto (como DBT), no en el esquema. Spider 2.0 simula esto proporcionando archivos externos (Markdown, YAML) que el modelo debe leer para fundamentar su razonamiento. El flujo de trabajo agente: Fundamentalmente, Spider 2.0 modela el flujo de trabajo de un ingeniero de datos moderno. Va más allá de la traducción estática y evalúa la capacidad del modelo para explorar el sistema de archivos, leer documentación, interactuar con instancias de bases de datos en vivo y depurar errores de forma iterativa.
La diferencia de dificultad es marcada. Los modelos que dominan Spider 1.0 ven sus tasas de éxito caer al 10-20% en el punto de referencia completo de Spider 2.0, lo que resalta las deficiencias de los LLM actuales cuando se enfrentan a la complejidad del mundo real.
Conclusión: la barra binaria para datos empresariales
El viaje desde la inteligencia empresarial a la analítica basada en IA ha estado marcado por una creciente abstracción, pero el requisito fundamental para la integridad de los datos permanece sin cambios. Si bien la promesa de Text-to-SQL está más cerca que nunca, debemos resistir el atractivo de las altas puntuaciones en puntos de referencia obsoletos.
Lograr una precisión del 90% puede ser académicamente interesante, pero en la empresa es industrialmente inútil. La barra es binaria: funciona o rompe la confianza.
A medida que plataformas como BigQuery simplifican la integración de la IA y los datos, es imperativo que adoptemos simultáneamente metodologías de evaluación sofisticadas y puntos de referencia rigurosos como Spider 2.0. Sólo probando la confusa realidad de los datos empresariales podemos desarrollar aplicaciones de texto a SQL lo suficientemente confiables como para apostar por el negocio.
Hasta la próxima, espero que hayas encontrado este tema tan fascinante como a mí.
Lectura adicional
Spider 2.0: Evaluación de modelos de lenguaje en flujos de trabajo empresariales de texto a SQL del mundo real Autores: Fangyu Lei, Jixuan Chen, Yuxiao Ye, et al. Publicado: arXiv (noviembre de 2024), aceptado en ICLR 2025 (oral). Enlace: https://arxiv.org/abs/2411.07763
Ciertamente, como todo lo relacionado con la IA hoy en día, esta conversación no tiene por qué terminar aquí. Me encantaría escuchar sus aportes y perspectivas en www.gyza.org