
ha circulado en el campo de la IA la idea de que la ingeniería rápida está muerta, o al menos obsoleta. Esto, por un lado, porque los modelos de lenguaje puro se han vuelto más flexibles y robustos, tolerando mejor la ambigüedad y, por otro lado, porque los modelos de razonamiento pueden solucionar indicaciones defectuosas y, por lo tanto, comprender mejor al usuario. Cualquiera sea la razón exacta, la era de las “frases mágicas” que funcionaban como encantamientos y trucos de redacción hiperespecíficas parece estar desvaneciéndose. En ese sentido estricto, la ingeniería rápida como una bolsa de trucos (que ha sido analizada científicamente en artículos como este por DeepMind, que reveló semillas rápidas supremas para modelos de lenguaje cuando GPT-4 estuvo disponible) realmente está muriendo.
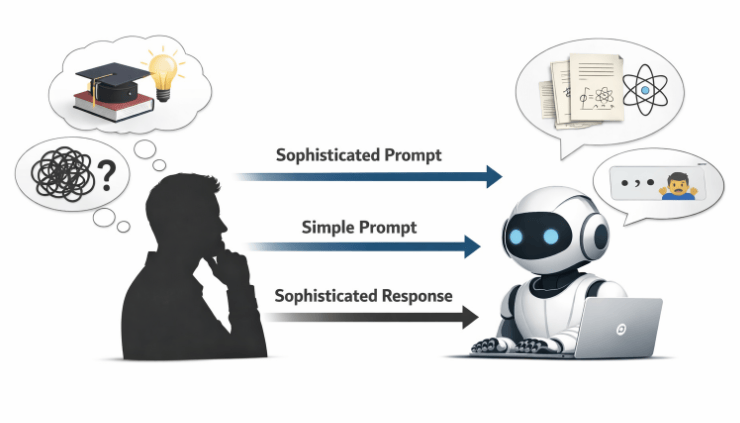
Pero Anthropic ahora ha puesto números detrás de algo más sutil e importante. Descubrieron que, si bien la redacción exacta de una indicación importa menos que antes, la “sofisticación” detrás de la indicación es enormemente importante. De hecho, se correlaciona casi perfectamente con la sofisticación de la respuesta del modelo.
Esto no es una metáfora o un “eslogan” motivacional, sino más bien un resultado empírico obtenido de los datos recopilados por Anthropic a partir de su base de uso. Siga leyendo para saber más, porque todo esto es muy emocionante, más allá de las meras implicaciones sobre cómo utilizamos los sistemas de inteligencia artificial basados en LLM.
Índice Económico Antrópico: Informe enero 2026
En el Índice Económico Antrópico: Informe de enero de 2026, los autores principales Ruth Appel, Maxim Massenkoff y Peter McCrory analizan cómo las personas realmente usan Claude en todas las regiones y contextos. Para comenzar con lo que probablemente sea el hallazgo más sorprendente, observaron una fuerte relación cuantitativa entre el nivel de educación requerido para comprender la indicación de un usuario y el nivel de educación requerido para comprender la respuesta de Claude. Entre países, el coeficiente de correlación es r = 0,925 (p < 0,001, N = 117). En todos los estados de EE. UU., es r = 0,928 (p < 0,001, N = 50).
Esto significa que cuanto más instruido sea y cuanto más claras sean las indicaciones que pueda introducir, mejores serán las respuestas. En términos sencillos, la forma en que los humanos le piden es cómo responde Claude.
¿Y sabes qué? Yo mismo he visto esto cualitativamente al comparar cómo yo y otros colegas de nivel de doctorado interactuamos con los sistemas de inteligencia artificial con cómo lo hacen los usuarios poco instruidos.
De los “trucos rápidos” al “andamio cognitivo”
Las primeras conversaciones sobre ingeniería rápida se centraron en técnicas de nivel superficial: agregar “pensemos paso a paso”, especificar un rol (“actuar como un científico de datos senior”) u ordenar instrucciones cuidadosamente (más ejemplos de esto en el artículo de DeepMind que vinculé en la sección de introducción). Estas técnicas eran útiles cuando los modelos eran frágiles y se descarrilaban fácilmente, lo que, dicho sea de paso, se utilizaba a su vez para sobrescribir sus reglas de seguridad, algo mucho más difícil de lograr ahora.
Pero a medida que los modelos mejoraron, muchos de estos trucos se volvieron opcionales. El mismo modelo a menudo podría llegar a una respuesta razonable incluso sin ellos.
Los hallazgos de Anthropic aclaran por qué esto finalmente llevó a la percepción de que la ingeniería rápida era obsoleta. Resulta que los aspectos “mecánicos” de las indicaciones (sintaxis, palabras mágicas, rituales de formato) en realidad importan menos. Lo que no ha desaparecido es la importancia de lo que llaman “andamio cognitivo”: qué tan bien el usuario entiende el problema, con qué precisión lo encuadra y si sabe cómo es una buena respuesta; en otras palabras, el pensamiento crítico para distinguir las buenas respuestas de las alucinaciones inútiles.
El estudio pone en práctica esta idea utilizando la educación como indicador cuantitativo de la sofisticación. Los investigadores estiman la cantidad de años de educación necesarios para comprender tanto las indicaciones como las respuestas, ¡y encuentran una correlación casi uno a uno! Esto sugiere que Claude no está “mejorando” o “degradando” de forma independiente el nivel intelectual de la interacción. En cambio, refleja notablemente la entrada del usuario. Eso es definitivamente bueno cuando sabes lo que estás preguntando, pero hace que el sistema de inteligencia artificial tenga un rendimiento inferior cuando no sabes mucho al respecto o cuando tal vez escribes una solicitud o pregunta demasiado rápido y sin prestar atención.
Si un usuario proporciona un mensaje superficial y poco especificado, Claude tiende a responder en un nivel igualmente superficial. Si el mensaje codifica un conocimiento profundo del dominio, restricciones bien pensadas y estándares de rigor implícitos, Claude responde de la misma manera. Y claro, sí, ciertamente he visto esto en los modelos ChatGPT y Gemini, que son los que más uso.
¿Por qué esto no es trivial?
A primera vista, esto puede parecer obvio. Por supuesto, las mejores preguntas obtienen mejores respuestas. Pero la magnitud de la correlación es lo que hace que el resultado sea científicamente interesante. Las correlaciones superiores a 0,9 son raras en datos sociales y de comportamiento, especialmente entre unidades heterogéneas como países o estados de EE. UU. Por lo tanto, lo que el trabajo encontró no es una tendencia débil sino una relación bastante estructural.
Fundamentalmente, el hallazgo va en contra de la noción común de que la IA podría funcionar como un ecualizador, al permitir que todos recuperen información de nivel similar, independientemente de su idioma, nivel de educación y conocimiento de un tema. Existe una esperanza generalizada de que los modelos avanzados “eleven” a los usuarios poco cualificados al proporcionar automáticamente resultados de nivel experto independientemente de la calidad de los insumos. Los resultados obtenidos por Anthropic sugieren que este no es el caso en absoluto, y es una realidad mucho más condicional. Si bien Claude (y esto muy probablemente se aplica a todos los modelos de IA conversacionales que existen) puede producir respuestas muy sofisticadas, tiende a hacerlo sólo cuando el usuario proporciona una indicación que lo justifica.
El comportamiento del modelo no es fijo; esta diseñado
Aunque para mí esta parte del informe carece de datos que lo respalden y, desde mi experiencia personal, tendería a no estar de acuerdo, sugiere que este efecto de “espejo” no es una propiedad inherente de todos los modelos lingüísticos, y que la forma en que responde un modelo depende en gran medida de cómo se entrena, afina e instruye. Aunque como digo no estoy de acuerdo, veo que uno podría imaginar un mensaje del sistema que obligue al modelo a usar siempre un lenguaje simplificado, independientemente de la entrada del usuario, o, por el contrario, uno que siempre responda en una prosa altamente técnica. Pero esto habría que diseñarlo.
Claude parece ocupar un término medio más dinámico. En lugar de imponer un registro fijo, adapta su nivel de sofisticación a las indicaciones del usuario. Esta elección de diseño amplifica la importancia de la habilidad del usuario. El modelo es capaz de realizar un razonamiento a nivel de experto, pero trata la indicación como una señal de cuánta capacidad se debe implementar.
Realmente sería fantástico ver a otros grandes actores como OpenAI y Google realizando el mismo tipo de pruebas y análisis de sus datos de uso.
La IA como multiplicador, cuantificada
El “cliché” de que “la IA es un ecualizador” a menudo se repite sin evidencia y, como dije anteriormente, el análisis de Anthropic proporciona exactamente eso… pero de manera negativa.
Si la sofisticación de los resultados aumenta con la sofisticación de los insumos, entonces el modelo no reemplaza la experiencia humana (ni la iguala); sin embargo, lo está multiplicando. Y esto es positivo para los usuarios que aplican el sistema de IA a sus dominios de especialización.
Una base débil multiplicada por una herramienta poderosa sigue siendo débil y, en el mejor de los casos, puedes utilizar consultas con un sistema de inteligencia artificial para iniciarte en un campo, siempre que sepas lo suficiente como para al menos distinguir las alucinaciones de los hechos. Una base sólida, por el contrario, se beneficia enormemente porque entonces se empieza con mucho y se obtiene aún más; Por ejemplo, muy a menudo hago una lluvia de ideas con ChatGPT o mejor con Gemini 3 en el estudio de IA sobre ecuaciones que describen fenómenos físicos, para finalmente obtener fragmentos de código del sistema o incluso aplicaciones completas para, por ejemplo, ajustar datos a modelos matemáticos muy complejos. Sí, podría haberlo hecho, pero al redactar cuidadosamente mis indicaciones para el sistema de inteligencia artificial, podría hacer el trabajo en literalmente órdenes de magnitud menos de tiempo del que yo habría hecho.
Todo este marco podría ayudar a reconciliar dos narrativas aparentemente contradictorias sobre la IA. Por un lado, los modelos son innegablemente impresionantes y pueden superar a los humanos en muchas tareas específicas. Por otra parte, a menudo decepcionan cuando se utilizan de forma ingenua. La diferencia no es principalmente la redacción del mensaje, sino la comprensión del dominio por parte del usuario, la estructura del problema y los criterios para el éxito.
Implicaciones para la educación y el trabajo
Una implicación es que las inversiones en capital humano siguen siendo importantes, y mucho. A medida que los modelos se convierten en mejores espejos de la sofisticación de los usuarios, las disparidades en la experiencia pueden volverse más visibles en lugar de menos, como propone la narrativa de la “igualación”. Quienes puedan formular indicaciones precisas y bien fundamentadas extraerán mucho más valor del mismo modelo subyacente que quienes no puedan.
Esto también reformula lo que debería significar “ingeniería rápida” en el futuro. Se trata menos de aprender una nueva habilidad técnica y más de cultivar las tradicionales: conocimiento del dominio, pensamiento crítico, descomposición de problemas. Saber qué preguntar y cómo reconocer una buena respuesta resulta ser la verdadera interfaz. Probablemente todo esto sea obvio para nosotros, los lectores de Towards Data Science, pero estamos aquí para aprender y lo que Anthropic encontró de manera cuantitativa lo hace todo mucho más convincente.
En particular, para terminar, los datos de Anthropic exponen sus puntos con una claridad inusual. Y nuevamente, deberíamos llamar a todos los grandes actores como OpenAI, Google, Meta, etc. para que realicen análisis similares sobre sus datos de uso y pedirles que presenten los resultados al público tal como lo hizo Anthropic.
Y así como hemos estado luchando durante mucho tiempo por un acceso generalizado y gratuito a los sistemas de inteligencia artificial conversacional, pautas claras para suprimir la información errónea y el uso inadecuado intencional, formas de eliminar idealmente o al menos señalar las alucinaciones, y más, ahora podemos agregar peticiones para lograr una verdadera ecualización.
Referencias y lecturas relacionadas.
Para saber todo sobre el informe de Anthropic (que también aborda muchos otros puntos interesantes y proporciona todos los detalles sobre los datos analizados): https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Y también puede resultarle interesante el “New Future of Work Report 2025” de Microsoft, con el que el estudio de Anthropic hace algunas comparaciones, disponible aquí: https://www.microsoft.com/en-us/research/project/the-new-future-of-work/
Mi publicación anterior “Dos nuevos artículos de DeepMind ejemplifican cómo la inteligencia artificial puede ayudar a la inteligencia humana”: https://pub.towardsai.net/two-new-papers-by-deepmind-exemplify-how-artificial-intelligence-can-help-human-intelligence-ae5143f07d49
Mi publicación anterior “El nuevo trabajo de DeepMind revela semillas rápidas supremas para modelos de lenguaje”: https://medium.com/data-science/new-deepmind-work-unveils-supreme-prompt-seeds-for-language-models-e95fb7f4903c