
es parte de una serie sobre IA distribuida en múltiples GPU:
Introducción
El paralelismo de datos distribuidos (DDP) es el primer método de paralelización que veremos. Es el enfoque básico que siempre se utiliza en entornos de entrenamiento distribuido y comúnmente se combina con otras técnicas de paralelización.
Un repaso rápido de la red neuronal
Entrenar una red neuronal significa ejecutar un pase hacia adelante, calcular la pérdida, propagar hacia atrás los gradientes de cada peso con respecto a la función de pérdida y, finalmente, actualizar los pesos (lo que llamamos un paso de optimización). En PyTorch, normalmente se ve así:
importar antorcha def Training_loop (modelo: torch.nn.Module, cargador de datos: torch.utils.data.DataLoader, optimizador: torch.optim.Optimizer, loss_fn: invocable,): para i, lote en enumerar (cargador de datos): entradas, objetivos = salida por lotes = modelo (entradas) # Pérdida de paso hacia adelante = loss_fn (salida, objetivos) # Calcular pérdida loss.backward() # Atrás pasar (calcular gradientes) optimizador.step() # Actualizar pesos optimizador.zero_grad() # Borrar gradientes para el siguiente paso
Realizar el paso de optimización en grandes cantidades de datos de entrenamiento generalmente proporciona estimaciones de gradiente más precisas, lo que lleva a un entrenamiento más fluido y una convergencia potencialmente más rápida. Entonces, lo ideal sería dar cada paso después de calcular los gradientes en función de todo el conjunto de datos de entrenamiento. En la práctica, esto rara vez es factible en escenarios de aprendizaje profundo, ya que llevaría demasiado tiempo calcularlo. En cambio, trabajamos con partes pequeñas como minilotes y microlotes.
Lote: se refiere al conjunto de entrenamiento completo utilizado para un paso de optimización. Mini lote: se refiere a un pequeño subconjunto de datos de entrenamiento utilizados para un paso de optimización. Microlote: se refiere a un subconjunto del minilote, combinamos múltiples microlotes para un paso de optimización.
Aquí es donde entran en juego la acumulación de gradientes y el paralelismo de datos. Aunque no utilizamos todo el conjunto de datos para cada paso, podemos utilizar estas técnicas para aumentar sustancialmente el tamaño de nuestro mini lote.
Acumulación de gradiente
Así es como funciona: elija un minilote grande que no quepa en la memoria de la GPU, pero luego divídalo en microlotes que sí quepan. Para cada microlote, realice pases hacia adelante y hacia atrás, sumando (acumulando) los gradientes calculados. Una vez que se procesen todos los microlotes, realice un único paso de optimización utilizando los gradientes promediados.
Tenga en cuenta que la acumulación de gradiente no es una técnica de paralelización y no requiere varias GPU.
Implementar la acumulación de gradiente desde cero es sencillo. Así es como se ve en un ciclo de entrenamiento simple:
importar antorcha def Training_loop (modelo: torch.nn.Module, cargador de datos: torch.utils.data.DataLoader, optimizador: torch.optim.Optimizer, loss_fn: invocable, grad_accum_steps: int,): para i, lote en enumerar (cargador de datos): entradas, objetivos = salida por lotes = modelo (entradas) pérdida = loss_fn (salida, objetivos) loss.backward() # Los gradientes se acumulan (suman) # Solo actualiza los pesos después de los microlotes `grad_accum_steps` si (i+1) % grad_accum_steps == 0: # i+1 para evitar un paso en la primera iteración cuando i=0 optimizador.step() optimizador.zero_grad()
Observe que estamos realizando secuencialmente múltiples pases hacia adelante y hacia atrás antes de cada paso de optimización, lo que requiere tiempos de entrenamiento más prolongados. Sería bueno si pudiéramos acelerar esto procesando múltiples microlotes en paralelo… ¡eso es exactamente lo que hace DDP!
Paralelismo de datos distribuidos (DDP)
Para una cantidad bastante pequeña de GPU (hasta ~8), DDP escala casi linealmente, lo cual es óptimo. Eso significa que si duplica la cantidad de GPU, puede reducir casi a la mitad el tiempo de entrenamiento (ya discutimos anteriormente el escalado lineal).
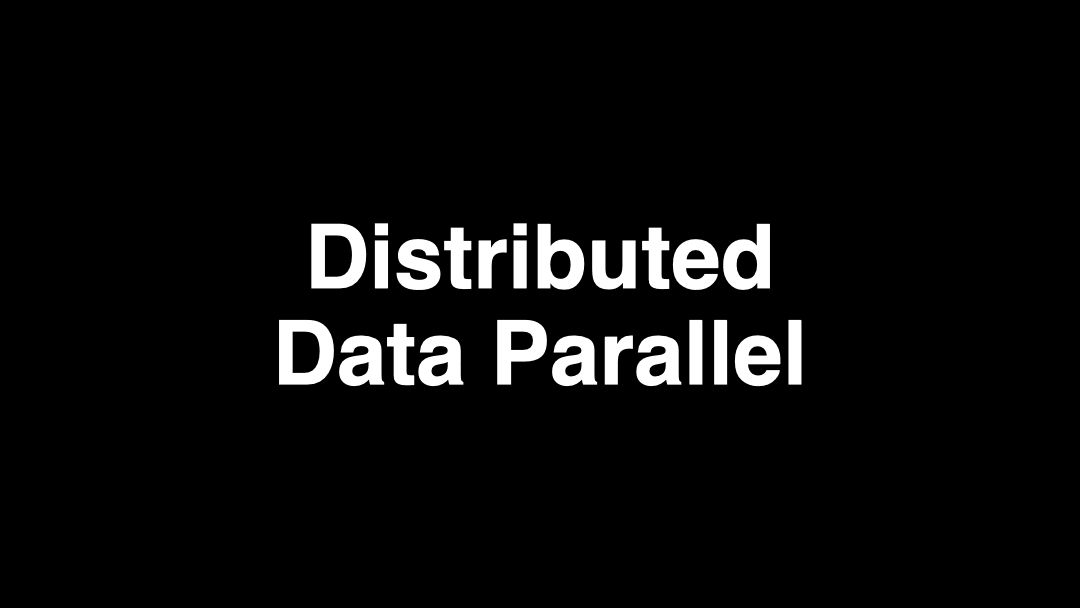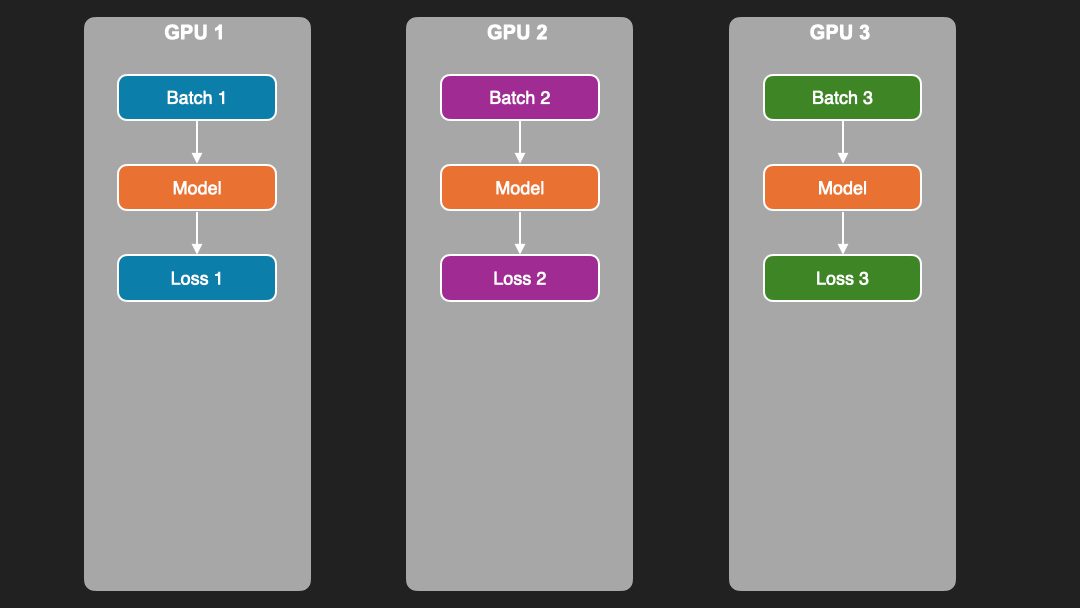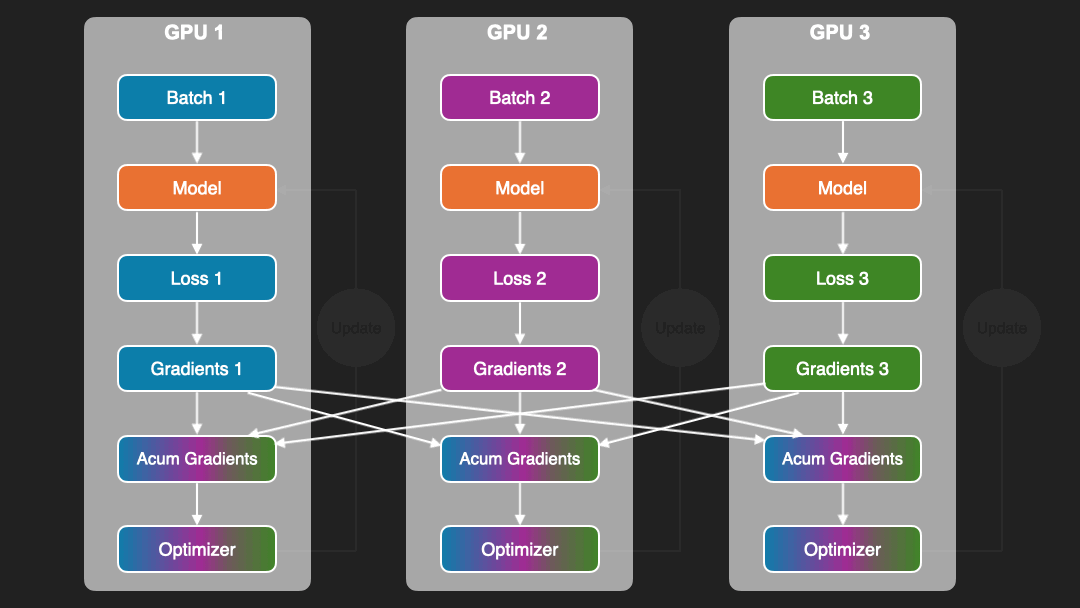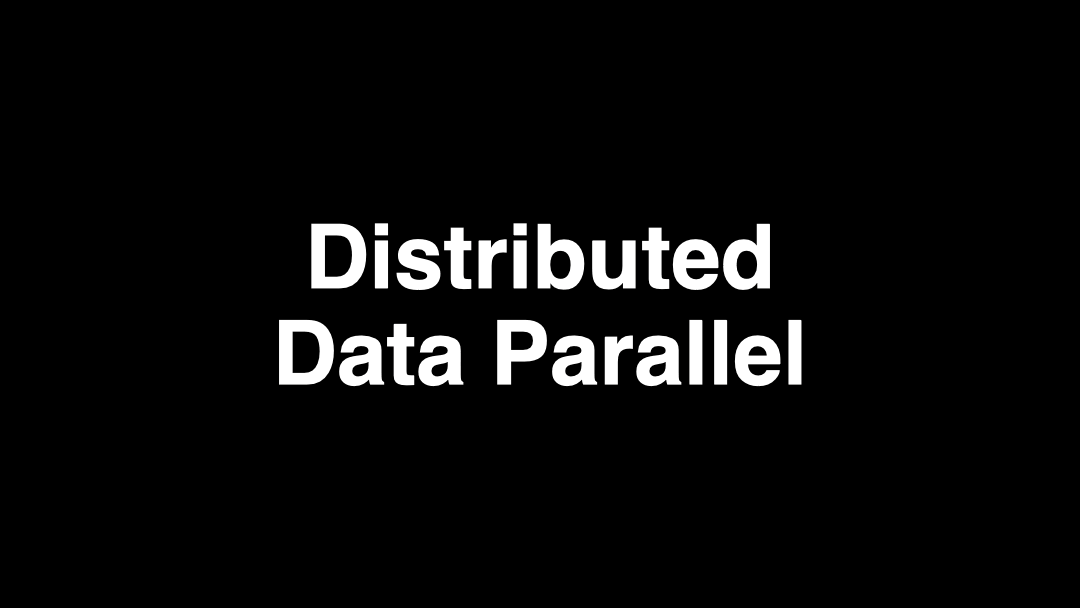
Con DDP, varias GPU trabajan juntas para procesar un minilote efectivo más grande, manejando cada microlote en paralelo. El flujo de trabajo se ve así:
Divida el mini lote entre GPU. Cada GPU ejecuta sus propios pases hacia adelante y hacia atrás para calcular gradientes para su propio fragmento de datos (microlotes). Utilice una operación All-Reduce (la aprendimos anteriormente en Operaciones colectivas) para promediar los gradientes en todas las GPU. Cada GPU aplica las mismas actualizaciones de peso, manteniendo los modelos en perfecta sincronización.
Esto nos permite entrenar con tamaños de mini lotes efectivos mucho más grandes, lo que genera un entrenamiento más estable y una convergencia potencialmente más rápida.

Implementando DDP desde cero en PyTorch
Hagamos esto paso a paso. En esta primera iteración, solo sincronizamos los degradados.
importar clase de antorcha DDPModelWrapper: def __init__(self, model: torch.nn.Module): self.model = model def __call__(self, *args, **kwargs): return self.model(*args, **kwargs) def sync_gradients(self): # Iterar sobre matrices de parámetros en el modelo para param en self.model.parameters(): # Algunos parámetros pueden estar congelados y no tener gradientes si param.grad no es Ninguno: # Sumamos y luego dividimos ya que torch.distributed no tiene una operación promedio torch.distributed.all_reduce(param.grad.data, op=torch.distributed.ReduceOp.SUM) # Suponiendo que cada GPU recibió un mini lote del mismo tamaño, podemos promediar # los gradientes dividiendo por el número de GPU (también conocido como tamaño mundial) # De forma predeterminada, la función de pérdida ya promedia el tamaño del mini lote param.grad.data /= antorcha.distributed.get_world_size()
Antes de comenzar a entrenar, obviamente necesitamos que nuestro modelo sea el mismo en todas las GPU; de lo contrario, estaríamos entrenando modelos diferentes. Mejoremos nuestra implementación verificando que todos los pesos sean idénticos durante la creación de instancias (si no sabe qué son los rangos, consulte la primera publicación de blog de la serie).
importar clase de antorcha DDPModelWrapper: def __init__(self, model: torch.nn.Module): self.model = model for param in self.model.parameters(): # Creamos un nuevo tensor para que pueda recibir la transmisión rank_0_param = param.data.clone() # Inicialmente, rank_0_param contiene los valores para el rango actual torch.distributed.broadcast(rank_0_param, src=0) # Después de que la variable de transmisión rango_0_param se sobrescribe con los parámetros de rango_0 si no es torch.equal(param.data, rango_0_param): # Ahora comparamos rango_x con rango_0 elevar ValueError("Los parámetros del modelo no son los mismos en todos los procesos.") def __call__(self, *args, **kwargs): return self.model(*args, **kwargs) def sync_gradients(self): for param en self.model.parameters(): si param.grad no es Ninguno: torch.distributed.all_reduce(param.grad.data, op=torch.distributed.ReduceOp.SUM) param.grad.data /= torch.distributed.get_world_size()
Combinando DDP con GA
Puede combinar DDP con GA para lograr tamaños de lote efectivos aún mayores. Esto es particularmente útil cuando su modelo es tan grande que solo caben unas pocas muestras por GPU.
El beneficio clave es la reducción de la sobrecarga de comunicación: en lugar de sincronizar gradientes después de cada lote, solo se sincroniza una vez por lotes de grad_accum_steps. Esto significa:
Tamaño de lote efectivo global = num_gpus × micro_batch_size × grad_accum_steps Menos puntos de sincronización = menos tiempo dedicado a la comunicación entre GPU
Un bucle de entrenamiento que utiliza nuestro DDPModelWrapper con acumulación de gradiente se ve así:
def Training_loop (ddp_model: DDPModelWrapper, cargador de datos: torch.utils.data.DataLoader, optimizador: torch.optim.Optimizer, loss_fn: invocable, grad_accum_steps: int,): para i, lote en enumerar (cargador de datos): entradas, objetivos = salida por lotes = ddp_model (entradas) pérdida = loss_fn (salida, objetivos) loss.backward() if (i+1) % grad_accum_steps == 0: # Debe sincronizar los gradientes entre las GPU *ANTES* del paso de optimización ddp_model.sync_gradients() optimizador.step() optimizador.zero_grad()
Consejos profesionales y uso avanzado
Utilice la captura previa de datos. Puede acelerar el entrenamiento cargando el siguiente lote de datos mientras se procesa el actual. DataLoader de PyTorch proporciona un argumento prefetch_factor que controla cuántos lotes buscar previamente en segundo plano. Aprovechar correctamente la captación previa con CUDA puede ser un poco complicado, por lo que lo dejaremos para una publicación futura. No maximices la memoria de la GPU. Contrariamente a la intuición, dejar algo de memoria libre puede conducir a un rendimiento de entrenamiento más rápido. Cuando deja libre al menos ~15% de la memoria de la GPU, la GPU puede administrar mejor la memoria evitando la fragmentación. PyTorch DDP superpone la comunicación con la computación. De forma predeterminada, DDP comunica los gradientes a medida que se calculan durante la retropropagación en lugar de esperar a que finalice el paso hacia atrás completo. Así es como: PyTorch organiza los gradientes del modelo en depósitos de megabytes bucket_cap_mb. Durante el paso hacia atrás, PyTorch marca los gradientes como listos para la reducción a medida que se calculan. Una vez que todos los gradientes en un depósito están listos, DDP inicia una reducción total asincrónica para promediar esos gradientes en todos los rangos. La llamada loss.backward() regresa solo después de que se hayan completado todas las operaciones allreduce, por lo que llamar inmediatamente a opt.step() es seguro. El parámetro bucket_cap_mb crea una compensación: los valores más pequeños desencadenan operaciones allreduce más frecuentes, pero cada lanzamiento del núcleo de comunicación genera cierta sobrecarga que puede afectar el rendimiento. Los valores más grandes reducen la frecuencia de comunicación pero también reducen la superposición; en el extremo, si los cubos son demasiado grandes, estará esperando a que finalice todo el pase hacia atrás antes de comunicarse. El valor óptimo depende de la arquitectura y el hardware de su modelo, por lo que debe crear un perfil con diferentes valores para encontrar el que funcione mejor.
Aquí hay una implementación completa de DDP en PyTorch: """ Inicie con: torchrun –nproc_per_node=NUM_GPUS ddp.py """ import torch import torch.nn as nn import torch.distributed as dist from torch.nn.parallel import DistributedDataParallel as DDP from torch.utils.data import DataLoader, TensorDataset from torch.utils.data.distributed import DistributedSampler de la clase óptima de importación de antorcha ToyModel(nn.Module): def __init__(self): super().__init__() self.net = nn.Sequential( nn.Linear(1024, 1024), nn.ReLU(), nn.Linear(1024, 1024), nn.ReLU(), nn.Linear(1024, 256), ) def forward(self, x): return self.net(x) def train(): dist.init_process_group(backend="nccl") rango = dist.get_rank() torch.cuda.set_device(rank) dispositivo = torch.device(f"cuda:{rank}") # Crear conjunto de datos ficticio x_data = torch.randn(1000, 1024) y_data = torch.randn(1000, 256) dataset = TensorDataset(x_data, y_data) # DistributedSampler garantiza que cada rango obtenga datos diferentes sampler = DistributedSampler(dataset, shuffle=True) dataloader = DataLoader(dataset, batch_size=64, sampler=sampler) model = ToyModel().to(device) # gradient_as_bucket_view: evita una graduación adicional copia del tensor por depósito. ddp_model = DDP( model, device_ids=[rank], bucket_cap_mb=25, gradient_as_bucket_view=True, ) optimizador = optim.AdamW(ddp_model.parameters(), lr=1e-3) loss_fn = nn.MSELoss() para la época en el rango(2): sampler.set_epoch(epoch) # Garantiza una mezcla diferente cada una época para lote_idx, (x, y) en enumerar (cargador de datos): x, y = x.to(dispositivo), y.to(dispositivo) optimizador.zero_grad() salida = ddp_model(x) pérdida = loss_fn(salida, y) # Hacia atrás se superpone automáticamente con allreduce por depósito. # Para cuando esto regrese, todas las operaciones de reducción estarán realizadas. loss.backward() optimizador.step() if rango == 0 y lote_idx % 5 == 0: print(f"epoch {epoch} lote {batch_idx} loss={loss.item():.4f}") dist.destroy_process_group() if __name__ == "__main__": train() Aquí hay una implementación completa de PyTorch que combina DDP con GA: """ Lanzar con: torchrun –nproc_per_node=NUM_GPUS ddp_ga.py """ importar antorcha importar torch.nn como nn importar torch.distributed como dist de torch.nn.parallel importar DistributedDataParallel como DDP de torch.utils.data importar DataLoader, TensorDataset de torch.utils.data.distributed importar DistributedSampler de torch importar optim de contextlib importar clase de contexto nulo ToyModel(nn.Module): def __init__(self): super().__init__() self.net = nn.Sequential( nn.Linear(1024, 1024), nn.ReLU(), nn.Linear(1024, 1024), nn.ReLU(), nn.Linear(1024, 256), ) def forward(self, x): return self.net(x) def train(): dist.init_process_group(backend="nccl") rango = dist.get_rank() torch.cuda.set_device(rank) dispositivo = torch.device(f"cuda:{rank}") # Crear conjunto de datos ficticio x_data = torch.randn(1000, 1024) y_data = torch.randn(1000, 256) dataset = TensorDataset(x_data, y_data) # DistributedSampler garantiza que cada rango obtenga datos diferentes sampler = DistributedSampler(dataset, shuffle=True) dataloader = DataLoader(dataset, batch_size=16, sampler=sampler) model = ToyModel().to(device) ddp_model = DDP( model, device_ids=[rank], bucket_cap_mb=25, gradient_as_bucket_view=True, ) optimizador = optim.AdamW(ddp_model.parameters(), lr=1e-3) loss_fn = nn.MSELoss() ACCUM_STEPS = 4 para la época en el rango(2): sampler.set_epoch(época) # Garantiza una mezcla diferente en cada época optimizador.zero_grad() para lote_idx, (x, y) en enumerar (cargador de datos): x, y = x.to(dispositivo), y.to(dispositivo) is_last_micro_step = (batch_idx + 1) % ACCUM_STEPS == 0 # no_sync() suprime toda la reducción en los pasos de acumulación. # En el último micropaso salimos de no_sync() para que DDP active # el allreduce superpuesto con ese paso hacia atrás. ctx = ddp_model.no_sync() si no es_last_micro_step else nullcontext() con ctx: salida = ddp_model(x) pérdida = loss_fn(salida, y) / ACCUM_STEPS loss.backward() si es_last_micro_step: optimizador.step() optimizador.zero_grad() si rango == 0: print(f"época {época} lote {batch_idx} pérdida={loss.item() * ACCUM_STEPS:.4f}") dist.destroy_process_group() if __name__ == "__main__": tren()
Conclusión
Sígueme en X para obtener más contenido de IA gratuito @l_cesconetto
¡Felicitaciones por llegar hasta el final! En este post aprendiste sobre:
La importancia de los lotes grandes Cómo funciona la acumulación de gradiente y sus limitaciones El flujo de trabajo DDP y sus beneficios Cómo implementar GA y DDP desde cero en PyTorch Cómo combinar GA y DDP
En el próximo artículo, exploraremos ZeRO (Zero Redundancy Optimizer), una técnica más avanzada que se basa en DDP para optimizar aún más el uso de la memoria VRAM.