
Tienen un problema simple: te muestran el pronóstico, pero no te dicen cuándo cambió realmente.
Esto puede parecer trivial. No lo es.
Los sistemas modernos de predicción numérica del tiempo (PNT), como el ECMWF IFS, producen pronósticos notablemente precisos con una resolución de ~9 km, actualizados cada pocas horas. Los datos ya son muy buenos.
El problema no es el pronóstico.
El problema es la atención: saber cuándo un cambio en esos datos es realmente significativo.
No aprendí eso de la ingeniería de software. Lo aprendí años antes, estudiando teoría del caos en el Instituto Balseiro. Fue allí, trabajando a través de sistemas dinámicos, donde encontré por primera vez una idea un poco inquietante:
Un sistema puede ser completamente determinista y aun así ser prácticamente impredecible.
Esa idea se quedó conmigo. Y años más tarde, cuando comencé a construir sistemas de inteligencia artificial, me di cuenta de que muchos de ellos lo ignoraban.
El problema de los deltas “basados en vibraciones”
Cuando comencé a ver cómo los desarrolladores creaban agentes meteorológicos, noté un patrón:
Obtenga datos de pronóstico Introdúzcalos en un LLM Pregunte: “¿Cambió significativamente el clima?”
A primera vista esto parece razonable. Desde una perspectiva física, es problemático (al menos para problemas en los que el límite de decisión ya está bien definido) porque reemplaza un umbral bien definido con una interpretación probabilística.
En un sistema caótico, la importancia no es un juicio lingüístico: es un umbral definido en función de variables como la temperatura, las precipitaciones o la velocidad del viento. Depende de magnitudes, contexto y horizontes temporales.
Un LLM es un proceso estocástico. Es muy bueno generando lenguaje, pero no está diseñado para imponer límites deterministas en sistemas físicos.
Cuando le pregunta a un LLM si un pronóstico “cambió significativamente”, le está pidiendo a un modelo probabilístico que se aproxime a una regla determinista que podría haber definido explícitamente. Eso introduce variabilidad exactamente donde se desea coherencia.
Los modos de falla son sutiles:
Tendencias que se infieren a partir de frases más que de datos Decisiones inconsistentes entre insumos similares Resultados que no pueden probarse ni reproducirse
En muchas aplicaciones, eso podría ser aceptable. En la agricultura, la energía y la logística, donde una caída de 3°C es una transición de fase para un cultivo, un aumento no lineal en la demanda de energía o una interrupción operativa, no lo es. Estas decisiones deben ser estables y explicables.
Lo que me llevó a una regla simple:
Si puede escribir una declaración de afirmación, probablemente no debería utilizar un mensaje.
Mi camino hacia este problema.
Mi carrera se ha parecido menos a una línea recta y más a una trayectoria en el espacio de fases. Un doctorado Marie Curie en dinámica climática, cinco años dirigiendo I+D en el instituto nacional de meteorología de Uruguay (prevención de incendios forestales, pronóstico estacional, adaptación climática) y luego un cambio a producción ML en Microsoft y Mercado Libre.
Ese arco me dio algo específico: ya entendí la física de los datos, los horizontes de habilidades de los modelos y lo que realmente significa “cambio significativo” en un sistema físico. No como una abstracción de software, sino como un delta mensurable en una variable con límites de incertidumbre conocidos.
Cuando comencé a construir sistemas de IA, el instinto fue inmediato: se trata de un problema de umbral. Los umbrales pertenecen al código, no a las indicaciones.
Skygent es una expresión de esa perspectiva: un agente diseñado no para mostrar pronósticos, sino para detectar cambios significativos en ellos.
El sistema se ejecuta continuamente con datos de pronóstico reales para eventos definidos por el usuario, evalúa los cambios cada pocas horas y solo activa alertas cuando se cumplen las condiciones predefinidas. En la práctica, la mayoría de los ciclos de evaluación no generan ninguna alerta: sólo una pequeña fracción de los cambios cruza el umbral de significancia. Ese es el punto: señal, no ruido.
la arquitectura
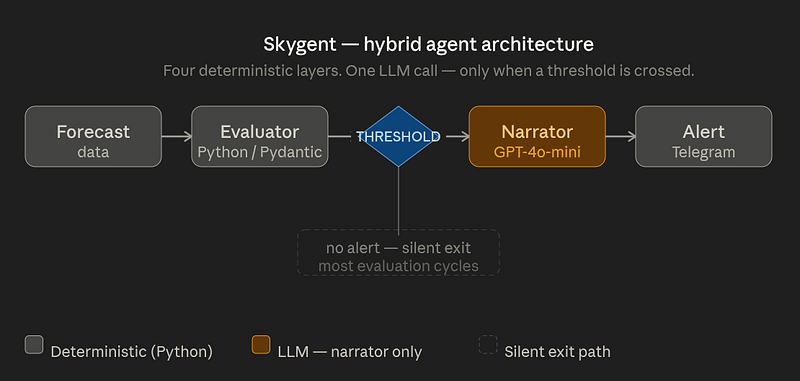
Skygent sigue una separación limpia en cinco capas:
Solo una capa llama al LLM.
El guardián determinista
En el núcleo hay un evaluador de Python. No interpreta, calcula. Él:
Compara instantáneas de pronóstico consecutivas validadas por Pydantic Evalúa deltas contra umbrales configurables Incorpora contexto: tipo de evento, sensibilidad variable Tiene en cuenta el horizonte de pronóstico usando límites de habilidad de NWP establecidos: un cambio en un pronóstico de 24 horas no conlleva la misma confiabilidad que un cambio en un pronóstico de 10 días
Aquí es donde se toman las decisiones. Cada alerta tiene una ruta rastreable: qué variable cambió, en qué medida, qué umbral se cruzó. En un entorno corporativo o gubernamental, poder explicar por qué se disparó una alerta, sin decir “el modelo tenía ganas de hacerlo”, no es opcional.
El gatillo
Una alerta se activa sólo si se cruza un umbral. Si el delta no cruza el límite, no pasa nada. Esta es una condición binaria y comprobable, no una cuestión de criterio.
El Narrador
Sólo después de que se toma la decisión el LLM ingresa al proceso. Su función es estrictamente limitada: tomar datos JSON estructurados y traducirlos al lenguaje natural.
# Carga útil estructurada enviada a GPT-4o-mini { “event_name”: “Ana’s Wedding”, “variable”: “precipitation_probability_max”, “from_value”: 10.0, “to_value”: 50.0, “delta”: 40.0, “horizon_days”: 5.2, “confidence”: “medium” }
Producción:
“La probabilidad de lluvia aumentó del 10% al 50% para su ventana de evento. La confianza es media debido al horizonte de pronóstico de 5 días”.
El LLM no está decidiendo nada. Está explicando.
Por qué esta arquitectura es comprobable
Es prácticamente imposible alcanzar una cobertura de prueba del 100% con un agente LLM puro; no se pueden escribir afirmaciones deterministas sobre resultados probabilísticos.
El enfoque híbrido cambia esto. La lógica de decisión es Python puro con entradas validadas por Pydantic: 204 pruebas unitarias, cero dependencias de LLM en el conjunto de pruebas. El LLM solo maneja el tono narrativo, lo único que realmente se beneficia de la generación del lenguaje natural.
Esto no es sólo una conveniencia de prueba. Significa que cada decisión
Las marcas del sistema se pueden explicar, reproducir y verificar independientemente del LLM.
Invocación de LLM basada en eventos
Un agente ingenuo llama al LLM en cada ciclo de votación. Éste no lo hace.
Skygent evalúa cada 6 horas. Solo llama al modelo cuando se cruza un umbral: aproximadamente una o dos veces por semana por evento monitoreado, en comparación con ~28 llamadas de un agente encuestador ingenuo.
Al precio de gpt-4o-mini (~$0,0001 por narrativa), el costo es insignificante. Más importante aún, el costo es proporcional a la información real: usted paga por una llamada de LLM solo cuando sucede algo que vale la pena comunicar.
Un ejemplo concreto
Instantánea anterior: Probabilidad de lluvia 10%, Temperatura máxima 22°C, Viento 15 km/h
Instantánea actual: probabilidad de lluvia 50%, temperatura máxima 21,4°C, viento 18 km/h
Umbral: Alerta si probabilidad de lluvia Δ > 20pp
Frecuencia de evaluación: Cada 6 horas
Resultado: Alerta activada → GPT-4o-mini genera narrativa → Entrega de telegrama

Cuando este patrón se rompe
Este enfoque no se aplica en todas partes. Se descompone cuando:
Las entradas no están estructuradas o son ambiguas. Los límites de las decisiones no pueden codificarse como umbrales. El razonamiento es abierto.
En esos casos, las arquitecturas LLM first (ReAct, Plan-and-Execute) tienen más sentido.
Una advertencia honesta: los umbrales en Skygent son valores predeterminados configurables: puntos de partida razonables informados por la práctica meteorológica, pero no calibrados contra errores de pronóstico históricos para casos de uso específicos. La calibración con resultados reales es el siguiente paso natural para cualquier implementación vertical. El patrón es sólido; Los parámetros son un punto de partida.
Cierre
La decisión más importante que tomé al construir este sistema no fue elegir un modelo o un marco.
Fue decidir dónde no utilizar un LLM.
Actualmente existe una tendencia a delegar cada vez más en modelos lingüísticos, a dejarles resolver las cosas. Pero algunos problemas ya tienen estructura. Algunas decisiones ya tienen límites.
Cuando lo hacen, aproximarse a ellos con el lenguaje es un paso en falso. Codificarlos explícitamente es mejor.
En la práctica, esto a menudo se reduce a una simple distinción: utilizar los LLM para explicar decisiones, no para reemplazar decisiones bien definidas.
La implementación completa (evaluador de importancia, canalización LangGraph, bot Telegram) está disponible en: github.com/ferariz/skygent
Fernando Arizmendi construye sistemas de producción de IA en la intersección del método científico riguroso y la ingeniería de IA aplicada. Es físico (licenciatura y maestría) del Instituto Balseiro, ex becario Marie Curie (doctorado en dinámica climática y sistemas complejos) y anteriormente dirigió I+D en el instituto nacional de meteorología de Uruguay.
LinkedIn · GitHub
Todas las imágenes del autor. Diagrama de tubería generado con Claude (Anthropic).