
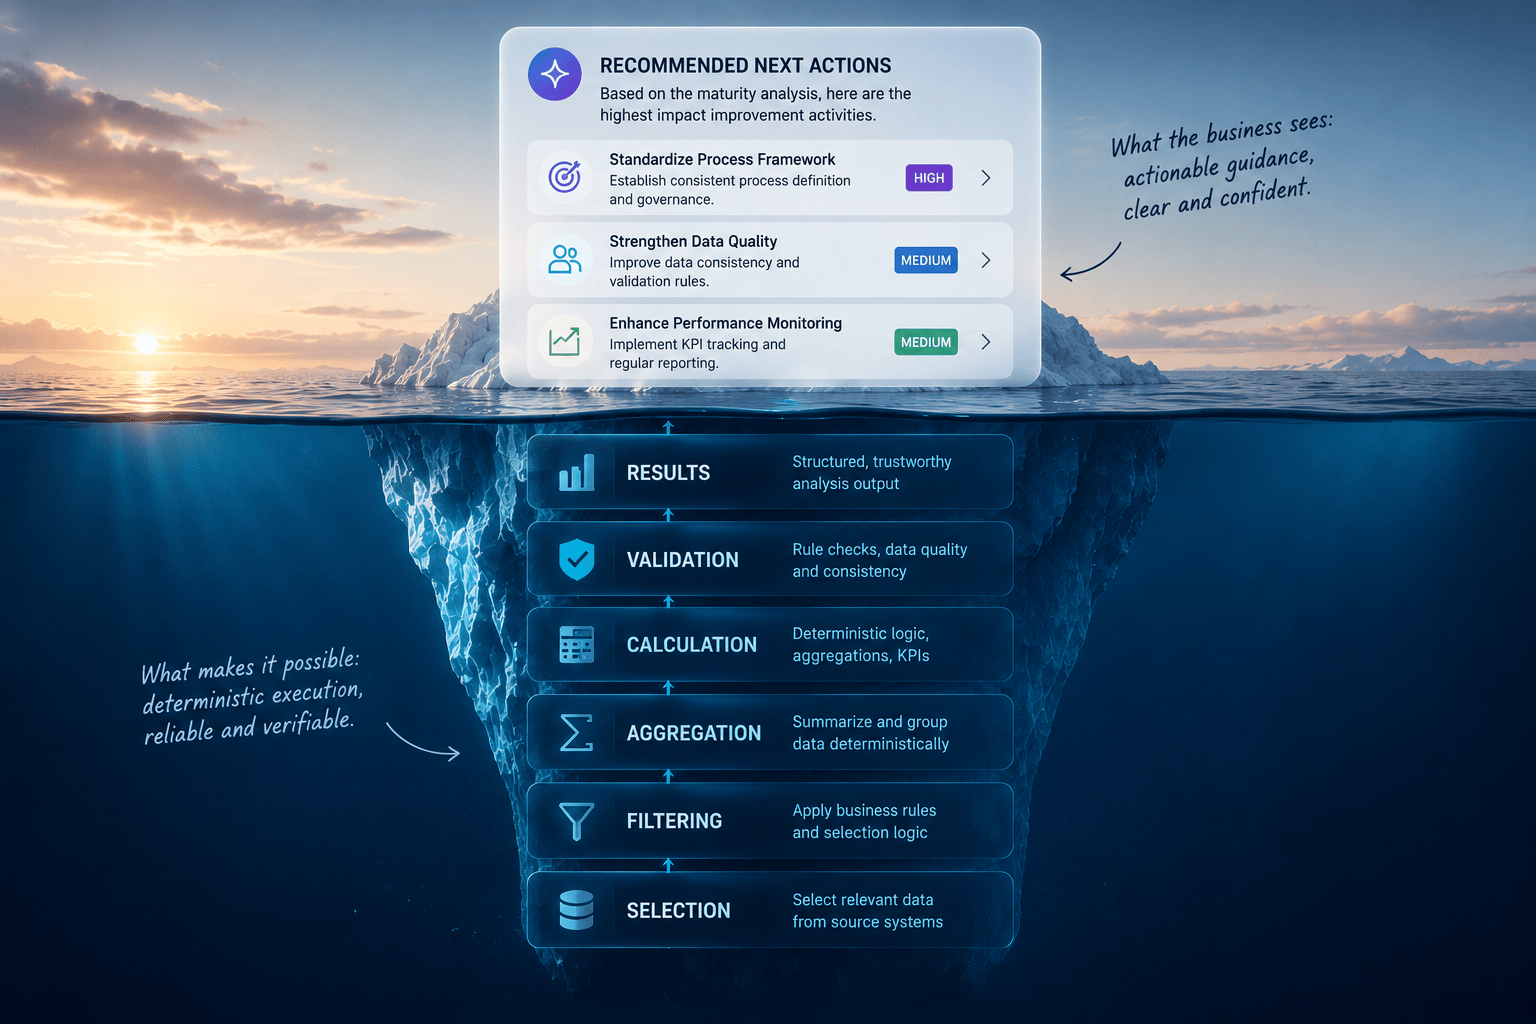
Introducción
una red de inteligencia artificial para mi empresa que asesora a las plantas de fabricación sobre cómo madurar sus operaciones. El sistema fue diseñado para basarse en datos, lo que permite a los usuarios cargar datos de evaluación directamente a través de la interfaz de chat. El primer prototipo funcional se terminó sorprendentemente rápido y, a primera vista, los resultados parecían prometedores.
Sólo había un problema: ¡la mayoría de los resultados eran incorrectos!
Peor aún, la IA aprendió rápidamente qué rangos numéricos parecían plausibles y comenzó a generar resultados convincentes, pero inventados. Combinados con la generación de lenguaje elocuente del LLM, estos resultados podrían confundirse fácilmente con la verdad. Y este comportamiento no se limitó a un único modelo. Aparecieron patrones similares en todos los sistemas probados: ChatGPT, Gemini Enterprise, DIA Brain y Microsoft Copilot.
Pero los datos plausibles no son suficientes: ¡los sistemas de IA empresarial requieren datos confiables!
Investigaciones adicionales revelaron modos de falla recurrentes. Incluso con el “Intérprete de código” habilitado, los sistemas:
omitió filas o columnas, aplicó filtros incorrectos, arrojó resultados idénticos para diferentes entradas, mezcló silenciosamente partes del conjunto de datos o simplemente colapsó en tareas analíticas más complejas.
Esto llevó a una conclusión crucial:
El razonamiento probabilístico es extremadamente poderoso para la interpretación y la interacción, pero el análisis de datos fundamentales requiere una ejecución determinista.
Tabla de contenido
1 El caso de uso
2 La arquitectura híbrida
3 El planificador de análisis
4 El motor de análisis
5 Un ejemplo de un extremo a otro
6 Por qué es importante la arquitectura de IA
1 El caso de uso
Aunque el caso de uso específico es de importancia secundaria, aquí se describe brevemente para respaldar la comprensión práctica del desafío arquitectónico subyacente.
La tarea principal de nuestro agente es asesorar a las plantas de fabricación y los flujos de valor sobre cómo mejorar su madurez operativa: optimizando procesos, mejorando la productividad, reduciendo los niveles de inventario y, en última instancia, reduciendo los costos operativos. Para lograrlo, el agente de consulta opera de dos modos:
Proporciona recomendaciones genéricas para mejorar temas operativos específicos basados en la recuperación de documentación especializada y cuestionarios de evaluación. El agente está destinado a analizar la situación actual de una planta o flujo de valor basándose en los resultados de la evaluación y las recomendaciones escritas de los evaluadores. Con base en este análisis, se espera proporcionar recomendaciones muy específicas para los próximos pasos de mejora.
En ambos modos, como ocurre con la mayoría de los modelos de IA basados en LLM, el usuario puede discutir de forma interactiva ideas y recomendaciones con el agente para derivar el plan de acción más adecuado.
Para el segundo modo de operación, es esencial que el agente pueda procesar y analizar de manera confiable los datos de evaluación. En nuestro caso, estos datos se proporcionan como una exportación de Excel desde una base de datos central. Idealmente, el agente debería poder procesar el archivo sin ninguna preparación manual previa.
La estructura del archivo, sin embargo, es un desafío. Dado que todos los resultados de la evaluación, los cálculos intermedios, los metadatos y las preguntas de evaluación detalladas se almacenan en columnas separadas, la hoja de trabajo contiene más de 800 columnas. El número de filas corresponde al número de evaluaciones de la base de datos y puede oscilar entre uno y varios cientos (Fig. 1). Las calificaciones de las evaluaciones se representan como números enteros del 0 al 4. Además, el archivo contiene más de 160 campos de texto libre con observaciones cualitativas, fortalezas, debilidades y recomendaciones de los evaluadores.
Las tareas analíticas del agente incluyen filtrar filas y columnas relevantes para una solicitud específica, calcular promedios, agregar puntuaciones de madurez, resumir recomendaciones textuales y derivar sugerencias de mejora significativas a partir de los resultados.
Inicialmente, estas tareas parecían estar dentro de las capacidades de los sistemas de inteligencia artificial modernos basados en LLM, especialmente con el modo "Intérprete de código" habilitado. Como ya se mencionó en la introducción, esta suposición rápidamente resultó ser una idea errónea.
2 La arquitectura híbrida
La idea central para superar el desafío analítico fue separar claramente el análisis de datos determinista del razonamiento y la interpretación basados en LLM. La Fig. 2 muestra la arquitectura del sistema seleccionada después de varias iteraciones de mejora. El sistema se implementó en Microsoft Copilot Studio porque la plataforma permite combinar elementos deterministas del flujo de trabajo, como temas y flujos, con componentes de razonamiento basados en LLM.

El agente principal maneja todas las comunicaciones con el usuario. Orquesta los subagentes y el módulo de análisis, les delega tareas, recibe sus respuestas y redacta la respuesta final.
Los subagentes son módulos especializados basados en LLM con acceso a fuentes de conocimiento específicas. Estos incluyen descripciones de las expectativas del nivel de madurez para los flujos de valor, cuestionarios con preguntas de evaluación detalladas y pautas más generales para la excelencia operativa. Los subagentes son llamados por el agente principal de acuerdo con sus capacidades específicas y responden al agente principal en lugar de hacerlo directamente al usuario.
El módulo de análisis es el foco principal de este artículo. Realiza el análisis de datos determinista y está diseñado para proporcionar resultados analíticos reproducibles y confiables. Recibe una instrucción de análisis en lenguaje natural del agente principal, denominada Parent_Instruction. El módulo de análisis en sí consta de temas, flujos y módulos de IA, que se denominan "indicaciones" en Copilot Studio.
El tema T_receive_Excel_File maneja la carga y el almacenamiento de archivos de evaluación. Se activa cuando se carga un archivo en la ventana de chat, indicado por la variable System.Activity.Attachments que tiene un valor. El tema comprueba si el archivo cargado es un archivo de Excel y, de ser así, lo almacena en la variable global Assessment_File.
El agente principal llama activamente al tema T_analyze_assessments si tiene una tarea de análisis que realizar y recibe Parent_Instruction como entrada. Una segunda entrada son los datos de evaluación almacenados en la variable global Assessment_File. El tema contiene los dos componentes analíticos principales: Analysis_Planner y Analysis_Engine. Ambos están integrados en flujos agentes, F_Call_Analysis_Planner y F_Call_Analysis_Engine. Estos flujos sirven como conectores entre el tema T_analyze_assessments y los mensajes de IA P_Analysis_Planner y P_Analysis_Engine.
F_Call_Analysis_Planner recibe solo una entrada, Parent_Instruction, y la reenvía a P_Analysis_Planner. Este componente genera Selection_Rule, la instrucción de análisis principal que ejecutará P_Analysis_Engine. El funcionamiento interno de P_Analysis_Planner se analiza en el Capítulo 3.
F_Call_Analysis_Engine recibe tres entradas: Selection_Rule de Analysis_Planner, un Mapping_File proporcionado desde SharePoint y Assessment_File. Las tres entradas se reenvían al indicador de IA P_Analysis_Engine, que realiza el análisis de datos según lo especificado por Analysis_Planner. El P_Analysis_Engine se analiza en detalle en el Capítulo 4.
3 El planificador de análisis
P_Analysis_Planner es la parte inteligente del proceso de análisis de datos y genera la instrucción de análisis, llamada Selection_Rule. Esta instrucción es una traducción del lenguaje natural Parent_Instruction y generalmente es única para cada solicitud. Para minimizar la variación probabilística, el proceso de traducción está restringido por reglas estrictas.
El Analysis_Planner no analiza los datos de evaluación en sí. Su única responsabilidad es traducir la Parent_Instruction probabilística en una especificación de análisis determinista.
A continuación, examinaremos con más detalle partes seleccionadas de la instrucción. Puedes descargar las instrucciones completas aquí.
Usted es Analysis_Planner, un asistente experto para traducir solicitudes de análisis de evaluación en lenguaje natural en reglas de selección estructuradas. Su tarea es crear un objeto JSON Selection_Rule para Analysis_Engine. Solo recibe una entrada: 1. Parent_Instruction: una solicitud de análisis de lenguaje natural del agente principal (orquestador). Debe analizar Parent_Instruction y determinar: – qué tipo de análisis se requiere, – qué categorías de contenido de la evaluación son relevantes, – si se solicita madurez/hallazgos de concepto o ejecución, – si se solicitan capítulos específicos, – y si se requieren filtros de filas. La regla de selección que genere será utilizada posteriormente por el motor de análisis junto con: – el archivo de datos de evaluación real, – y el archivo de mapeo para ejecutar el análisis de manera determinista.
El cuadro de código de arriba muestra la instrucción inicial para P_Analysis_Planner. Define claramente el propósito y el alcance y separa explícitamente la planificación de la ejecución. El planificador traduce la solicitud, mientras que la ejecución real se delega a P_Analysis_Engine.
A continuación sigue una sección más larga que describe la semántica de los datos de evaluación. Por supuesto, esta parte es muy específica del caso de uso individual y del conjunto de datos. Define categorías semánticas utilizadas para el filtrado de filas y categorías utilizadas para seleccionar los objetivos de análisis reales (CATEGORÍAS DE CONTENIDO OBJETIVO y ATRIBUTOS DE SELECCIÓN DE OBJETIVO).
SEMÁNTICA DE LOS DATOS DE EVALUACIÓN Los datos de evaluación se pueden abordar a través de las siguientes categorías semánticas. CATEGORÍAS DE FILTROS DE FILAS Utilice estas categorías sólo para filtros_filas: – VS_Nr: Identificador único del flujo de valor. Utilícelo al filtrar por número de flujo de valor. – Value Stream: Nombre del flujo de valor. Úselo al filtrar por nombre de flujo de valor. – … CATEGORÍAS DE CONTENIDO OBJETIVO Utilice estas categorías solo en target_selection_rules.data_category: – Chapter_score: puntuación de madurez numérica. Úselo para cálculos de vencimiento, análisis de puntaje y análisis de vencimiento promedio. – fortaleza: declaraciones del evaluador que describen las fortalezas. – … ATRIBUTOS DE SELECCIÓN DE OBJETIVO Utilice estos atributos sólo dentro de target_selection_rules: – data_category: Define qué categoría de contenido de destino se necesita. – agregación_permitida: Uso: – media para promedios de madurez numéricos – resumen para resúmenes textuales – …
El planificador nunca interactúa directamente con las columnas del conjunto de datos físicos. En cambio, opera sobre una capa de abstracción semántica que desacopla el lenguaje natural de la estructura del conjunto de datos subyacente.
Esta separación es importante porque el conjunto de datos de evaluación contiene más de 800 columnas, que incluyen:
calificaciones de madurez, hallazgos textuales del evaluador, metadatos, mapeos organizacionales, variantes de cuestionarios y distinciones concepto/ejecución.
Por lo tanto, seleccionar las columnas de destino correctas se convierte en una parte crítica del proceso de análisis.
Restringir los tipos de análisis permitidos es igualmente importante. Se impide intencionalmente al planificador que invente operaciones analíticas arbitrarias. Por lo tanto, la sección TIPOS DE ANÁLISIS define los únicos tipos de análisis válidos (actualmente solo dos). Esto mejora significativamente la previsibilidad y solidez de la ejecución posterior. Por supuesto, la lista se puede ampliar fácilmente para casos de uso individuales.
TIPOS DE ANÁLISIS Utilice exactamente uno de estos valores de tipo de análisis: – numeric_mean Utilice para: – madurez promedio – madurez media – … – text_summary Utilice para: – fortalezas – potenciales de mejora – …
La siguiente sección define cómo el planificador selecciona las columnas objetivo relevantes de forma abstracta y determinista. Las reglas distinguen entre los dos tipos de análisis predefinidos numeric_mean y text_summary y finalmente determinan qué columnas del conjunto de datos se seleccionan para una solicitud específica.
REGLAS PARA target_selection_rules ANÁLISIS DE MADUREZ NUMÉRICO Para análisis de madurez numérico: – tipo_análisis debe ser: "numeric_mean" – categoría_datos debe ser: ["chapter_score"] – … ANÁLISIS DE RESUMEN DE TEXTO Para análisis de resumen textual: – tipo_análisis debe ser: "text_summary" – categoría_datos: incluye sólo las categorías solicitadas: – "fuerza" – "potencial" – "recomendación" – "observación" – …
Se aplica una lógica similar al proceso de filtrado de filas.
REGLAS PARA row_filters Utilice row_filters solo para filtrar filas en el conjunto de datos de evaluación. Las claves de filtro de filas permitidas son: – VS_Nr – Flujo de valor – … NO utilice filtros_filas para: – id_capítulo – … Estos pertenecen únicamente a target_selection_rules.
Finalmente, la instrucción define la estructura de salida requerida junto con varias "reglas de no hacer" estrictas. Esta sección es particularmente importante porque la salida generada se envía directamente a P_Analysis_Engine y, por lo tanto, debe seguir una estructura claramente definida y legible por máquina.
FORMATO DE SALIDA Devuelve solo JSON válido. No devolver rebajas. No devuelva código Python. … Utilice exactamente esta estructura: { "status": "success", "parent_instruction_summary": "", "selection_rule": { "analysis_type": "", "target_selection_rules": { "data_category":[], "agregación_permitida":[], "concept_execution": nulo, "chapter_id": nulo }, "row_filters": {} }, "advertencias":[]}
Si la solicitud no es clara, el planificador debe devolver explícitamente una estructura de error en lugar de "adivinar" una instrucción de análisis potencialmente incorrecta.
Si la tarea no está clara, devuelva: { "status": "error", "parent_instruction_summary": "", "selection_rule": { "analysis_type": null, "target_selection_rules": { "data_category":[], "agregación_permitida":[], "concept_execution": null, "chapter_id": null }, "row_filters": {} }, "warnings": [ "La tarea de análisis no se comprende claramente". ] }
En este punto, el planificador ha transformado el lenguaje natural ambiguo en una especificación de análisis determinista. Sin embargo, la ejecución real de los datos aún no ha ocurrido.
En el capítulo 5, seguiremos la solicitud de un usuario real a través del proceso completo y examinaremos cómo P_Analysis_Planner genera la regla de selección y cómo P_Analysis_Engine la ejecuta en el conjunto de datos de evaluación.
4 El motor de análisis
A diferencia de P_Analysis_Planner, P_Analysis_Engine no razona sobre la tarea. Solo ejecuta la especificación de análisis generada por P_Analysis_Planner.
Como en el capítulo 3, nos centraremos sólo en las partes más relevantes de la instrucción. La especificación completa se puede descargar aquí.
La instrucción de P_Analysis_Engine comienza con la definición de la tarea básica. En esencia, el indicador de IA se utiliza como un entorno de ejecución controlado de Python. El código está predefinido en la instrucción de solicitud y solo debe ejecutarse, no modificarse.
Eres Analysis_Engine, un ejecutor de análisis determinista basado en pandas. Su tarea es analizar un conjunto de datos de evaluación de Excel utilizando Code Interpreter. Recibirá tres entradas: 1. documento El archivo Excel que contiene los datos de la evaluación. 2. Mapping_File El archivo de Excel que describe las columnas del documento. 3. Selection_Rule Un objeto JSON que define: – qué columnas seleccionar de Mapping_File – qué filtros de fila aplicar al documento – qué tipo de análisis realizar No debe reinterpretar la solicitud del usuario original. No debe inferir columnas adicionales. No debe cambiar Selection_Rule. No se debe generar un nuevo enfoque de análisis. Solo debe ejecutar el script determinista de Python a continuación. Utilice Code Interpreter para ejecutar el script Python. Devuelve solo el resultado JSON impreso por el script. No devolver rebajas. No expliques el código. No agregue texto antes o después del resultado JSON.
P_Analysis_Engine recibe tres archivos de entrada:
El Assessment_File cargado por el usuario en la interfaz de chat. Se almacena en el documento variable interno del mensaje. Un Mapping_File que el flujo F_Call_Analysis_Engine carga desde SharePoint en preparación de la ejecución. La Selection_Rule generada por P_Analysis_Planner (ver capítulo 3).
Mapping_File juega un papel crucial en la definición de la semántica de las muchas columnas en Assessment_File en un nivel superior de abstracción. Con esta capa de abstracción, Selection_Rule solo necesita especificar qué tipo de información se requiere, mientras que P_Analysis_Engine selecciona las columnas del conjunto de datos correspondientes durante la ejecución.
La Fig. 3 muestra la estructura de Mapping_File. Contiene una fila para cada columna de Assessment_File, que es potencialmente relevante para el análisis de datos. Las columnas de datos que son claramente irrelevantes no están representadas en Mapping_File y, por lo tanto, no son visibles para P_Analysis_Engine. Para cada fila el archivo especifica los criterios de selección:
categoría_datos:
Significado funcional de la columna, por ejemplo, puntuación de madurez, fuerza, nombre de la planta, región o estación. ID_capítulo:
Identificador único del capítulo de evaluación. nombre_capítulo:
Nombre legible por humanos del capítulo de evaluación. concepto_ejecución:
Indica si la columna pertenece a concepto o madurez de ejecución. agregación_permitida:
Define qué tipo de agregación es válida para la columna, por ejemplo, media para puntuaciones de madurez numéricas o resumen para hallazgos textuales.
A continuación, en las instrucciones de P_Analysis_Engine viene un párrafo sobre cómo interpretar Selection_Rule.
Reglas para la regla_selección: – tipo_análisis = "media_numérica": calcula las medias aritméticas para todas las columnas numéricas objetivo seleccionadas. – análisis_tipo = "text_summary": recopila entradas de texto no vacías de todas las columnas de destino de texto seleccionadas. – target_selection_rules: seleccione las columnas de destino haciendo coincidir los atributos de Mapping_File. Un valor de regla nulo significa: no filtrar por este atributo. Una lista significa: mantener las filas donde el atributo Mapping_File está en la lista. – row_filters: aplica filtros de fila al documento. Las claves son valores de categoría de datos de Mapping_File, como "Planta", "Región", "Principio de producción", "Temporada". Los valores son listas de valores aceptados.
La selección especifica:
qué operación de análisis se debe ejecutar (tipo_análisis), cómo se seleccionan las columnas de destino relevantes del archivo_mapeo (rules_selección_objetivo) y cómo se filtra el conjunto de datos de evaluación antes de realizar el análisis (filtros_filas).
Esta instrucción es intencionalmente determinista. P_Analysis_Engine no puede reinterpretar la solicitud del usuario original ni inventar operaciones analíticas adicionales.
Después del bloque de instrucciones, P_Analysis_Engine recibe el script Python real. El script completo contiene más de 300 líneas de código y es parte de las instrucciones de la IA. Está vinculado en la parte superior de este capítulo y se puede descargar. Muchas de las líneas de código no son conceptualmente importantes para la arquitectura. Manejan solidez práctica: limpieza de nombres de columnas, normalización de valores de entrada, manejo de columnas faltantes, conversión de objetos contenedores Copilot y devolución de mensajes de error estructurados.
En este artículo me centraré únicamente en la lógica central.
El primer paso importante es que el motor cargue los datos de evaluación cargados (ahora disponibles en el documento) y el Mapping_File. A partir de este momento, el LLM ya no interpreta la solicitud del usuario. Solo ejecuta el script determinista basado en Selection_Rule.
mapeo_df = pd.read_excel(Mapping_File) data_df = pd.read_excel(documento) mapeo_df = strip_column_names(mapping_df) data_df = strip_column_names(data_df)
El elemento arquitectónico clave es la selección de las columnas de destino. P_Analysis_Engine nunca adivina qué columnas de Excel pueden ser relevantes. En cambio, filtra Mapping_File según los atributos definidos en target_selection_rules.
target_mapping = mapeo_df.copy() para attr, valor_regla en target_selection_rules.items(): valores = normalize_rule_value(rule_value) valores = normalize_list_for_matching(valores) si el valor es Ninguno: continuar target_mapping = target_mapping[ target_mapping[attr] .apply(normalize_for_matching) .isin(values) ] columnas_destino_seleccionadas = (mapping_destino["nombre_columna_fuente"] .dropna() .tolist() )
Este es el punto donde la instrucción del análisis abstracto se vuelve concreta. Por ejemplo, una regla como Chapter_id = ["3.5"], data_category = ["chapter_score"] y aggregation_allowed = ["mean"] se traduce a las columnas reales de Excel que contienen las puntuaciones de madurez de Concepto y Ejecución para el capítulo 3.5.
El mismo principio se aplica a los filtros de filas. Una vez más, el motor no infiere nada del lenguaje natural. Solo aplica los filtros proporcionados explícitamente en Selection_Rule.
filtered_df = data_df.copy() para filter_category, filter_values en row_filters.items(): filter_mapping = mapeo_df[ mapeo_df["data_category"] .apply(normalize_for_matching) == normalize_for_matching(filter_category) ] filter_col = filter_mapping["source_column_name"].iloc[0]filtered_df = filtered_df[ filtered_df[filter_col] .apply(normalize_for_matching) .isin(valores) ]
Después de la selección de columnas y el filtrado de filas, la lógica del análisis real se vuelve intencionalmente sencilla. Para el análisis de madurez numérica, el motor calcula medias aritméticas para todas las columnas numéricas objetivo seleccionadas.
if tipo_análisis == "numeric_mean": resultado_numérico = {} para col en columnas_objetivo_disponibles: serie = pd.to_numeric(filtered_df[col], errores="coerce") valid_count = int(series.notna().sum()) resultado_numérico[col] = { "mean": float(series.mean()) if valid_count > 0 else Ninguno, "valid_count": recuento_válido } resultado["resultado"] = resultado_numérico
Para el análisis textual, el motor recopila declaraciones del evaluador que no están vacías en lugar de calcular valores.
elif tipo_análisis == "text_summary": text_result = {} para col en columnas_destino_disponibles: valores = [ clean_text_value(v) para v en filtered_df[col].tolist() ] valores = [v para v en valores si v no es Ninguno] text_result[col] = { "entries": valores, "entry_count": len(values) } resultado["resultado"] = text_result
Finalmente, el resultado se devuelve como JSON. Esto es importante porque el resultado aún no es la respuesta final para el usuario. Es la base analítica confiable para el siguiente paso del LLM: la interpretación del agente principal.
print(json.dumps(resultado, sangría=2, asegurar_ascii=False))
Este diseño mantiene deliberadamente el P_Analysis_Engine "aburrido". No razona, no explica y no mejora el análisis. Sólo se ejecuta. Y ese es exactamente el punto. Cuanto más determinista sea esta capa, más confianza se podrá depositar en la interpretación posterior generada por el LLM.
5 Ejemplo de extremo a extremo
Para ilustrar el flujo de trabajo completo, sigamos un ejemplo realista a lo largo del proceso completo.
Activado por la interacción del usuario, el agente principal podría generar la siguiente Parent_Instruction en el módulo de análisis:
“Resumir los principales potenciales de mejora para el capítulo 1.4 Sistema de Prevención de Fallas en planta AbcP.”
La solicitud parece simple para un lector humano, pero ya contiene múltiples tareas semánticas:
identifique los capítulos de evaluación solicitados, detecte el tipo de contenido solicitado, aplique un filtro de filas, recupere las columnas de texto correctas, agregue hallazgos textuales y finalmente genere una interpretación significativa ( → agente principal).
Este es exactamente el tipo de tarea en la que un análisis basado exclusivamente en un LLM se vuelve poco confiable. Por lo tanto, el sistema separa el flujo de trabajo en pasos de ejecución deterministas y pasos de interpretación probabilística.
5.1 Traducción del Planificador de análisis
El primer paso lo realiza P_Analysis_Planner.
Traduce la solicitud de lenguaje natural en una regla de selección determinista.
{ "status": "success", "parent_instruction_summary": "Resumir los potenciales de mejora para el capítulo 1.4 Sistema de prevención de fallas en la planta AbcP.", "selection_rule": { "analysis_type": "text_summary", "target_selection_rules": { "data_category": ["potential"], "aggregation_allowed": ["summary"], "concept_execution": null, "chapter_id": ["1.4"] }, "row_filters": { "Planta": ["AbcP"] } }, "advertencias":[]}
Selection_Rule ya contiene la especificación de análisis determinista completa:
tipo_análisis = "resumen_texto"
indica que se deben recopilar los hallazgos textuales del evaluador en lugar de cálculos numéricos. categoría_datos = ["potencial"]
restringe el análisis a los potenciales de mejora. capitulo_id = ["1.4"]
limita el análisis al capítulo Sistema de Prevención de Fallas. row_filters = {"Planta": ["AbcP"]}
restringe el conjunto de datos a la planta solicitada.
En esta etapa, aún no se ha realizado ningún análisis de datos. El resultado es sólo una instrucción de ejecución para el siguiente paso.
5.2 Ejecución desde Analysis Engine
Esta Selection_Rule se entrega a P_Analysis_Engine para su ejecución. Primero, el motor selecciona todas las columnas de destino coincidentes del Mapping_File.
target_mapping = target_mapping[ target_mapping[attr] .apply(normalize_for_matching) .isin(valores) ]
Esto traduce los criterios de selección abstractos en columnas de conjuntos de datos reales, por ejemplo:
selected_target_columns = [ "1.4 CON L2 Potenciales de mejora", "1.4 CON L3 Potenciales de mejora", "1.4 EXE L2 Potenciales de mejora", "1.4 EXE L3 Potenciales de mejora" ]
A continuación, se aplican los filtros de fila:
filtered_df = filtered_df[ filtered_df[filter_col] .apply(normalize_for_matching) .isin(valores) ]
En este ejemplo, el conjunto de datos se reduce a filas de evaluación que pertenecen a la planta AbcP.
Finalmente, el motor recopila todas las entradas de texto que no estén vacías de las columnas seleccionadas.
valores = [ clean_text_value(v) para v en filtered_df[col].tolist() ] valores = [v para v en valores si v no es Ninguno]
Como podemos ver, el motor no interpreta los hallazgos. Solo los recupera y estructura según el script de Python.
La salida del motor es una colección de declaraciones escritas de los evaluadores sobre los potenciales de mejora del flujo de valores como un objeto JSON.
{ "entry_count": 6, "entries": [ "Las causas fundamentales no se rastrean sistemáticamente.", "Las reglas de escalada para fallas recurrentes no son claras.", "Las lecciones aprendidas no se transfieren entre turnos.", "Los hallazgos del mantenimiento preventivo no se integran en las actividades CIP.", "Las tendencias de fallas se visualizan de manera inconsistente", "Las actividades de resolución de problemas se enfocan principalmente en los síntomas en lugar de las causas fundamentales". ] }
En este punto, el sistema aún no ha generado ninguna recomendación. Sólo ha producido una colección confiable de resultados de evaluación relevantes. Este objeto JSON se devuelve al agente principal para su interpretación y generación de la respuesta final para el usuario.
5.3 Interpretación del agente matriz
En el paso final, el agente principal recopila todas las respuestas (potencialmente respuestas adicionales de los subagentes) y genera el resultado final.
Los hallazgos recopilados indican que el Sistema de Prevención de Fallas es actualmente más reactivo que preventivo. La mayoría de las brechas están relacionadas con la falta de una gestión sistemática de las causas fundamentales y un aprendizaje organizacional débil en todos los turnos y equipos. Las mejoras de mayor apalancamiento probablemente provendrían del fortalecimiento de las rutinas de escalamiento, la integración de los hallazgos del mantenimiento preventivo en las actividades del CIP y el establecimiento de mecanismos consistentes de aprendizaje entre turnos.
Para resumir la idea arquitectónica central del sistema:
El LLM ya no crea la base analítica por sí mismo. En cambio, interpreta un conjunto determinista de hallazgos ya validados.
La capacidad de razonamiento probabilístico del LLM se utiliza donde crea valor: interpretación, priorización, explicación y comunicación, no el procesamiento de datos en sí.
6 Por qué es importante la arquitectura de IA
Los modelos de lenguaje grandes son naturalmente fuertes en interpretación, razonamiento y generación de lenguaje, pero aún débiles en análisis numéricos confiables. Su objetivo de optimización es la plausibilidad, no la reproducibilidad determinista. Incluso con extensiones como “Code Interpreter”, esta debilidad sigue siendo visible en escenarios analíticos más complejos.
La buena noticia es que esta limitación se puede compensar en gran medida mediante una arquitectura de sistema inteligente. La clave es una clara separación de responsabilidades: las capas deterministas de procesamiento de datos ejecutan la base analítica, mientras que los LLM se centran en la interpretación, la priorización, la explicación y la comunicación.
Por lo tanto, en el enfoque presentado, la decisión de diseño más importante fue no agregar más IA al sistema. Se estaba definiendo con mucho cuidado dónde debería terminar el razonamiento probabilístico y dónde debería comenzar la ejecución determinista.
Los sistemas agentes confiables probablemente requerirán exactamente este tipo de arquitecturas híbridas: combinar la solidez de los canales de ciencia de datos clásicos con las capacidades de inferencia de los modelos de lenguaje grandes.