

En estadística, un punto común de confusión para muchos estudiantes es por qué dividimos por n−1 al calcular la varianza muestral, en lugar de simplemente usar n, el número de observaciones en la muestra. Esta elección puede parecer pequeña, pero es un ajuste crítico que corrige un sesgo natural que ocurre cuando estimamos la varianza de una población a partir de una muestra. Repasemos el razonamiento en un lenguaje sencillo, con ejemplos para comprender por qué es necesario dividir por n−1, conocida como corrección de Bessel.
El concepto central de la corrección (en la corrección de Bessel) es que tendemos a corregir nuestra estimación, pero una pregunta clara es ¿estimación de qué? Entonces, al aplicar la corrección de Bessel tendemos a corregir la estimación de las desviaciones calculadas a partir de nuestra media muestral supuesta, nuestra media muestral supuesta rara vez coincidirá con la media poblacional real, por lo que es seguro asumir que en el 99,99% (incluso más que eso en casos reales) nuestra media muestral no sería igual a la media poblacional. Hacemos todos los cálculos basados en esta media muestral supuesta, es decir, estimamos los parámetros de la población a través de la media de esta muestra.
Al leer más adelante en el blog, uno tendría una intuición clara de por qué en todos esos casos del 99,99% (en todos los casos excepto en el caso en el que media de la muestra = media de la población), tendemos a subestimar las desviaciones de las desviaciones reales. Entonces, para compensar este error de subestimación, bucear en un número menor que ‘n’ hace el trabajo, por lo que bucear en n-1 en lugar de n representa la compensación de la subestimación que se realiza al calcular las desviaciones de la muestra. significar.
Empieza a leer desde aquí y eventualmente entenderás…
Cuando tenemos una población completa de puntos de datos, la varianza se calcula encontrando la media (promedio), luego determinando cómo cada punto se desvía de esta media, elevando al cuadrado estas desviaciones, sumándolas y finalmente dividiendo por n, el número total de puntos en la población. Esto nos da la varianza poblacional.
Sin embargo, si no tenemos datos para una población completa y, en cambio, trabajamos solo con una muestra, estimamos la varianza de la población. Pero aquí radica el problema: cuando utilizamos sólo una muestra, no conocemos la verdadera media poblacional (indicada como μ), por lo que utilizamos la media muestral (x_bar) en su lugar.
Para entender por qué dividimos por n−1 en el caso de muestras, debemos observar de cerca lo que sucede cuando usamos la media muestral en lugar de la media poblacional. Para aplicaciones de la vida real, confiar en estadísticas de muestra es la única opción que tenemos. Así es como funciona:
Cuando calculamos la varianza en una muestra, encontramos la desviación de cada punto de datos de la media de la muestra, elevamos al cuadrado esas desviaciones y luego tomamos el promedio de estas desviaciones al cuadrado. Sin embargo, la media muestral no suele ser exactamente igual a la media poblacional. Debido a esta diferencia, el uso de la media muestral tiende a subestimar la verdadera dispersión o variación en la población.
Analicémoslo con todos los casos posibles que pueden ocurrir (tres casos diferentes), daré un recorrido detallado sobre el primer caso, el mismo principio se aplica a los otros dos casos también, se brindó un recorrido detallado para el caso 1.
1. Cuando la media muestral es menor que la media poblacional (x_bar < media poblacional)
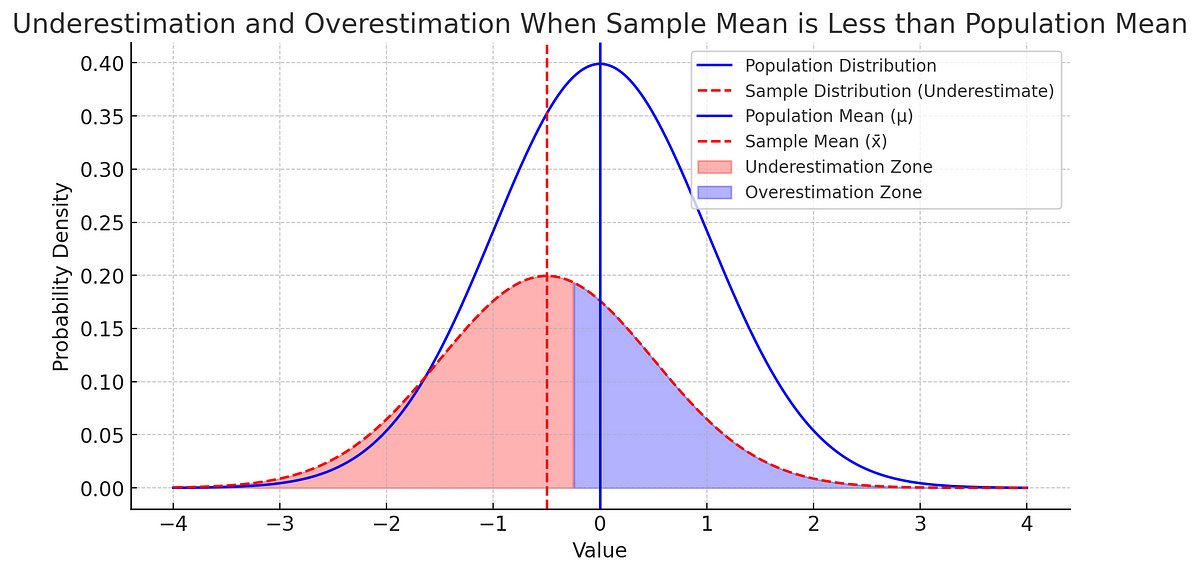
Si nuestra media muestral (x_bar) es menor que la media poblacional (μ), entonces muchos de los puntos de la muestra estarán más cerca de (x_bar) que de μ. Como resultado, las distancias (desviaciones) de la media son menores en promedio, lo que lleva a un cálculo de varianza menor. Esto significa que estamos subestimando la variación real.
Explicación del gráfico que se proporciona a continuación: la distribución normal más pequeña es de nuestra muestra y la distribución normal más grande es de nuestra población (en el caso anterior, donde x_bar Como tenemos puntos de datos de nuestra muestra, porque eso es lo que podemos recopilar, no podemos recopilar todos los puntos de datos de la población porque eso simplemente no es posible. Para todos los puntos de datos de nuestra muestra en este caso, desde el infinito negativo hasta el punto medio de x_bar y la media poblacional, la diferencia (desviaciones) absoluta o al cuadrado entre los puntos de muestra y la media poblacional sería mayor que la diferencia absoluta o al cuadrado. (desviaciones) entre los puntos de muestra y la media de la muestra y en el lado derecho del punto medio hasta el infinito positivo, las desviaciones calculadas con respecto a la media de la muestra serían mayores que las desviaciones calculadas utilizando la media de la población. La región se indica en el gráfico a continuación para el caso anterior, debido a la naturaleza simétrica de la curva normal seguramente podemos decir que la zona de subestimación sería mayor que la zona de sobreestimación que también se destaca en el gráfico a continuación, lo que resulta en una subestimación general de las desviaciones. Entonces, para compensar la subestimación, dividimos las desviaciones por un número menor que el tamaño de muestra ‘n’, que es ‘n-1’, lo que se conoce como corrección de Bessel. Si la media de la muestra es mayor que la media de la población, tenemos la situación inversa: los puntos de datos en el extremo inferior de la muestra estarán más cerca de x_bar que de μ, lo que aún resultará en una subestimación de la varianza. Con base en los detalles establecidos anteriormente, está claro que en este caso también la zona de subestimación es mayor que la zona de sobreestimación, por lo que en este caso también explicaremos esta subestimación dividiendo las desviaciones por ‘n-1’ en lugar de n. Este caso es raro y sólo si la media muestral está perfectamente alineada con la media poblacional nuestra estimación sería insesgada. Sin embargo, esta alineación casi nunca ocurre por casualidad, por lo que generalmente asumimos que estamos subestimando. Claramente, las desviaciones calculadas para los puntos muestrales con respecto a la media muestral son exactamente las mismas que las desviaciones calculadas con respecto a la media poblacional, porque tanto la media muestral como la media poblacional son iguales. Esto no daría lugar a ninguna zona de subestimación o sobreestimación. En resumen, cualquier diferencia entre x_bar y μ (que casi siempre ocurre) nos lleva a subestimar la varianza. Es por eso que necesitamos hacer una corrección dividiendo por n−1, lo que explica este sesgo. Dividir por n−1 se llama La corrección de Bessel y compensa el sesgo natural de subestimación en la varianza muestral. Cuando dividimos por n−1, efectivamente estamos haciendo un pequeño ajuste que extiende nuestra estimación de la varianza, lo que la convierte en un mejor reflejo de la verdadera varianza de la población. También se puede relacionar todo esto con los grados de libertad; se requiere cierto conocimiento de los grados de libertad para comprenderlos desde el punto de vista de los grados de libertad. En una muestra, un grado de libertad se “agota” al calcular la media muestral. Esto nos deja con n−1 puntos de datos independientes que aportan información sobre la varianza, razón por la cual dividimos por n−1 en lugar de n. Si el tamaño de nuestra muestra es muy pequeño, la diferencia entre dividir por n y n−1 se vuelve más significativa. Por ejemplo, si tiene un tamaño de muestra de 10: Pero si el tamaño de su muestra es grande (digamos, 10.000), la diferencia entre dividir entre 10.000 o 9.999 es pequeña, por lo que el impacto de la corrección de Bessel es mínimo. Si no utilizamos la corrección de Bessel, nuestra varianza muestral generalmente subestimará la varianza poblacional. Esto puede tener efectos en cascada, especialmente en el modelado estadístico y la prueba de hipótesis, donde las estimaciones precisas de la varianza son cruciales para sacar conclusiones confiables. Por ejemplo: La elección de dividir por n−1 no es arbitraria. Si bien no entraremos en la demostración detallada aquí, se basa en la teoría matemática. Dividir por n−1 proporciona una estimación insesgada de la varianza poblacional cuando se calcula a partir de una muestra. Otros ajustes, como n−2, corregirían en exceso y conducirían a una sobreestimación de la varianza. Imagine que tiene una población pequeña con un peso medio de 70 kg. Ahora digamos que tomas una muestra de 5 personas de esta población y sus pesos (en kg) son 68, 69, 70, 71 y 72. La media muestral es exactamente 70 kg, idéntica a la media poblacional por coincidencia. Ahora supongamos que calculamos la varianza: Usar la corrección de Bessel de esta manera aumenta ligeramente nuestra estimación de la varianza, acercándola a lo que sería la varianza de la población si la calculáramos a partir de toda la población en lugar de solo una muestra. Dividir por n−1 al calcular la varianza de la muestra puede parecer un cambio pequeño, pero es esencial para lograr una estimación insesgada de la varianza de la población. Este ajuste, conocido como corrección de Bessel, explica la subestimación que se produce al confiar en la media muestral en lugar de la media poblacional real. En resumen: Al comprender y aplicar la corrección de Bessel, nos aseguramos de que nuestros análisis estadísticos reflejen la verdadera naturaleza de los datos que estudiamos, lo que lleva a conclusiones más precisas y confiables.2. Cuando la media muestral es mayor que la media poblacional
3. Cuando la media muestral es exactamente igual a la media poblacional (0,000001%)