
De cada aplicación, producto o tablero de datos basada en datos se encuentra un componente crítico: la base de datos. Estos sistemas han sido durante mucho tiempo la base para almacenar, administrar y consultar datos estructurados, ya sean relacionales, series de tiempo o distribuidos en plataformas en la nube.
Para interactuar con estos sistemas, nos hemos basado en SQL (lenguaje de consulta estructurado), una forma estandarizada e increíblemente poderosa de recuperar, manipular y analizar datos. SQL es expresivo, preciso y optimizado para el rendimiento. Sin embargo, para muchos usuarios, especialmente aquellos nuevos en datos, SQL puede ser intimidante. Recordar la sintaxis, la comprensión y la navegación de esquemas complejos pueden ser una barrera para la productividad.
¡Pero la idea de consultar bases de datos en idiomas naturales no es nueva! De hecho, la investigación sobre las interfaces del lenguaje natural a las bases de datos (NLIDB) se remonta a la década de 1970. Proyectos como LUNAR y PRECISO Exploró cómo los usuarios podrían hacer preguntas en inglés simple y recibir respuestas estructuradas impulsadas por SQL. A pesar del gran interés académico, estos primeros sistemas lucharon con la generalización, la ambigüedad y la escalabilidad. En 2029, Powerbi también nos mostró una visión temprana de la consulta de datos del lenguaje natural en 2019. Si bien la característica de preguntas y respuestas era prometedora, luchó con consultas complejas, requirió frases precisas y dependía en gran medida de cuán limpio estaba el modelo de datos. ¡Al final, carecía del tipo de razonamiento y flexibilidad que los usuarios esperan de un verdadero asistente!
Pero, ¿qué pasa con 2025? ¿Sabemos que tenemos la tecnología para que esto suceda?
¿Pueden LLMS hacer ahora lo que no pudimos hacer antes?
Basado en lo que sabemos sobre LLM y sus capacidadestambién entendemos que, junto con el concepto de agentes de IA, están equipados de manera única para cerrar la brecha entre SQL técnico y consultas humanas naturales. Son excelentes para interpretar preguntas vagas, generar SQL sintácticamente correcto y adaptarse a diferentes intentos de los usuarios. Esto los hace ideales para las interfaces conversacionales a los datos. Sin embargo, los LLM no son deterministas; Confían en gran medida en la inferencia probabilista, lo que puede conducir a alucinaciones, suposiciones incorrectas o
Aquí es donde los agentes de IA se vuelven relevantes. Al envolver un LLM dentro de un sistema estructurado, uno que incluye memoria, herramientas, capas de validación y un propósito definido, podemos reducir las desventajas de las salidas probabilísticas. El agente se convierte en algo más que un generador de texto: se convierte en un colaborador que comprende el entorno en el que está operando. Combinado con estrategias adecuadas para la base, la inspección del esquema y la detección de la intención del usuario, Los agentes nos permiten construir sistemas que sean mucho más confiables que las configuraciones de inmediato.
Y esa es la base de este breve tutorial: ¡cómo construir su primer asistente de agente de IA para consultar su catálogo de datos!
Guía paso a paso para crear un asistente de catálogo de Databricks
En primer lugar, necesitamos elegir nuestra pila tecnológica. ¡Necesitaremos un proveedor de modelos, una herramienta para ayudarnos a hacer cumplir la estructura en el flujo de nuestro agente, los conectores a nuestras bases de datos y una UI simple para alimentar la experiencia de chat!
- OpenAI (GPT-4): Mejor en la clase para la comprensión del lenguaje natural, el razonamiento y la generación SQL.
- Pydantic AI: Agrega estructura a las respuestas LLM. Sin alucinaciones o respuestas vagas, solo salidas limpias y validadas por esquema.
- Racionalizar: Cree rápidamente una interfaz de chat receptiva con LLM incorporado y componentes de retroalimentación.
- Conector SQL de Databricks: Acceda a su catálogo, esquema y consulta de su espacio de trabajo de Databricks en tiempo real.
Y bueno, no olvidemos: este es solo un proyecto pequeño y simple. Si planeaba implementarlo en producción, en múltiples usuarios y abarcando varias bases de datos, definitivamente necesitaría pensar en otras preocupaciones: escalabilidad, control de acceso, gestión de identidad, diseño de casos de uso, experiencia del usuario, privacidad de datos … y la lista continúa.
1. Configuración del medio ambiente
Antes de sumergirnos en la codificación, preparemos nuestro entorno de desarrollo. Este paso asegura que todos los paquetes requeridos estén instalados y aislados en un entorno virtual limpio. Esto evita los conflictos de versión y mantiene nuestro proyecto organizado.
conda create -n sql-agent python=3.12
conda activate sql-agent

pip install pydantic-ai openai streamlit databricks-sql-connector
2. Cree las herramientas y la lógica para acceder a la información del catálogo de datos de Databricks
Si bien construir un agente SQL conversacional puede parecer un problema de LLM, en realidad es un problema de datos primero. Necesita metadatos, contexto a nivel de columna, limitaciones e idealmente una capa de perfil para saber qué es seguro consultar y cómo interpretar los resultados. Esto es parte de lo que llamamos el pila de IA centrada en datos (¡Puede sonar también 2021, pero te prometo que todavía es súper relevante!) – Uno en el que vienen el perfil, la calidad y la validación de esquemas antes Ingeniería rápida.
En este contexto, y debido a que el agente necesita contexto para razonar sobre sus datos, este paso incluye configurar una conexión a su espacio de trabajo de Databricks y extraer programáticamente la estructura de su catálogo de datos. Estos metadatos servirán como base para generar consultas SQL precisas.
def set_connection(server_hostname: str, http_path: str, access_token: str):
    connection = sql.connect(
        server_hostname=server_hostname,
        http_path=http_path,
        access_token=access_token
    )
    return connection
El código completo para el conector de metadatos se puede encontrar aquí.
3. Construya el agente SQL con Pydantic AI
Aquí está donde definimos nuestro agente de IA. Estamos usando pydantic-ai Para hacer cumplir las salidas estructuradas, en este caso, queremos asegurarnos de que siempre recibiremos una consulta SQL limpia del LLM. Esto hace que el agente sea seguro para usar en aplicaciones y reduce la posibilidad de un código vago y, lo que es más importante, un código incomparable.
Para definir el agente, comenzamos especificando un esquema de salida con Pydantic, en este caso, un solo campo code representando la consulta SQL. Entonces, usamos el Agent Clase para conectar el indicador del sistema, el nombre del modelo y el tipo de salida.
from pydantic import BaseModel
from pydantic_ai.agent import Agent
from pydantic_ai.messages import ModelResponse, TextPart

# ==== Output schema ====
class CatalogQuery(BaseModel):
    code: str

# ==== Agent Factory ====
def catalog_metadata_agent(system_prompt: str, model: str="openai:gpt-4o") -> Agent:
    return Agent(
        model=model,
        system_prompt=system_prompt,
        output_type=CatalogQuery,
        instrument=True
    )

# ==== Response Adapter ====
def to_model_response(output: CatalogQuery, timestamp: str) -> ModelResponse:
    return ModelResponse(
        parts=[TextPart(f"```sql\n{output.code}\n```")],
        timestamp=timestamp
    )
La solicitud del sistema proporciona instrucciones y ejemplos para guiar el comportamiento de la LLM, mientras que instrument=True Permite el rastreo y la observabilidad para la depuración o la evaluación.
El indicador del sistema en sí fue diseñado para guiar el comportamiento del agente. Establece claramente el objetivo del asistente (escribiendo consultas SQL para el catálogo de Unity), incluye el contexto de metadatos para fundamentar su razonamiento y proporciona ejemplos concretos para ilustrar el formato de salida esperado. Esta estructura ayuda al modelo LLM a mantenerse enfocado, reducir la ambigüedad y devolver respuestas predecibles y válidas.
4. Construya la interfaz de chat de transmisión
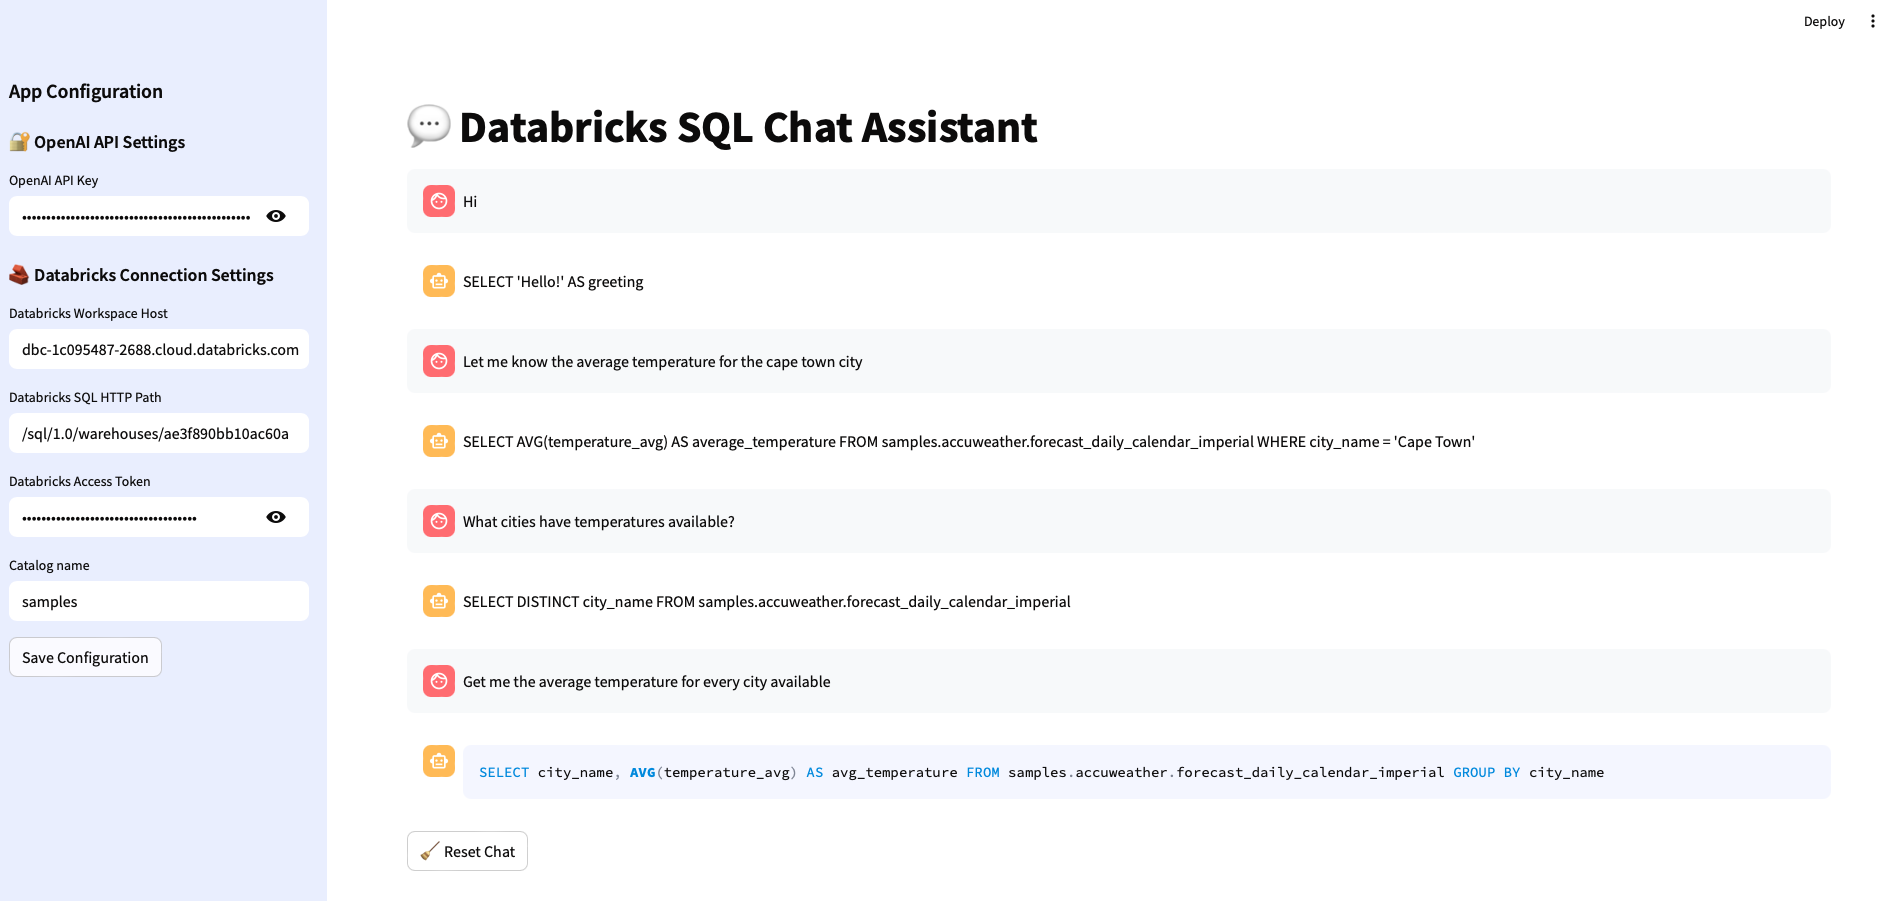
Ahora que tenemos las bases para nuestro agente SQL, es hora de hacerlo interactivo. Aprovechando la racionalización, ahora crearemos un front-end simple donde podamos hacer preguntas de lenguaje natural y recibir consultas SQL generadas en tiempo real.
Afortunadamente, Streamlit ya nos ofrece poderosos bloques de construcción para crear experiencias de chat con alimentación de LLM. Si tienes curiosidad, aquí hay una gran tutorial Eso pasa por todo el proceso en detalle.
Puedes encontrar el código completo para esto Tutorial aquí y tú puede probar la aplicación en la nube de la comunidad de optimismo.
Pensamientos finales
En este tutorial, ha aprendido a caminar por la mecánica inicial de construir un agente de IA simple. El foco estaba en crear un prototipo liviano para ayudarlo a comprender cómo estructurar los flujos de agentes y experimentar con las herramientas modernas de IA.
Pero, si tuviera que llevar esto a la producción, aquí hay algunas cosas a considerar:
- Las alucinaciones son reales, y no puede asegurarse de que el retorno SQL sea correcto. Aprovechar el análisis estático SQL para validar la salida e implementar el mecanismo de reintento, idealmente más determinista;
- Aproveche las herramientas del esquema para verificar la cordura Los nombres y columnas de la tabla.
- Agregue flujos de respuesta cuando falla una consulta, por ejemplo, “¿Te refieres a esta tabla?”
- Hazlo con estado
- Todo lo relacionado con la infraestructura, identificar administraciones y operaciones del sistema.
Al final del día, lo que hace que estos sistemas sean efectivos no es solo el modelo, es el datos Eso lo hace. Los metadatos limpios, las indicaciones bien escoltas y la validación contextual son parte de la pila de calidad de datos que convierte las interfaces generativas en agentes confiables.