
La inteligencia artificial (IA) domina los titulares de hoy: el avance de hoy, advirtió como una amenaza al siguiente. Sin embargo, gran parte de este debate ocurre en una burbuja, centrada en las esperanzas abstractas y los miedos en lugar de las soluciones concretas. Mientras tanto, un desafío urgente que a menudo se pasa por alto es el aumento de los problemas de salud mental en las comunidades en línea, donde los intercambios sesgados o hostiles erosionan la confianza y la seguridad psicológica.
Este artículo presenta una aplicación práctica de IA dirigida a ese problema: una tubería de aprendizaje automático diseñada para detectar y mitigar el sesgo en el contenido generado por el usuario. El sistema combina modelos de aprendizaje profundo para la clasificación con modelos generativos de lenguaje grande (LLM) para elaborar respuestas sensibles al contexto. Entrenado en más de dos millones de comentarios de Reddit y Twitter, logró una alta precisión (F1 = 0.99) y generó mensajes de moderación a medida a través de una persona moderadora virtual.
A diferencia de gran parte de la exageración que rodea la IA, este trabajo demuestra una herramienta tangible y desplegable que admite el bienestar digital. Muestra cómo la IA puede servir no solo la eficiencia comercial o las ganancias, sino también la creación de espacios más justos y más inclusivos donde las personas se conectan en línea. En lo que sigue, describo la tubería, su rendimiento y sus implicaciones más amplias para las comunidades en línea y el bienestar digital. Para los lectores interesados en explorar la investigación con mayor profundidad, incluido un video de presentación de póster que explica las áreas del código y el informe de investigación de larga duración, los recursos están disponibles en GitHub. [1]
Una tubería de aprendizaje automático que emplea inteligencia artificial generativa para abordar el sesgo en las redes sociales tiene valor para el bienestar mental de la sociedad. Cada vez más, la interacción humana con las computadoras confía en las respuestas que los modelos de idiomas grandes proporcionan en el diálogo de razonamiento.
Método
El sistema fue diseñado como una tubería trifásica: recolectar, detectar y mitigar. Cada fase combinó técnicas de procesamiento del lenguaje natural establecido (PNL) con modelos modernos de transformadores para capturar tanto la escala como la sutileza del lenguaje sesgado en línea.
Paso 1. Recopilación y preparación de datos
Obtuve 1 millón de publicaciones de Twitter del conjunto de datos Sentiment140 [2] y 1 millón de comentarios de Reddit de un Corpus curado de desplazamiento de empuje (2007–2014) [3]. Los comentarios fueron limpiados, anonimizados y deduplicados. El preprocesamiento incluyó tokenización, lemmatización, eliminación de palabras de parada y coincidencia de frases utilizando NLTK y Spacy.
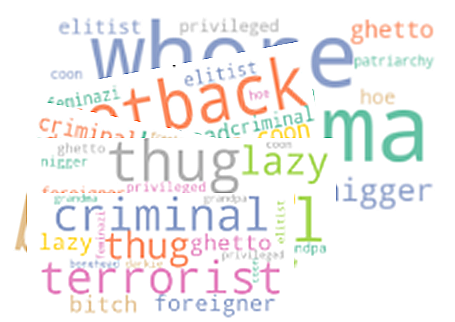
Para entrenar los modelos de manera efectiva, diseñé las características de metadatos, como BIAS_TERMS, HAS_BIAS y BIAS_TYPE, que permitieron la estratificación a través de subconjuntos sesgados y neutros. La Tabla 1 resume estas características, mientras que la Figura 1 muestra la frecuencia de los términos de sesgo en los conjuntos de datos.
Abordar la fuga de datos y los problemas de sobreajuste del modelo son importantes en las primeras etapas de preparación de datos.

Las técnicas de aprendizaje supervisadas se utilizan para etiquetar los términos de sesgo y clasificarlas como formas implícitas o explícitas.
Paso 2. Anotación de sesgo y etiquetado
El sesgo se anotó en dos ejes: presencia (sesgada versus no sesgada) y forma (implícita, explícita o ninguno). El sesgo implícito se definió como un lenguaje sutil o codificado (por ejemplo, estereotipos), mientras que el sesgo explícito era insuficiencia manifiesta o amenazas. Por ejemplo, “el abuelo Biden cayó por las escaleras” fue codificado como agente, mientras que “Biden es un abuelo que ama a su familia” no lo fue. Esta codificación contextual redujo los falsos positivos.
Paso 3. Modelos de sentimiento y clasificación
Dos modelos de transformadores alimentaron la etapa de detección:
– Roberta [4] fue ajustado para la clasificación de sentimientos. Sus salidas (positivas, neutrales, negativas) ayudaron a inferir el tono de los comentarios sesgados.
– Distilbert [5] fue entrenado en el conjunto de datos enriquecido con etiquetas implícitas/explícitas, lo que permite una clasificación precisa de señales sutiles.
Con el modelo de detección entrenado con la mayor precisión, los comentarios son evaluados por un modelo de lenguaje grande y se produce una respuesta.
Paso 4. Estrategia de mitigación
La detección de sesgos fue seguida por la mitigación en tiempo real. Una vez que se identificó un comentario sesgado, el sistema generó una respuesta adaptada al tipo de sesgo:
– Sesgo explícito: correcciones directas y asertivas.
– Sesgo implícito: refrescos más suaves o sugerencias educativas.
Las respuestas fueron generadas por ChatGPT [6]elegido por su flexibilidad y sensibilidad al contexto. Todas las respuestas se enmarcaron a través de una persona moderadora ficticia, Jenai-Moderator ™, que mantuvo una voz y tono consistentes (Figura 3).
Paso 5. Arquitectura del sistema
La tubería completa se ilustra en la Figura 4. Integra el preprocesamiento, la detección de polarización y la mitigación generativa. Los datos y las salidas del modelo se almacenaron en un esquema relacional PostgreSQL, lo que permite el registro, la auditoría e integración futura con los sistemas humanos en el bucle.
Resultados
El sistema se evaluó en un conjunto de datos de más de dos millones de comentarios de Reddit y Twitter, centrándose en la precisión, los matices y la aplicabilidad del mundo real.
Extracción de características
Como se muestra en la Figura 1, los términos relacionados con la raza, el género y la edad aparecieron desproporcionadamente en los comentarios de los usuarios. En el primer paso de exploración de datos, se exploraron los conjuntos de datos completos, y hubo una ocurrencia del 4 por ciento de sesgo identificado en los comentarios. La estratificación se utilizó para abordar el desequilibrio de no sesgo a sesgo. Los términos de sesgo como la marca y el acoso escolar parecían con poca frecuencia, mientras que el sesgo político apareció tan prominentemente como otros sesgos relacionados con la equidad.
Rendimiento del modelo
– Roberta logró una precisión de validación del 98.6% por la segunda época. Sus curvas de pérdida (Figura 5) convergieron rápidamente, con una matriz de confusión (Figura 6) que muestra una fuerte separación de clase.
– Distilbert, entrenado en etiquetas implícitas/explícitas, alcanzó una puntuación F1 del 99% (Figura 7). A diferencia de la precisión bruta, F1 refleja mejor el equilibrio de precisión y retiro en conjuntos de datos desequilibrados[7].
Distribución de tipo sesgo
La Figura 8 muestra diagramas de caja de tipos de sesgo distribuidos sobre los recuentos de registros de sentimientos predichos. La longitud del cuadro se aplica a los comentarios negativos donde aproximadamente 20,000 registros de la base de datos estratificada que incluían comentarios muy negativos y negativos combinados. Para comentarios positivos, es decir, comentarios que reflejan el sentimiento cariñoso o no sesgado, las parcelas de caja abarcan unos 10,000 registros. Los comentarios neutrales fueron en unos 10,000 registros. El desglose de sesgo y del sentimiento predicho valida la lógica de clasificación informada por el sentimiento.
Efectividad de la mitigación
Las respuestas generadas del moderador jenai representada en la Figura 3 fueron evaluadas por revisores humanos. Las respuestas fueron juzgadas lingüísticamente precisas y contextualmente apropiadas, especialmente para el sesgo implícito. La Tabla 2 proporciona ejemplos de predicciones del sistema con comentarios originales, que muestran sensibilidad a casos sutiles.
Discusión
La moderación a menudo se enmarca como un problema de filtrado técnico: detectar una palabra prohibida, eliminar el comentario y seguir adelante. Pero la moderación también es una interacción entre usuarios y sistemas. En la investigación de HCI, la equidad no es solo técnica sino también experiencial [8]. Este sistema adopta esta perspectiva, enmarcando la mitigación como diálogo a través de un moderador impulsado por la persona: Jenai-Moderator.
Moderación como interacción
El sesgo explícito a menudo requiere una corrección firme, mientras que el sesgo implícito se beneficia de la retroalimentación constructiva. Al reformular en lugar de eliminar, el sistema fomenta la reflexión y el aprendizaje [9].
Justicia, tono y diseño
El tono importa. Las correcciones demasiado duras corren el riesgo de alienar a los usuarios; Las advertencias demasiado educadas corren el riesgo de ser ignorados. Este sistema varía el tono: asertivo para el sesgo explícito, educativo para el sesgo implícito (Figura 4, Tabla 2). Esto se alinea con la investigación que muestra la equidad depende del contexto [10].
Escalabilidad e integración
El diseño modular admite la integración basada en API con plataformas. El registro incorporado permite la transparencia y la revisión, mientras que las opciones humanas en el bucle aseguran salvaguardas contra la extralimitación.
Consideraciones éticas y sociotécnicas
Detección de sesgo arriesga a falsos positivos o a grupos marginados sobre controles. Nuestro enfoque mitiga esto despojando los datos de información personal, evitando etiquetas demográficas y almacenando registros revisables. Aún así, la supervisión es esencial. Como Mehrabi et al. [7] Argumentar, el sesgo nunca se elimina por completo, sino que debe manejarse continuamente.
Conclusión
Este proyecto demuestra que la IA se puede implementar de manera constructiva en las comunidades en línea, no solo para detectar el sesgo, sino para mitigarla de manera que preserve la dignidad del usuario y promueva el bienestar digital.
Contribuciones clave:
-Arquitectura de doble cola (Roberta + Distilbert).
-Motor de mitigación adaptativa de tono (CHATGPT).
-Moderación basada en la persona (Jenai-Moderator).
Los modelos lograron puntajes F1 casi perfectos (0.99). Más importante aún, las respuestas de mitigación fueron precisas y sensibles al contexto, lo que las hizo prácticas para la implementación.
Direcciones futuras:
– Estudios de usuarios para evaluar la recepción.
– implementaciones piloto para probar la confianza y el compromiso.
– Fortalecer la robustez contra la evasión (por ejemplo, lenguaje codificado).
– expandiéndose a conjuntos de datos multilingües para la justicia global.
En un momento en que la IA a menudo se elige como exageración o peligro, este proyecto muestra cómo puede ser IA socialmente beneficiosa. Al integrar la justicia y la transparencia, promueve espacios en línea más saludables donde las personas se sienten más seguras y respetadas.
Las imágenes, tablas y figuras ilustradas en este informe fueron creadas únicamente por el autor.
Expresiones de gratitud
Este proyecto cumplió los requisitos de Milestone II y CAPstone para el Programa Master of Applied Data Science (MADS) en la Facultad de Información de la Universidad de Michigan (UMSI). El póster del proyecto recibió un premio MADS en la sesión de carteles de UMSI Exposition 2025. La Dra. Laura Stagnaro se desempeñó como la mentora del Proyecto Capstone, y el Dr. Jinseok Kim se desempeñó como mentor del proyecto Milestone II.
Sobre el autor
Celia B. Banks es una científica social y de datos cuyo trabajo une los sistemas humanos y la ciencia de los datos aplicados. Su investigación doctoral en sistemas humanos y de organización exploró cómo las organizaciones evolucionan en entornos virtuales, lo que refleja su interés más amplio en la intersección de las personas, la tecnología y las estructuras. La Dra. Banks es un aprendiz de por vida, y su enfoque actual se basa en esta base a través de la investigación aplicada en ciencia de datos y análisis.
Referencias
[1] C. Banks, Celia Banks Repositorio de cartera: Sesión de Póster de la Escuela de Información de la Universidad de Michigan (2025) [Online]. Disponible: https://celiabbanks.github.io/ [Accessed 10 May 2025]
[2] A. Go, Twitter Sentiment Analysis (2009), Entropía, pag. 252
[3] Watchful1, 1 mil millones de comentarios de Reddit de 2005-2019 [Data set] (2019), Desplazamiento de empuje a través del ojo. Disponible: https://github.com/watchful1/pushshiftdumps [Accessed 1 September 2024]
[4] Y. Liu, Roberta: un enfoque de prepertinamiento de Bert de Bert (2019), sólidamente optimizado (2019), arxiv preprint arxiv, pag. 1907.116892
[5] V. Sanh, Distilbert, una versión destilada de Bert: más pequeña, más rápida, más barata y ligera (2019), arxiv preprint arxiv, pag. 1910.01108
[6] B. Zhang, mitigando sesgos no deseados con aprendizaje adversario (2018), en Conferencia AAAI/ACM sobre IA, Ética y Sociedad, pp. 335-340
[7] A. Mehrabi, una encuesta sobre sesgo y justicia en el aprendizaje automático (2021), en Encuestas de computación ACM, volumen 54, no. 6, págs. 1-35
[8] R. Binns, Equidad en el aprendizaje automático: lecciones de la filosofía política (2018), en Conferencia PMLR sobre equidad, responsabilidad y transparencia, pp. 149-159
[9] S. Jhaver, A. Bruckman y E. Gilbert, Colaboración de la Machina Humana para la Regulación de Contenido: El caso de Reddit Automoderator (2019), Transacciones ACM en interacción humana de computadora (TOCHI), volumen 26, no. 5, pp. 1-35, 2019
[10] N. Lee, P. Resnick y G. Barton, detección de sesgo algorítmico y mitigación: mejores prácticas y políticas para reducir los daños al consumidor (2019), en Instituto BrookingsWashington, DC