
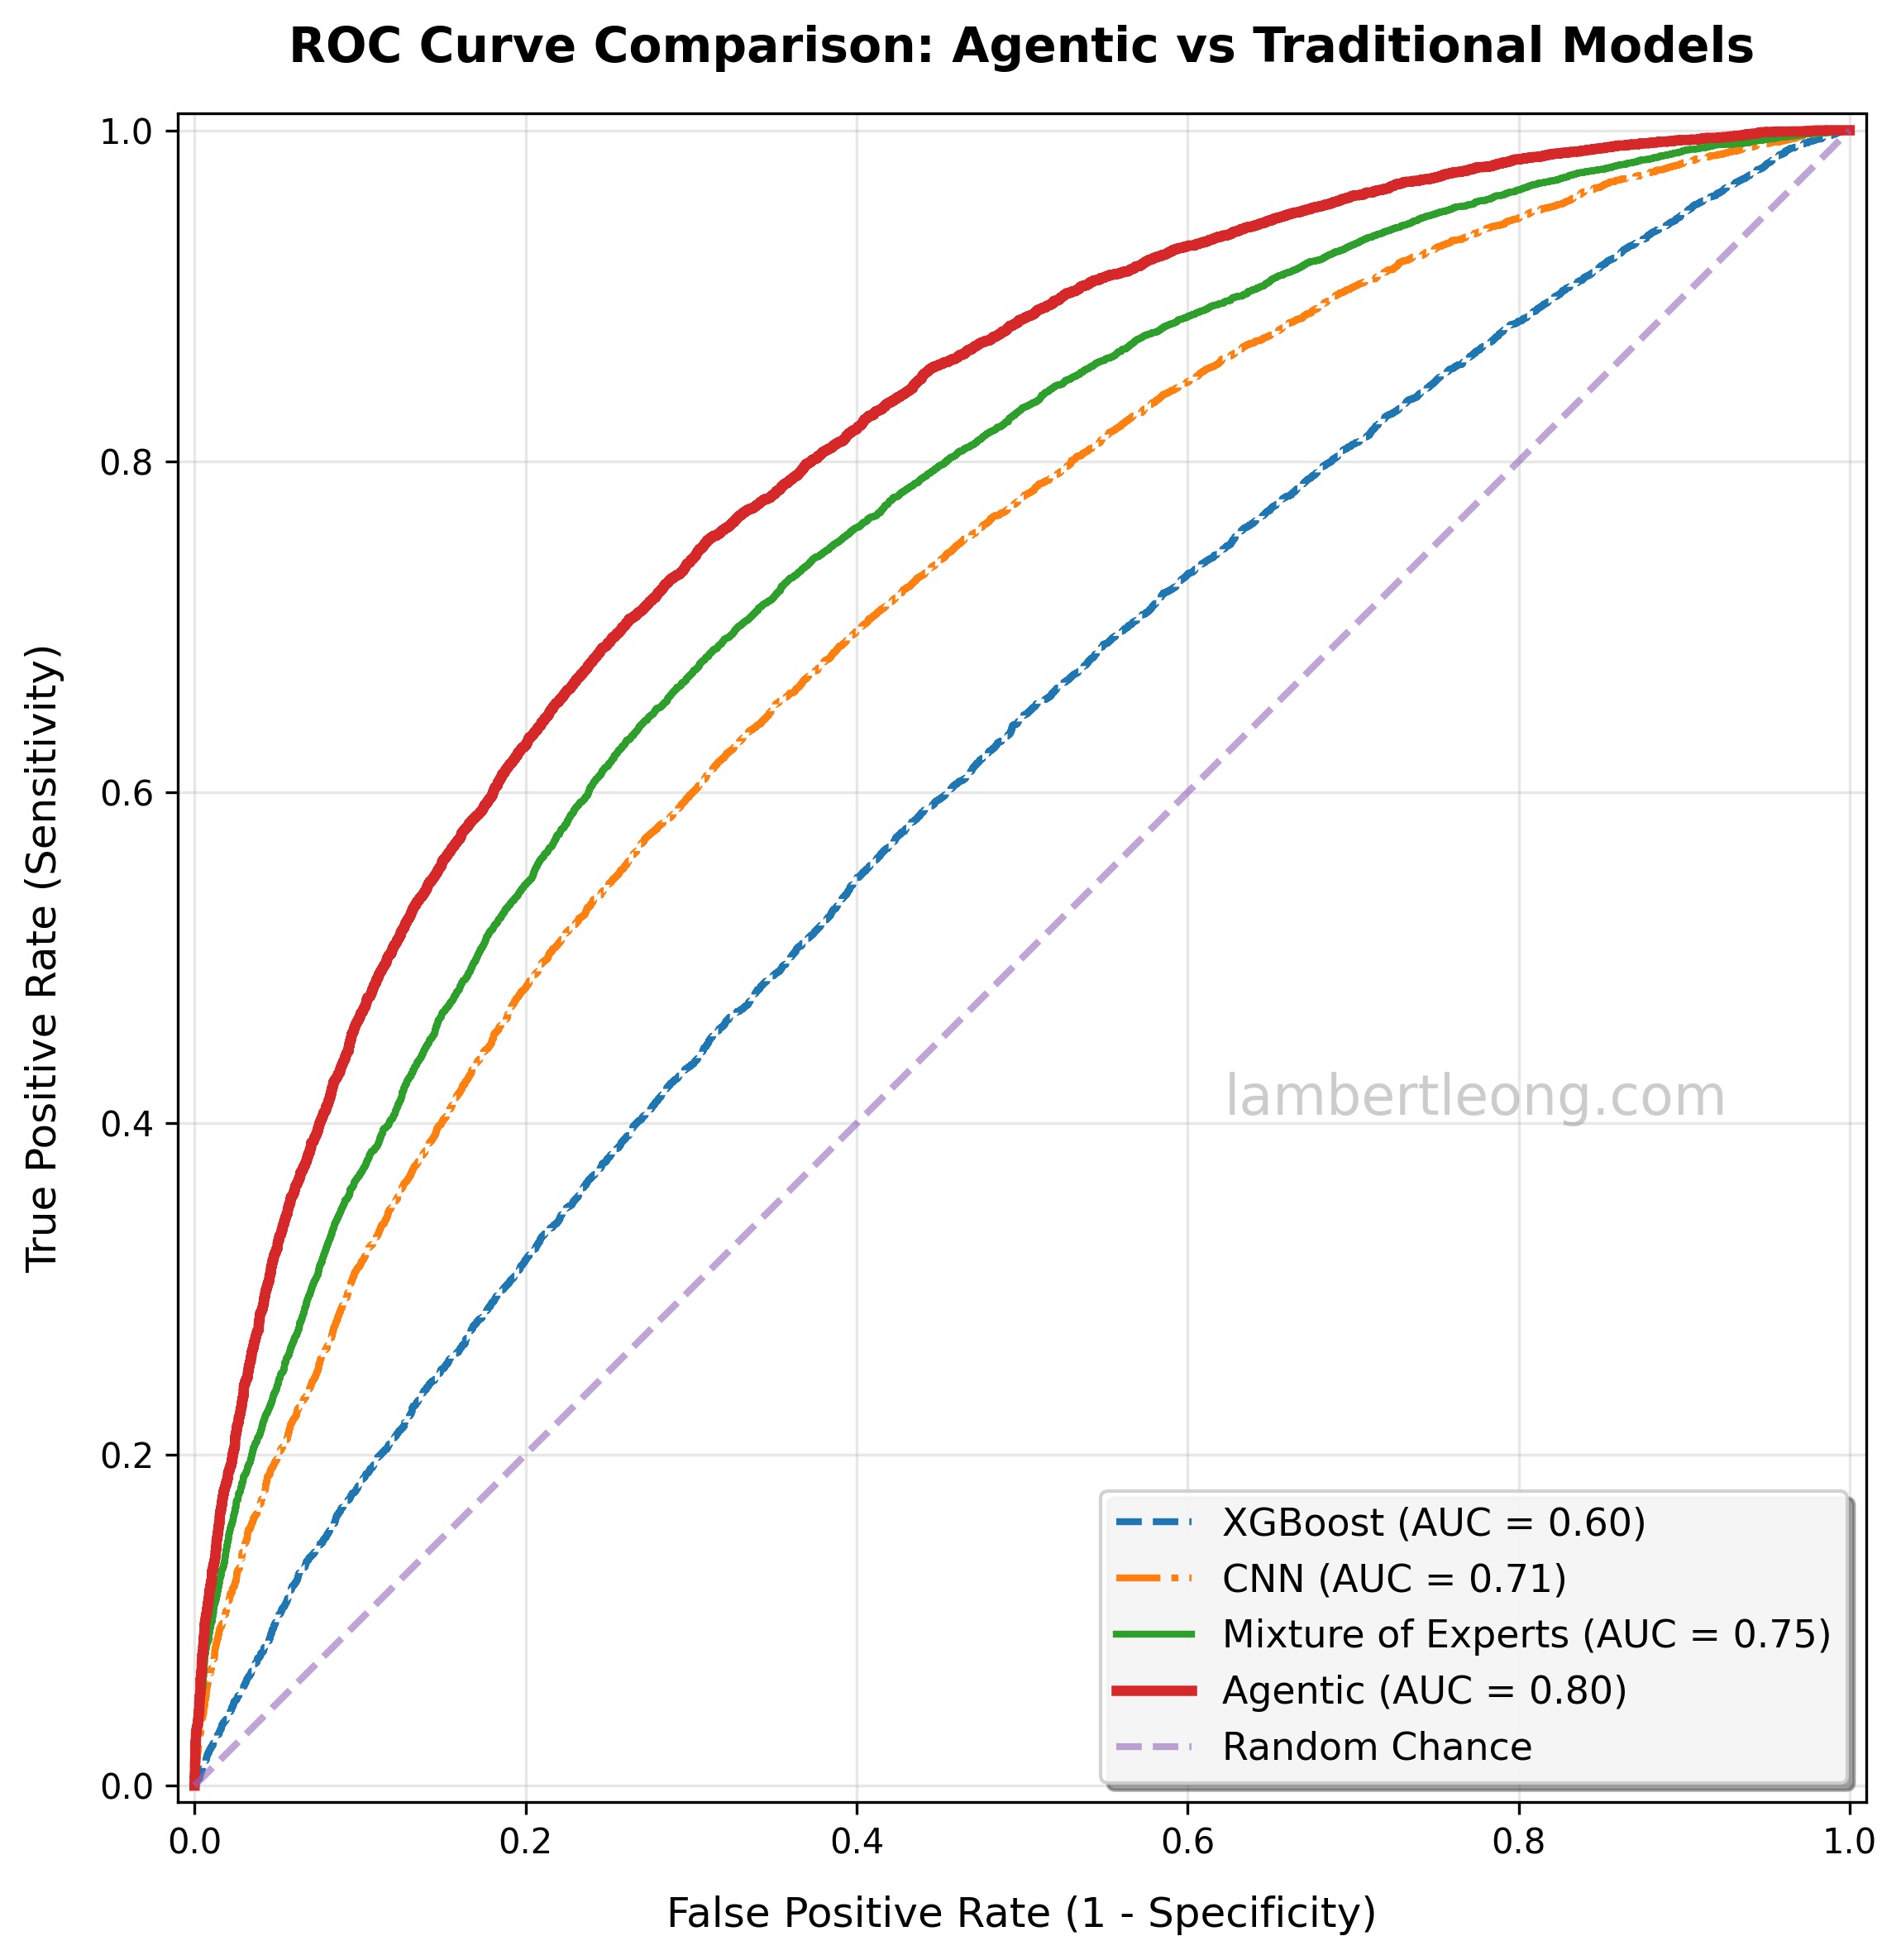
TLDR
en la atención sanitaria a menudo generan decisiones binarias como enfermedad o ninguna enfermedad, que por sí solas no pueden producir un AUC significativo. El AUC sigue siendo la forma estándar de comparar modelos de riesgo y detección en medicina, y requiere puntuaciones continuas que nos permitan clasificar a los pacientes por riesgo. Esta publicación describe varias estrategias prácticas para convertir resultados agentes en puntuaciones continuas para que las comparaciones basadas en AUC con los modelos tradicionales sigan siendo válidas y justas.
Desconexión del agente y el área bajo la curva
Los sistemas de IA agentes son cada vez más comunes a medida que reducen la barrera de entrada a las soluciones de IA. Lo logran aprovechando los modelos fundamentales, de modo que no siempre es necesario gastar recursos en entrenar un modelo personalizado desde cero o en múltiples rondas de ajuste.
Noté que aproximadamente entre el 20% y el 25% de los artículos en NeurIPS 2025 se centraban en soluciones agentes. Paralelamente, los agentes para aplicaciones médicas están aumentando y ganando popularidad. Estos sistemas incluyen canalizaciones impulsadas por LLM, agentes de recuperación aumentada y marcos de decisión de varios pasos. Pueden sintetizar datos heterogéneos, razonar paso a paso y producir recomendaciones o decisiones contextuales.
La mayoría de estos sistemas están diseñados para responder preguntas como "¿Este paciente tiene la enfermedad?" o "¿Deberíamos solicitar esta prueba?" en lugar de "¿Cuál es la probabilidad de que este paciente tenga la enfermedad?". En otras palabras, tienden a producir decisiones y explicaciones difíciles, no probabilidades calibradas.
Por el contrario, los modelos médicos tradicionales de riesgo y detección generalmente se evalúan con el área bajo la curva característica operativa del receptor o AUC. El AUC está profundamente arraigado en el trabajo de predicción clínica y es la métrica predeterminada para comparar modelos en muchos estudios de imágenes, riesgo y detección.
Esto crea una brecha. Si nuestros nuevos modelos son agentes y se centran en las decisiones, pero nuestros estándares de evaluación se basan en probabilidades, necesitamos métodos que conecten ambos. El resto de esta publicación se centra en lo que realmente necesita AUC, por qué los resultados binarios no son suficientes y cómo derivar puntuaciones continuas de marcos agentes para que AUC siga siendo utilizable.
Por qué son importantes las AUC y por qué fallan las salidas binarias
A menudo se considera que el AUC es la métrica estándar de oro en aplicaciones médicas porque maneja el desequilibrio entre casos y controles mejor que la simple precisión, especialmente en conjuntos de datos que reflejan la prevalencia en el mundo real.
La precisión puede ser una métrica engañosa cuando la prevalencia de la enfermedad es baja. Por ejemplo, la prevalencia del cáncer de mama en una población sometida a pruebas de detección es aproximadamente de 5 entre 1.000. Un modelo que predice que “no hay cáncer” para cada caso seguiría teniendo una precisión muy alta, pero la tasa de falsos negativos sería inaceptablemente alta. En un contexto clínico real, este es claramente un mal modelo, a pesar de su precisión.
El AUC mide qué tan bien un modelo separa los casos positivos de los negativos. Para ello, observa una puntuación continua de cada individuo y pregunta en qué medida estas puntuaciones clasifican los aspectos positivos por encima de los negativos. Esta vista basada en clasificaciones es la razón por la que AUC sigue siendo útil incluso cuando las clases están muy desequilibradas.
Si bien noté un gran trabajo innovador en la intersección de agentes y salud en NeurIPS, no vi muchos artículos que informaran sobre las AUC. Tampoco vi muchos que compararan un nuevo enfoque agente con un modelo de aprendizaje automático o aprendizaje profundo convencional existente o establecido utilizando métricas estándar. Sin esto, es difícil calibrar y comprender en qué medida son realmente mejores, si es que lo son, estas soluciones agentes.
La mayoría de los resultados agentes actuales no se prestan naturalmente a la obtención de AUC. Con este artículo, el objetivo es proponer métodos para obtener AUC para sistemas agentes para que podamos iniciar una conversación concreta sobre las ganancias de rendimiento en comparación con las soluciones anteriores y existentes.
Cómo se calcula el AUC
Para comprender completamente la brecha y apreciar los intentos de encontrar una solución, debemos revisar cómo se calculan las AUC.
Dejar
y ∈ {0, 1} sea la etiqueta verdadera s ∈ ℝ sea la puntuación del modelo para cada individuo
La curva ROC se construye barriendo un umbral t en todo el rango de puntuaciones y calculando
Sensibilidad en cada umbral Especificidad en cada umbral
El AUC puede entonces interpretarse como
La probabilidad de que un caso positivo seleccionado al azar tenga una puntuación más alta que un caso negativo seleccionado al azar.
Esta interpretación sólo tiene sentido si las puntuaciones contienen suficiente granularidad para inducir una clasificación entre los individuos. En la práctica, eso significa que necesitamos valores continuos o al menos finamente ordenados, no sólo ceros y unos.
Por qué las salidas agentes binarias rompen el AUC
Los sistemas agentes a menudo generan sólo una decisión binaria. Por ejemplo:
“enfermedad” asignada a 1 “sin enfermedad” asignada a 0
Si estos son los únicos resultados posibles, entonces sólo hay dos puntuaciones únicas. Cuando barremos los umbrales sobre este conjunto, la curva ROC colapsa como máximo hasta un punto no trivial más los puntos finales triviales. No existe un conjunto completo de umbrales ni una clasificación significativa.
En este caso, las AUC se vuelven indefinidas o degeneradas. Tampoco se puede comparar de manera justa con los valores AUC de los modelos tradicionales que generan probabilidades continuas.
Para evaluar soluciones de agente utilizando AUC, debemos crear una puntuación continua que capture con qué firmeza el agente cree que un caso es positivo.
lo que necesitamos
Para calcular un AUC para un sistema agente, necesitamos una puntuación continua que refleje su evaluación de riesgo subyacente, confianza o clasificación. La puntuación no tiene por qué ser una probabilidad perfectamente calibrada. Sólo necesita proporcionar un orden entre los pacientes que sea consistente con la noción interna de riesgo del agente.
A continuación se muestra una lista de estrategias prácticas para transformar resultados agentes en dichas puntuaciones.
Métodos para derivar puntuaciones continuas de sistemas agentes
Extraiga las probabilidades de registro del modelo interno. Pídale al agente que genere una probabilidad explícita. Utilice el muestreo repetido de Monte Carlo para estimar una probabilidad. Convierta puntuaciones de similitud de recuperación en puntuaciones de riesgo. Entrene un modelo de calibración además de los resultados del agente. Realice un barrido de un umbral o configuración ajustable dentro del agente para aproximarse a una curva ROC.
Tabla comparativa
En la siguiente sección, cada método se describe con más detalle, incluido por qué funciona, cuándo es más apropiado y qué limitaciones se deben tener en cuenta.
Método 1. Extraer las probabilidades de registro del modelo interno
Normalmente me inclino por este método siempre que puedo acceder a la capa de salida final del modelo o a las probabilidades de registro a nivel de token. No todas las API exponen esta información, pero cuando lo hacen, tiende a producir la señal de clasificación más confiable y estable. En mi experiencia, el uso de probabilidades logarítmicas internas a menudo produce un comportamiento más cercano al de los clasificadores convencionales, lo que hace que el análisis ROC posterior sea sencillo y sólido.
Concepto
Muchos sistemas agentes se basan en un modelo de lenguaje grande u otro modelo diferenciable internamente. Durante la decodificación, estos modelos calculan las probabilidades de registro a nivel de token. Incluso si el resultado final es una etiqueta binaria, el modelo aún evalúa la probabilidad de cada opción.
Si el agente decide entre “enfermedad” y “no enfermedad” como resultado final, podemos extraer:
log p(enfermedad) log p(sin enfermedad)
y definir una puntuación continua como:
s = log p(enfermedad) − log p(sin enfermedad)
Esta puntuación es mayor cuando el modelo favorece la etiqueta de enfermedad y menor cuando favorece la etiqueta de no enfermedad.
¿Por qué esto funciona?
Las probabilidades de registro son continuas y proporcionan una señal de clasificación fluida. Codifican directamente la preferencia del modelo entre resultados. Son una opción natural para el análisis ROC, ya que AUC solo necesita clasificación, no una calibración perfecta.
Lo mejor para
Marcos agentes claramente basados en LLM. Situaciones en las que tiene acceso a probabilidades de registro a nivel de token a través del modelo o API. Experimentos en los que le importa la calidad de clasificación precisa.
Precaución
No todas las API exponen probabilidades de registro. Los valores pueden ser sensibles al formato de avisos y a las opciones de plantilla de salida, por lo que es importante mantenerlos consistentes entre pacientes y modelos.
Método 2. Pídale al agente que genere una probabilidad
Este es el método que uso con más frecuencia en la práctica y el que veo adoptado con mayor frecuencia en los sistemas agentes aplicados. Funciona con API estándar y no requiere acceso a los componentes internos del modelo. Sin embargo, me he encontrado repetidamente con problemas de calibración. Incluso cuando se instruye a los agentes a generar probabilidades entre 0 y 1 (o 0 y 100), los valores resultantes a menudo siguen siendo pseudobinarios, agrupándose cerca de extremos como por encima del 90% o por debajo del 10%, con poca representación en el medio. Una calibración significativa normalmente requiere proporcionar ejemplos de referencia explícitos, como ilustrar cómo es un riesgo del 0%, 10% o 20%. Sin embargo, esto añade una complejidad adicional y hace que el enfoque sea un poco más frágil.
Concepto
Si el agente ya produce un razonamiento paso a paso, podemos extender el paso final para incluir una probabilidad estimada. Por ejemplo, puede indicarle al sistema:
Después de completar su razonamiento, genere una línea del formulario:
probabilidad_riesgo:
que representa la probabilidad de que este paciente tenga o desarrolle la enfermedad.
El valor numérico en esta línea se convierte en la puntuación continua.
¿Por qué esto funciona?
Genera una salida escalar continua directa para cada paciente. No requiere acceso de bajo nivel a logits o capas internas. Es fácil de explicar a los médicos, colaboradores o revisores que esperan una probabilidad numérica.
Lo mejor para
Canales de evaluación donde la interpretabilidad y la comunicación son importantes. Configuraciones donde puede modificar las indicaciones pero no las partes internas del modelo subyacente. Experimentos y prototipos en etapas iniciales.
Precaución
Es posible que la probabilidad devuelta no esté bien calibrada sin ajustes adicionales. Pequeños cambios rápidos pueden cambiar la distribución de probabilidades, por lo que el diseño rápido debe corregirse antes de una evaluación seria.
Método 3. Utilice el muestreo repetido de Monte Carlo
Este es otro método que he utilizado para construir una distribución de predicción y derivar una estimación de probabilidad. Cuando se generan suficientes muestras por entrada, funciona bien y proporciona una sensación tangible de incertidumbre. El principal inconveniente es el costo: el muestreo repetido rápidamente se vuelve costoso tanto en tiempo como en cálculo. En la práctica, he utilizado este enfoque en combinación con el Método 2. Para hacerlo, primero ejecutamos muestreos repetidos para generar una distribución empírica y ejemplos de calibración, luego cambiamos a resultados de probabilidad directa (Método 2) una vez que ese rango esté mejor establecido.
Concepto
Muchos sistemas agentes utilizan muestreo estocástico cuando razonan, recuperan información o generan texto. Esta aleatoriedad se puede aprovechar para estimar una probabilidad empírica.
Para cada paciente:
Ejecute el agente en la misma entrada N veces. Cuente cuántas veces predice enfermedad. Defina la puntuación como s = (número de predicciones de enfermedades) / N
Esta frecuencia se comporta como una probabilidad estimada de enfermedad según el agente.
¿Por qué esto funciona?
Convierte predicciones discretas de sí o no en una estimación de probabilidad continua. Capta la incertidumbre interna del agente, tal como se refleja en su comportamiento de muestreo. No requiere registros de probabilidades ni acceso especial al modelo.
Lo mejor para
Agentes estocásticos LLM que producen diferentes resultados cuando cambia la semilla o la temperatura aleatoria. Canalizaciones agentes que incorporan opciones aleatorias en la recuperación o planificación. Escenarios en los que desea una estimación de probabilidad conceptualmente simple.
Precaución
Realizar N inferencias repetidas por paciente aumenta el tiempo de cálculo. La varianza de la estimación disminuye con N, por lo que debe elegir N lo suficientemente grande para lograr estabilidad pero lo suficientemente pequeño para seguir siendo eficiente.
Método 4. Convertir puntuaciones de similitud de recuperación en puntuaciones de riesgo
Concepto
Los agentes de recuperación aumentada normalmente consultan una base de datos vectorial de pacientes anteriores, notas clínicas o incrustaciones derivadas de imágenes. La etapa de recuperación produce puntuaciones de similitud entre el paciente actual y los ejemplares almacenados.
Si tiene un conjunto de ejemplos positivos o de alto riesgo, puede definir una puntuación como
s = maxj similitud(x, ej)
donde ej indexa incorporaciones de casos positivos conocidos y la similitud es algo así como la similitud coseno.
Cuanto más similar sea el paciente a casos positivos vistos anteriormente, mayor será la puntuación.
¿Por qué esto funciona?
Las puntuaciones de similitud son naturalmente continuas y a menudo están bien estructuradas. La calidad de la recuperación tiende a seguir los patrones de enfermedades si el conjunto de ejemplos se elige cuidadosamente. El paso de puntuación existe incluso si la lógica del agente posterior toma sólo una decisión binaria.
Lo mejor para
Agentes de recuperación de generación aumentada (RAG). Sistemas que se basan explícitamente en prototipos. Situaciones en las que los componentes de incrustación y recuperación ya están bien ajustados.
Precaución
La similitud de recuperación puede captar sólo una parte del razonamiento que conduce a la decisión final. Los sesgos en el espacio de incrustación pueden distorsionar la distribución de la puntuación y deben controlarse.
Método 5. Entrenar un modelo de calibración además de los resultados del agente.
Concepto
Algunos sistemas agentes generan categorías estructuradas como riesgo bajo, medio o alto, o generan explicaciones que siguen una plantilla consistente. Estos resultados categóricos o estructurados se pueden convertir en puntuaciones continuas utilizando un pequeño modelo de calibración.
Por ejemplo:
Codifique categorías como características. Opcionalmente, incruste explicaciones textuales en vectores. Entrene la regresión logística, la regresión isotónica u otro modelo simple para asignar esas características a una probabilidad de riesgo.
El modelo de calibración aprende a asignar puntuaciones continuas en función de cómo se correlacionan los resultados del agente con las etiquetas verdaderas.
¿Por qué esto funciona?
Convierte resultados aproximados o discretos en partituras fluidas y utilizables. Puede mejorar la calibración alineando las puntuaciones con las frecuencias de resultados observadas. Está alineado con la práctica establecida, como la asignación de categorías BI-RADS al riesgo de cáncer de mama.
Lo mejor para
Agentes que generan categorías de riesgo, puntuaciones en escala interna o explicaciones estructuradas. Flujos de trabajo clínicos donde se necesitan probabilidades calibradas para apoyar la toma de decisiones o tomar decisiones compartidas. Configuraciones donde los datos de resultados etiquetados están disponibles para ajustar el modelo de calibración.
Precaución
Este enfoque introduce un segundo modelo que debe documentarse y mantenerse. Requiere suficientes datos etiquetados para entrenar y validar el paso de calibración.
Método 6. Barrer un umbral o configuración ajustable dentro del agente
Concepto
Algunos sistemas agentes exponen parámetros de configuración que controlan qué tan agresivos o conservadores son. Los ejemplos incluyen:
Un ajuste de sensibilidad o tolerancia al riesgo. El número de documentos recuperados. El número de pasos de razonamiento a realizar antes de tomar una decisión.
Si el agente permanece estrictamente binario en cada configuración, puede tratar el parámetro de configuración como un pseudo umbral:
Elija varios valores de parámetros que van desde conservadores hasta agresivos. Para cada valor, ejecute el agente en todos los pacientes y registre la sensibilidad y especificidad. Trace estos puntos operativos para formar una curva ROC aproximada. Calcule el área bajo esta curva como un AUC aproximado.
¿Por qué esto funciona?
Convierte un rígido sistema de decisión binaria en una colección de puntos operativos. La curva resultante se puede interpretar de manera similar a una curva ROC tradicional, aunque el eje x se controla indirectamente a través del parámetro de configuración en lugar de un umbral de puntuación directo. Recuerda al análisis de la curva de decisión, que también examina el desempeño en una variedad de umbrales de decisión.
Lo mejor para
Agentes basados en reglas o deterministas con parámetros de configuración ajustables. Sistemas donde las probabilidades y los logits son inaccesibles. Escenarios en los que le interesan las compensaciones entre sensibilidad y especificidad en diferentes modos de funcionamiento.
Precaución
El AUC resultante es aproximado y se basa en barridos de parámetros en lugar de umbrales de puntuación directos. La interpretación depende de comprender cómo el parámetro afecta la lógica de decisión subyacente.
Pensamientos finales
Los sistemas agentes se están volviendo fundamentales para la IA, incluidos los casos de uso médico, pero su tendencia a generar decisiones difíciles entra en conflicto con la forma en que tradicionalmente evaluamos los modelos de riesgo y detección. El AUC sigue siendo un punto de referencia estándar en muchos entornos clínicos y de investigación, y el AUC requiere puntuaciones continuas que permitan una clasificación significativa de los pacientes.
Los métodos descritos en esta publicación proporcionan formas prácticas de cerrar la brecha. Al extraer probabilidades logarítmicas, pedirle al agente probabilidades explícitas, usar muestreo repetido, explotar la similitud de recuperación, entrenar un modelo de calibración pequeño o umbrales de configuración amplios, podemos construir puntuaciones continuas que respeten el comportamiento interno del agente y aun así admitan comparaciones rigurosas basadas en AUC.
Esto mantiene las nuevas soluciones de agentes basadas en líneas de base establecidas y nos permite evaluarlas utilizando el mismo lenguaje y métodos que los médicos, estadísticos y revisores ya entienden. Con un AUC, realmente podemos evaluar si el sistema agente está agregando valor.
Recursos relevantes
Publicado originalmente en https://www.lambertleong.com el 20 de diciembre de 2025.