
Un LLM le presenta un valor incorrecto extraído de un documento como un hecho. Ese error cuesta caro, especialmente cuando se basan en él las decisiones. La API de extracción de datos de nutrientes aborda ese problema. Analiza archivos PDF, escaneos, imágenes y archivos de Office en JSON espacial o Markdown. Extraiga campos de mapas de un documento a su esquema JSON y divida, clasifique y forme puntos finales que proporcionan primitivas útiles para sus canalizaciones de documentos. Cada valor extraído está anclado a una página mediante un cuadro delimitador, una etiqueta de coincidencia y una puntuación de confianza. Nutrient (anteriormente PSPDFKit) ejecuta el mismo motor detrás de un servidor MCP, habilidad de agente, aplicación para Mac y SDK.
TL;DR
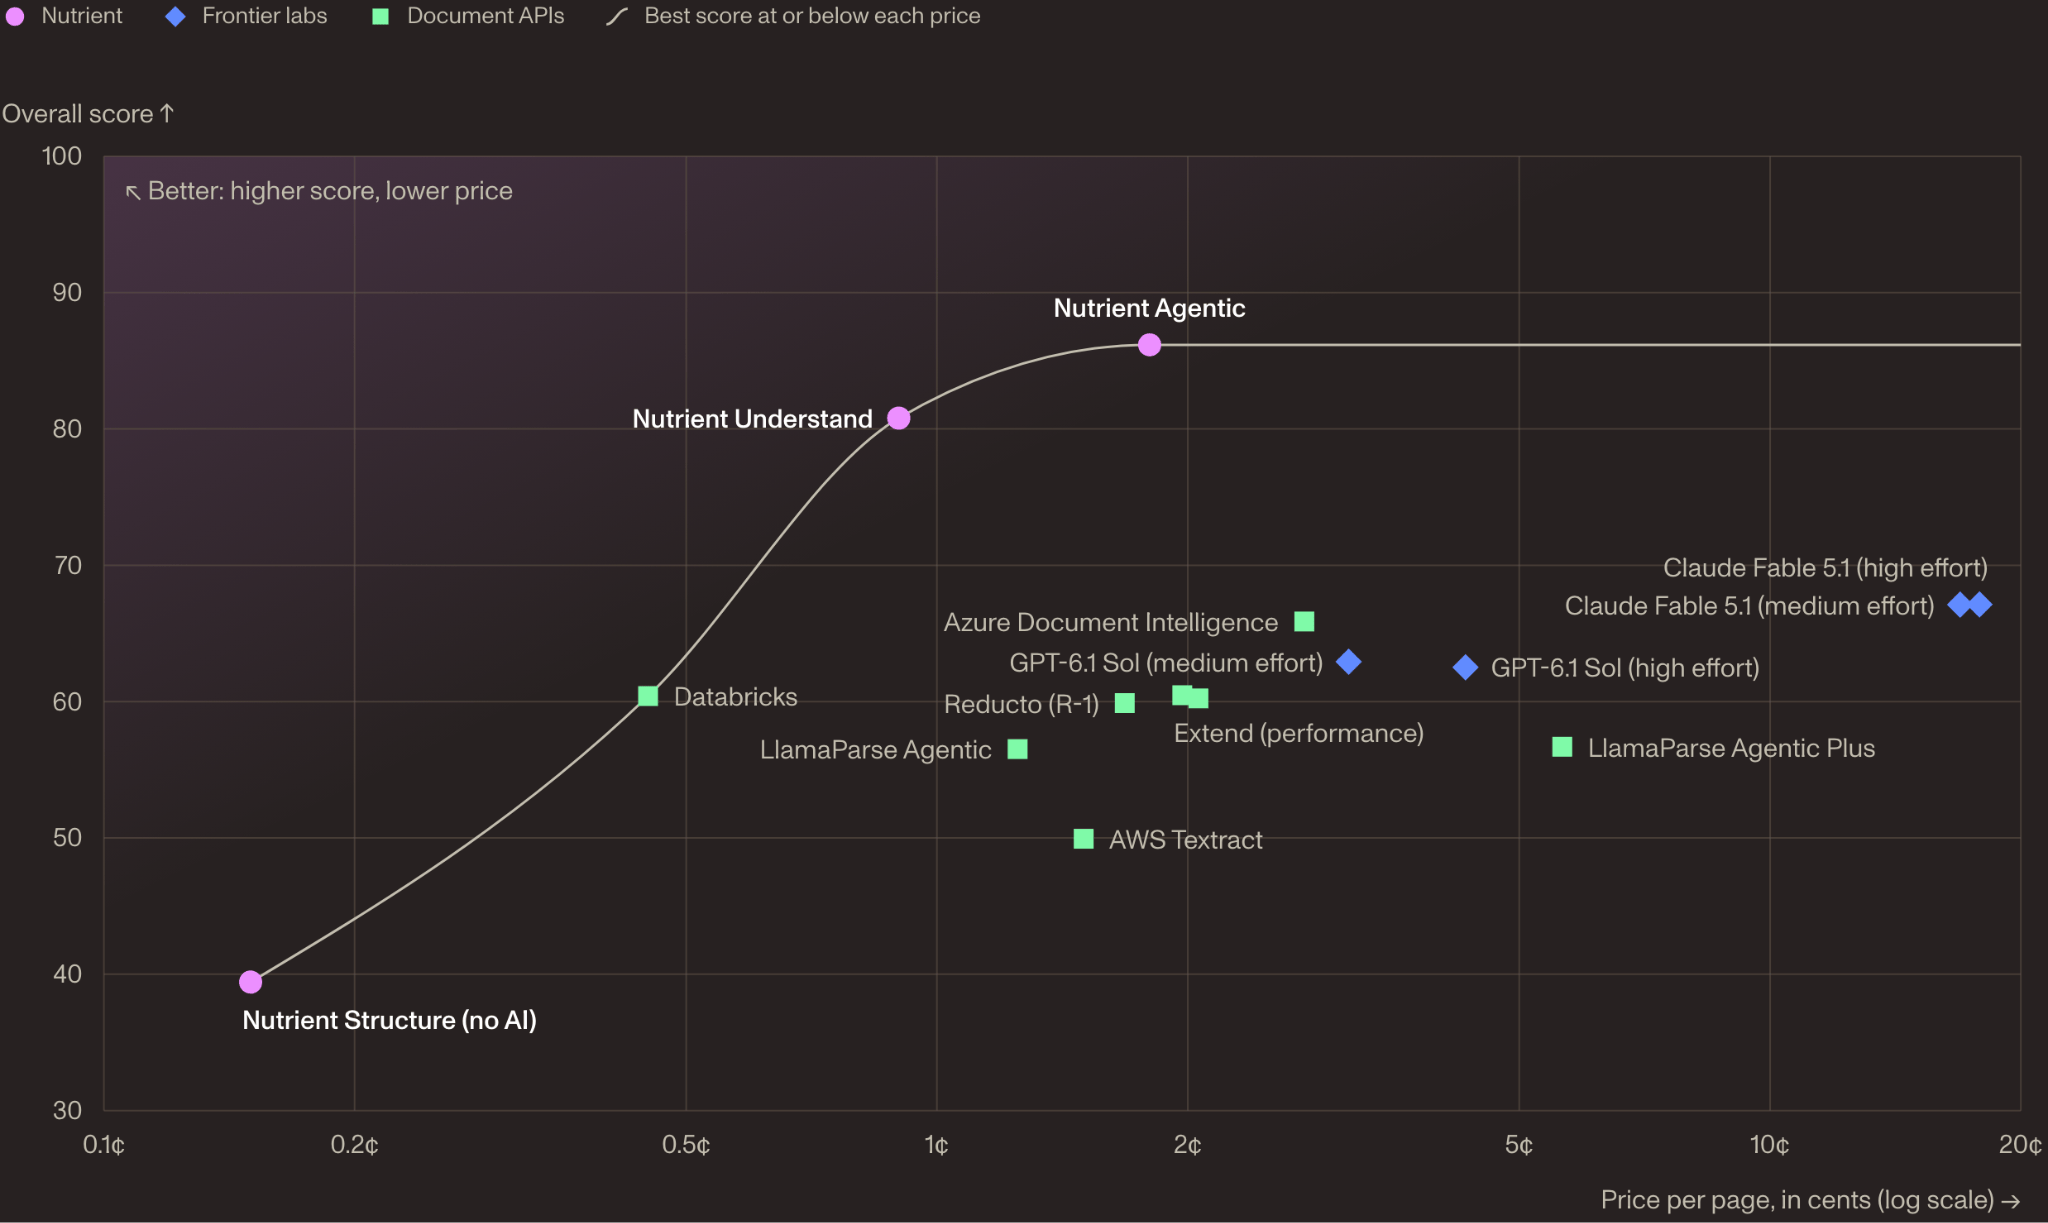
Tamaño: una API alojada con 4 modos de análisis más enrutamiento automático. Se ejecuta en: Nutrient Cloud, sus propios servidores a través de SDK o una Mac Apple Silicon. Dónde probarlo: Studio, un espacio de trabajo del navegador para configurar y probar el análisis, la extracción, la clasificación, la división y el llenado de formularios. Rendimiento: 86,2 en general en WholeDoc Bench de Nutrient, superior a 19 configuraciones (API en vivo, Agentic). Óptimo: 86,2 a 1,8 ¢ por página, frente a 67,1 a 17,8 ¢ para la mejor configuración del modelo de frontera.
¿Cómo se prueba en Studio antes de escribir código?
Studio es el espacio de trabajo del navegador de Nutrient para configurar y probar la API antes de integrarla en su aplicación. Le permite probar el análisis, la extracción, la clasificación, la división y el llenado de formularios en sus propios archivos. Un bucle típico:
Cargue un documento de muestra y establezca los parámetros que planea enviar. Redacte un esquema en la interfaz de usuario o genere uno basado en sus propios documentos. Ejecútelo en un documento nuevo, luego inspeccione los valores y las citas. Guarde la configuración como un ajuste preestablecido versionado. La API lo llama procesador, con un proc_ID. Califique versiones preestablecidas con hasta 25 documentos revisados en un conjunto de evaluación.
Luego, se puede llamar a los procesadores guardados en Studio desde la API mediante ID.
¿Qué modo deberías elegir?
Enruta automáticamente cada página para estructurarla, comprenderla o darle sentido. Si se omite el modo, la API lo entiende de forma predeterminada.
*Puntuación de análisis de WholeDoc Bench, 5 de noviembre de 2026; no precisión de extracción. El extracto agrega $0,006 por página. **Los documentos API enumeran extractos en modo texto; la habilidad del agente comienza en la estructura.
El precio está en dólares, a partir de 1 saldo compartido entre las API en la nube de Nutrient, para que los equipos puedan mezclar y combinar. El plan gratuito le ofrece un uso mensual de $5 que cubre alrededor de 330 extracciones en modo comprensión. El inicio cuesta $75 al mes por $90 de uso; El crecimiento cuesta $275 por $345.
¿Cómo funciona la confianza fundamentada?
En el puesto de confianza de Nutrient, un campo obtuvo una puntuación de 0,97 pero procedía de la columna equivocada.
La puntuación actual es una combinación de señales opcionales: probabilidad del token, margen del candidato, conexión a tierra y formato. El modelo de conexión a tierra NLI de Nutrient está abierto bajo Apache-2.0. Un valor fundamentado aún puede responder al campo incorrecto. Cuando no existe puntuación, se omite la confianza, no baja.
Cada campo también recibe una etiqueta de coincidencia: id_match, id_match_multiblock, id_match_partial, fuzzy_match o not_found. Primero la puerta a la etiqueta, luego la confianza.
import json, request API_KEY = “your_api_key” esquema = { “type”: “object”, “properties”: { “invoice_number”: {“type”: “string”, “description”: “Número de factura debajo de los detalles del proveedor.”}, “total_amount”: {“type”: “number”, “description”: “Total final impreso, incluidos los impuestos. No el subtotal.”}, }, “obligatorio”: [“invoice_number”, “total_amount”]} instrucciones = {“schema”: esquema, “parseConfig”: {“mode”: “understand”}, “options”: {“includeCitations”: True}} con open(“invoice.pdf”, “rb”) como f: r = request.post( “https://api.nutrient.io/extraction/extract”, headers={“Authorization”: f”Bearer {API_KEY}”}, files={“file”: (“factura.pdf”, f, “aplicación/pdf”), “instrucciones”: (Ninguna, json.dumps(instrucciones), “aplicación/json”)}, tiempo de espera=300, ) r.raise_for_status() out = r.json()[“output”]
datos, metadatos = out.get(“data”) o {}, out.get(“metadata”) o {} EXACTO = {“id_match”, “id_match_multiblock”} UMBRAL = 0,97 # solo ilustrativo; evaluar en documentos representativos para el campo en el esquema[“properties”]: # recorre los campos esperados para que ninguno omita la revisión value = data.get(field) meta = metadata.get(field) or {} match, conf = meta.get(“match”), meta.get(“confidence”) # Ninguno = no se pasa la puntuación = (el valor no es Ninguno y la coincidencia en EXACTO y conf no es Ninguno y conf >= UMBRAL) print(field, value, match, conf, “page”, meta.get(“pageNumber”), “PASSES_BASIC_CHECKS” si pasa, sino “REVIEW”)
Esta demostración cubre únicamente esquemas planos; la producción necesita comprobaciones de tipos y reglas de negocio. La barra de 0,97 refleja los campos de dinero en el tutorial de hipotecas de Nutrient.
¿Cómo funcionan clasificar y dividir?
Un modelo de decisión de documentos permite clasificar y dividir. Nutrient informa que el 96,2 % divide la F1 frente al 63,7 % de Jev de Typesafe AI.
¿Cómo lo usan los agentes?
El servidor MCP alojado no necesita clave API. Claude Code se conecta con 1 comando:
claude mcp agregar –transport http –scope usuario nutriente https://mcp.nutrient.io/mcp
Claude y Codex también funcionan mediante OAuth. El modo agente predeterminado cuesta $0,018 por página para analizar.
Los agentes codificadores pueden instalar la habilidad document-extraction-api con habilidades npx y agregar pspdfkit-labs/nutrient-skills –skill document-extraction-api.
¿Se puede ejecutar localmente?
En la aplicación para Mac, los documentos permanecen locales sólo con un modelo local. La producción totalmente fuera de línea necesita el SDK.
¿Cómo obtiene su puntuación en WholeDoc Bench?
El nuevo WholeDoc Bench de Nutrient califica documentos completos, no páginas individuales: 480 documentos, más de 30 idiomas, 7 áreas.
Filas seleccionadas, clasificación de WholeDoc, 5 de noviembre de 2026, precios de lista. *Puntuación aún bajo revisión.
La continuidad entre páginas es la brecha más grande. En 44 documentos con tablas que abarcaban varias páginas, 15 de 19 configuraciones rara vez los mantuvieron completos.
Nutrient lo construyó y ejecutó, y el conjunto de pruebas principal es privado. El código es Apache-2.0, con una muestra pública de 10 documentos.
Conclusiones clave
Los campos contienen páginas, regiones, etiquetas de coincidencia y, cuando están disponibles, confianza. Configure y pruebe en Studio antes de escribir cualquier código API. La extracción en modo comprensión cuesta 15 dólares por 1.000 páginas. Agentic encabeza el banco WholeDoc de Nutrient con 86,2 por 1,8 centavos por página. Los gráficos siguen siendo difíciles: 64,5 es la mejor puntuación en los gráficos de WholeDoc.
Consulte la API de extracción de datos, las pruebas comparativas, el servidor MCP y la habilidad del agente en GitHub.
Gracias al equipo de Nutrient AI por el liderazgo intelectual y los recursos para este artículo. Este artículo está patrocinado.
La publicación API de extracción de datos de nutrientes: JSON que coincide con su esquema con citas por campo y confianza apareció por primera vez en MarkTechPost.