
En el ámbito de la inteligencia artificial, los modelos multimodales grandes (LMM) han exhibido notables capacidades de resolución de problemas en diversas tareas, como la clasificación de imágenes/videos de toma cero, la recuperación de textos de imágenes/vídeos de toma cero y la respuesta a preguntas multimodales (QA, por sus siglas en inglés). ). Sin embargo, estudios recientes destacan una brecha sustancial entre los LMM potentes y la inteligencia artificial de nivel experto, particularmente en tareas que involucran percepción y razonamiento complejos con conocimiento de un dominio específico. Este documento tiene como objetivo cerrar esta brecha presentando CMMMU, un punto de referencia chino pionero meticulosamente diseñado para evaluar el desempeño de los LMM en una amplia gama de tareas multidisciplinarias, guiando el desarrollo de LMM bilingües hacia el logro de una inteligencia artificial de nivel experto.
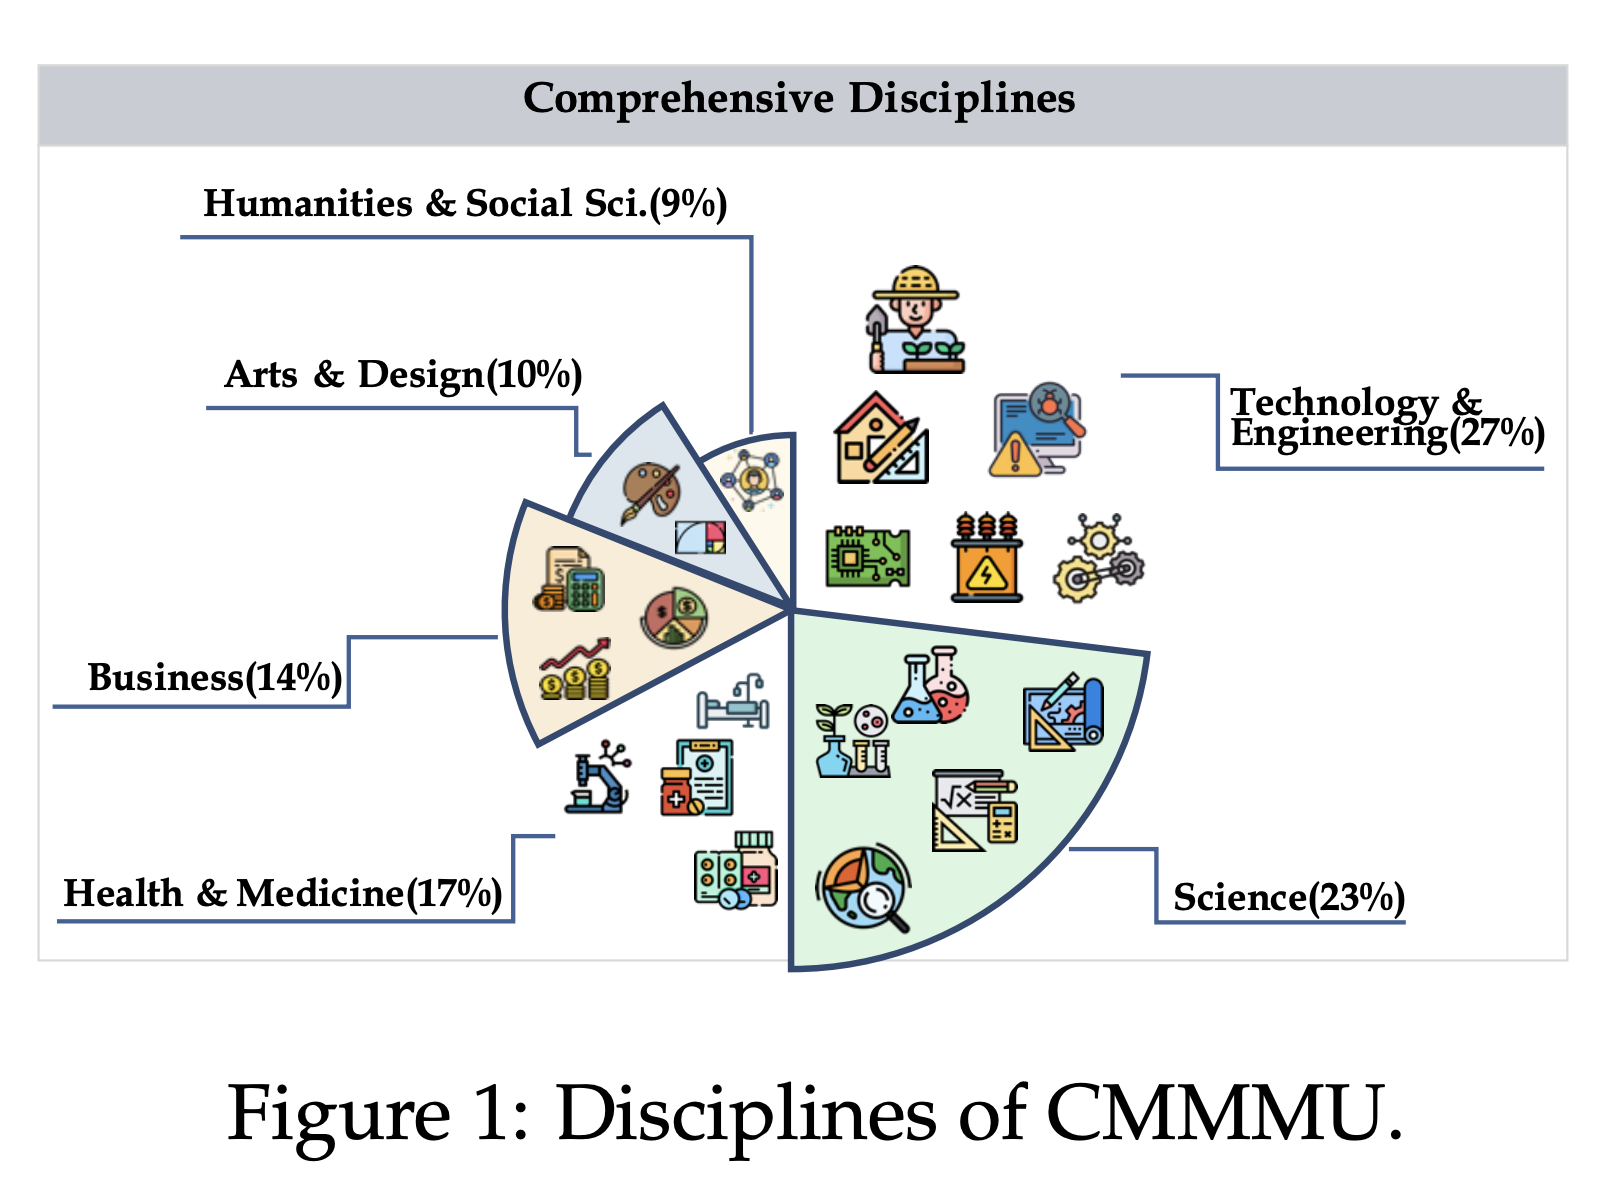
CMMU (Cchino METROasivo METROultidisciplina METROultimodal Ud.comprensión) se destaca como uno de los puntos de referencia más completos (algunos ejemplos se muestran en la Figura 2), que comprende 12.000 preguntas multimodales en chino recopiladas manualmente procedentes de exámenes universitarios, cuestionarios y libros de texto. Estas preguntas abarcan seis disciplinas básicas: Arte y diseño, Negocios, Ciencia, Salud y medicina, Humanidades y ciencias sociales y Tecnología e ingeniería. Otras estadísticas se muestran en la Tabla 2. El punto de referencia no solo evalúa los LMM en tareas complejas de razonamiento y percepción, sino que también anota cada pregunta con subcampos detallados y tipos de imágenes, lo que proporciona información valiosa sobre los tipos de preguntas que plantean desafíos para los LMM.
Un proceso de recopilación de datos de tres etapas garantiza la riqueza y diversidad de CMMMU. En el primera etapa, los organizadores anotadores, principalmente los autores, recopilan fuentes que cumplen con los requisitos de licencia. En el Segunda etapa, los anotadores de crowdsourcing, formados por estudiantes universitarios y personas con títulos superiores, anotan aún más las fuentes recopiladas, siguiendo estrictamente principios clave para filtrar preguntas no calificadas con imágenes. El tercera etapa Implica complementar preguntas sobre temas que necesitan más representación, asegurando un conjunto de datos equilibrado entre disciplinas.
Se implementa un riguroso protocolo de control de calidad de los datos para mejorar aún más la calidad de los datos. Al menos uno de los autores del artículo verifica manualmente cada pregunta, filtrando las preguntas con respuestas que son demasiado difíciles de extraer para los LMM. Además, las preguntas que no cumplen con los estándares de los exámenes de nivel universitario se eliminan meticulosamente. Para abordar los problemas de contaminación de datos, se filtran las preguntas que pueden resolverse correctamente con varios LMM avanzados simultáneamente sin ayuda de OCR.
La evaluación incluye grandes modelos de lenguaje (LLM) y grandes modelos multimodales (LMM), considerando implementaciones tanto de código cerrado como de código abierto. La configuración de evaluación de disparo cero se utiliza en lugar de configuraciones de ajuste fino o de pocos disparos porque proporciona una evaluación sin procesar de la capacidad del modelo para generar respuestas precisas en tareas multimodales. Un proceso de evaluación sistemático y basado en reglas, que incorpora expresiones regulares sólidas y reglas específicas para diferentes tipos de preguntas, garantiza una evaluación integral. Finalmente, han adoptado la precisión micropromedio como métrica de evaluación.
Además, el artículo también presenta un análisis de errores exhaustivo de 300 muestras, que muestra casos en los que incluso los LMM de mejor rendimiento, como QwenVL-Plus y GPT-4V, responden incorrectamente. El análisis, distribuido entre 30 sujetos, destaca los desafíos que desvían a los LMM avanzados y subraya el largo camino por recorrer para lograr LMM bilingües de nivel experto. Incluso los LMM de código cerrado más avanzados, GPT-4V y Qwen-VL-Plus, solo logran 42% y 36% precisión, respectivamente, lo que indica un margen significativo de mejora.
Curiosamente, el estudio revela una brecha de rendimiento menor entre los LMM de código abierto y de código cerrado en un contexto chino en comparación con el inglés. Mientras que el LMM de código abierto más potente, Qwen-VL-Chat, logra una precisión del 28%, con una diferencia del 14% en comparación con GPT-4V, la diferencia en inglés es del 21%. En particular, Yi-VL-6B1, Yi-VL-34B2 y Qwen-VL-Chat superan a otros LMM de código abierto en CMMMU, lo que enfatiza su potencial en el dominio del idioma chino. Yi-VL-34B incluso reduce la brecha de rendimiento entre los LMM de código abierto y GPT-4V en CMMMU al 7%.
En conclusión, el punto de referencia CMMMU representa un avance significativo en la búsqueda de Inteligencia General Avanzada (AGI). Sirve como un evaluador meticuloso de los últimos modelos multimodales grandes (LMM), midiendo sus habilidades de percepción elemental, su intrincado razonamiento lógico y su profunda experiencia en un dominio específico. Al comparar el desempeño de los LMM en CMMMU y MMMU, esta investigación proporciona información sobre la capacidad de razonamiento de los LMM bilingües en contextos chino e inglés, allanando el camino para una AGI que rivaliza con los profesionales experimentados en diversos campos.
Revisar la Papel y Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 36k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas
Vineet Kumar es pasante de consultoría en MarktechPost. Actualmente está cursando su licenciatura en el Instituto Indio de Tecnología (IIT), Kanpur. Es un entusiasta del aprendizaje automático. Le apasiona la investigación y los últimos avances en Deep Learning, Computer Vision y campos relacionados.