
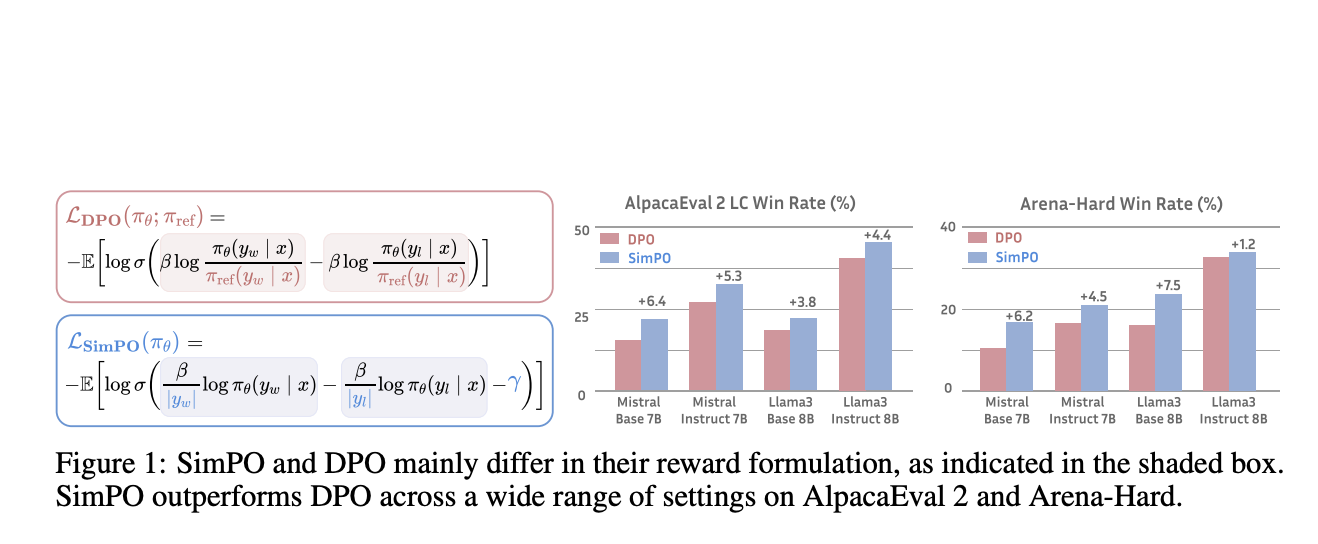
La inteligencia artificial evoluciona continuamente y se centra en la optimización de algoritmos para mejorar el rendimiento y la eficiencia de los modelos de lenguajes grandes (LLM). El aprendizaje reforzado a partir de la retroalimentación humana (RLHF) es un área importante dentro de este campo, cuyo objetivo es alinear los modelos de IA con los valores e intenciones humanos para garantizar que sean útiles, honestos y seguros.
Uno de los principales desafíos de RLHF es optimizar las funciones de recompensa utilizadas en el aprendizaje por refuerzo. Los métodos tradicionales implican procesos complejos de varias etapas que requieren importantes recursos computacionales y pueden conducir a un rendimiento subóptimo debido a discrepancias entre el entrenamiento y las métricas de inferencia. Estos procesos a menudo incluyen el entrenamiento de un modelo de recompensa por separado del modelo de políticas, lo que puede introducir ineficiencias y posibles desajustes en los objetivos de optimización.
Las investigaciones existentes incluyen la optimización de preferencias directas (DPO), que reparametriza las funciones de recompensa en RLHF para simplificar los procesos y mejorar la estabilidad. DPO elimina la necesidad de modelos de recompensa explícitos, pero aún requiere un modelo de referencia, lo que agrega una sobrecarga computacional. Otros métodos incluyen IPO, KTO y ORPO, que ofrecen variaciones en el manejo y optimización de datos de preferencias sin modelos de referencia. Estos enfoques tienen como objetivo optimizar RLHF abordando las complejidades e ineficiencias inherentes a los métodos tradicionales, proporcionando soluciones más eficientes y escalables para alinear grandes modelos de lenguaje con la retroalimentación humana.
Investigadores de la Universidad de Virginia y la Universidad de Princeton han presentado SimPO, un enfoque más simple y eficaz para la optimización de preferencias. SimPO utiliza la probabilidad logarítmica promedio de una secuencia como recompensa implícita, alineándose mejor con la generación del modelo y eliminando la necesidad de un modelo de referencia. Esto hace que SimPO sea más eficiente en computación y memoria. SimPO está diseñado para alinear directamente la función de recompensa con la probabilidad de generación, eliminando discrepancias entre las métricas de entrenamiento e inferencia. El método también incorpora un margen de recompensa objetivo para garantizar una diferencia significativa entre las respuestas ganadoras y perdedoras, lo que mejora la estabilidad del desempeño.
La principal innovación de SimPO es utilizar una recompensa de longitud normalizada, calculada como la probabilidad logarítmica promedio de todos los tokens en una respuesta. Este enfoque garantiza que la recompensa se alinee con la métrica de generación, lo que mejora el rendimiento del modelo. Además, SimPO introduce un margen de recompensa objetivo al objetivo Bradley-Terry para fomentar un margen mayor entre las respuestas ganadoras y perdedoras. Este margen es crucial ya que promueve la generación de secuencias de mayor calidad sin explotar la longitud de la respuesta, un problema común en modelos anteriores. El equipo de investigación ajustó meticulosamente los parámetros para un rendimiento óptimo en todas las configuraciones de entrenamiento, incluidos los modelos básicos y ajustados a las instrucciones como Mistral y Llama3.
SimPO supera significativamente a DPO y sus últimas variantes en varias configuraciones de entrenamiento, incluidos los modelos básicos y ajustados a instrucciones. En el punto de referencia AlpacaEval 2, SimPO superó a DPO hasta en 6,4 puntos, lo que demuestra una mejora sustancial en la generación de respuestas precisas y relevantes. SimPO mostró un desempeño aún más impresionante en el desafiante punto de referencia Arena-Hard, superando a DPO por hasta 7,5 puntos. El modelo de alto rendimiento, construido sobre Llama3-8B-Instruct, logró una notable tasa de victorias con longitud controlada del 44,7% en AlpacaEval 2, superando a Claude 3 Opus en la clasificación, y una tasa de victorias del 33,8% en Arena-Hard, convirtiéndolo en el El modelo 8B de código abierto más potente hasta la fecha. Estos resultados resaltan la solidez y eficacia de SimPO en diversos entornos y puntos de referencia.
La practicidad de SimPO es una ventaja clave. Utiliza datos de preferencias de manera más efectiva, lo que genera una clasificación de probabilidad más precisa de las respuestas ganadoras y perdedoras en un conjunto de validación retenido. Esto se traduce en un mejor modelo de políticas, capaz de generar respuestas de alta calidad de manera consistente. La eficiencia de SimPO también se extiende a sus requisitos computacionales, lo que reduce la necesidad de una gran cantidad de memoria y recursos computacionales típicamente asociados con los modelos de referencia. Esto hace que SimPO no solo sea una solución poderosa sino también práctica para el entrenamiento e implementación de modelos a gran escala, brindando tranquilidad sobre su viabilidad y aplicabilidad en escenarios del mundo real.
En conclusión, SimPO representa un avance significativo en la optimización de preferencias para RLHF, ya que ofrece un método más simple y eficiente que ofrece consistentemente un rendimiento superior. Al eliminar la necesidad de un modelo de referencia y alinear la función de recompensa con la métrica de generación, SimPO aborda desafíos clave en el campo, proporcionando una solución sólida para mejorar la calidad de modelos de lenguaje grandes. La introducción de un margen de recompensa objetivo garantiza aún más que las respuestas generadas no solo sean relevantes sino también de alta calidad, lo que convierte a SimPO en una herramienta valiosa para futuros desarrollos de IA.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 43k+ ML | Además, consulte nuestro Plataforma de eventos de IA
Nikhil es consultor interno en Marktechpost. Está cursando una doble titulación integrada en Materiales en el Instituto Indio de Tecnología de Kharagpur. Nikhil es un entusiasta de la IA/ML que siempre está investigando aplicaciones en campos como los biomateriales y la ciencia biomédica. Con una sólida formación en ciencia de materiales, está explorando nuevos avances y creando oportunidades para contribuir.