
Se utiliza un gran corpus de documentos de texto que contienen miles de millones de tokens de texto para entrenar modelos de lenguaje grandes (LLM). Se ha demostrado que el rendimiento en tareas como el control de calidad a libro cerrado mejora la precisión a medida que aumenta el número de parámetros del modelo, y los modelos más grandes pueden producir declaraciones fácticas más precisas. Incluso los modelos más grandes, que aparecen relativamente raramente en el corpus de entrenamiento, pueden fallar, particularmente en hechos menos conocidos de distribución del torso y la cola. Cuando el modelo tiene fallas, producen una respuesta alternativa que generalmente parece realista.
Más allá de solo predecir las palabras futuras, la ola más reciente de investigación sobre modelos del lenguaje se ha concentrado en qué tan bien pueden razonar. Alentar a los modelos de lenguaje a construir primero pensamientos internos o cadenas de razonamiento antes de responder y cambiar su respuesta original mediante la autocrítica puede conducir a un mejor desempeño en los desafíos de razonamiento.
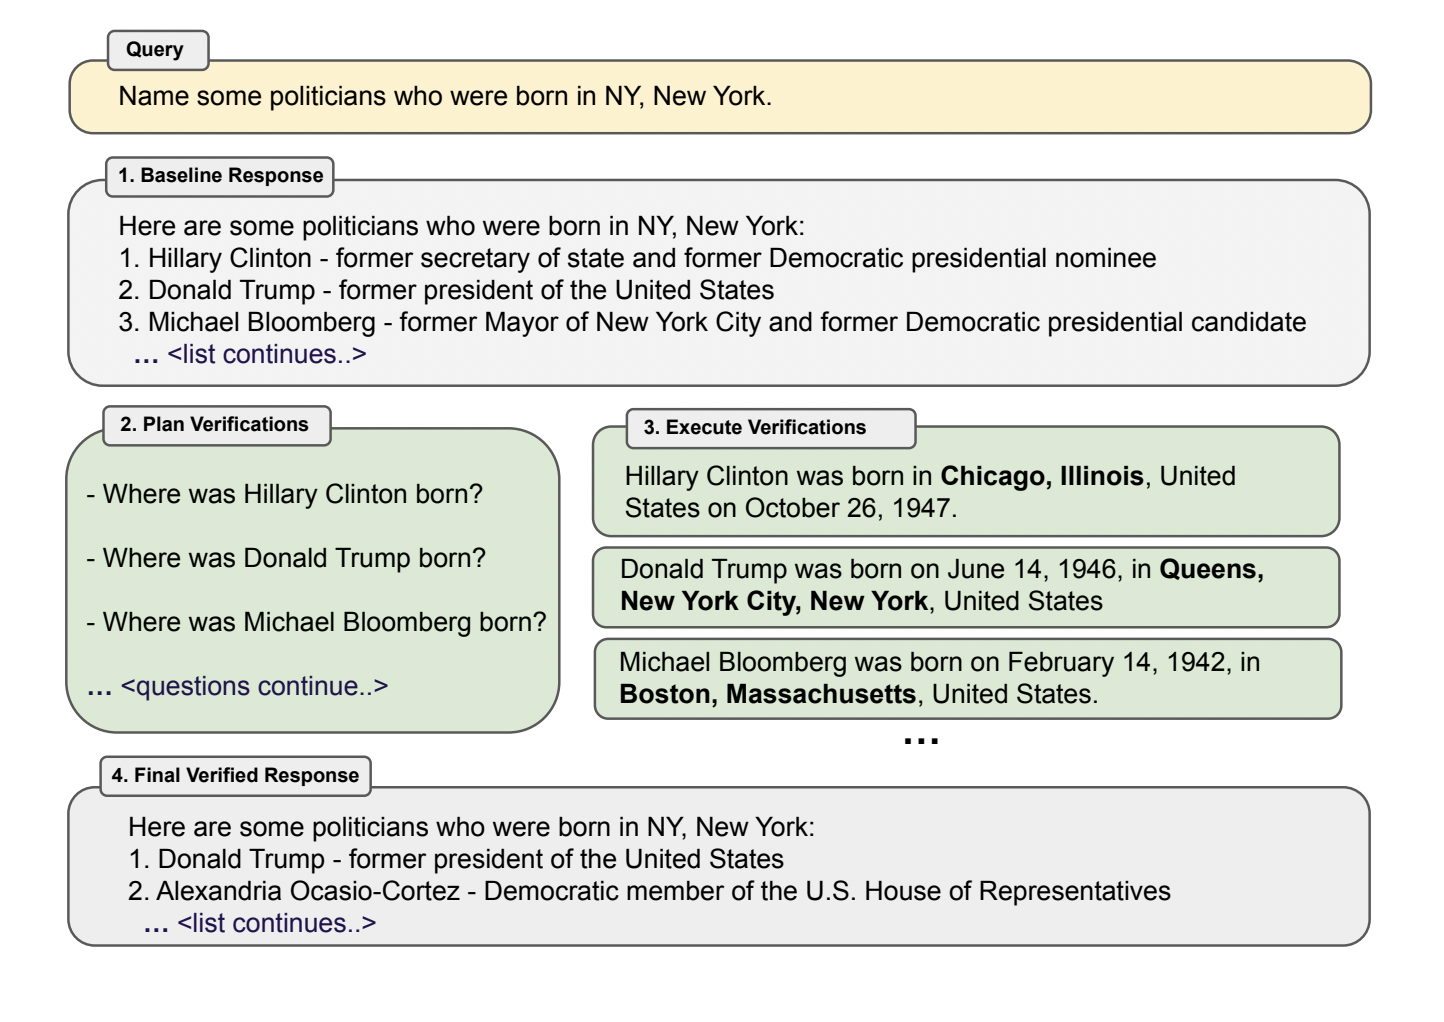
En el trabajo presentado aquí, investigadores de Meta AI y ETH Zurich investigan cómo y cuándo se puede aplicar el razonamiento basado en modelos de lenguaje para disminuir las alucinaciones. Crean un método conocido como Cadena de Verificación (CoVe), en el que, dado un borrador de respuesta inicial, primero planifican preguntas de verificación para evaluar su efectividad y luego responden metódicamente a esas preguntas para, en última instancia, generar una respuesta mejor modificada. El estudio muestra que los datos proporcionados por las preguntas de verificación independientes suelen ser más precisos que los de la respuesta larga inicial, lo que aumenta la precisión de la respuesta completa.
El equipo explora variaciones de esta fórmula para diversas actividades, incluidas consultas basadas en listas, control de calidad a libro cerrado y la creación de contenido de formato largo. Como alternativa al modelo de lenguaje básico, primero proporcionan un método combinado para crear la cadena de verificación completa de izquierda a derecha, lo que mejora el rendimiento y reduce las alucinaciones. Por otro lado, los modelos que prestan atención a las alucinaciones actuales en el contexto de sus generaciones a menudo repiten las alucinaciones.
Los investigadores introducen variaciones factorizadas para optimizar las etapas de la cadena de verificación según la situación. Los resultados demuestran cómo estas variaciones factorizadas mejoran aún más el rendimiento en las tres tareas consideradas.
El equipo también demostró que evitar que el modelo preste atención a sus respuestas anteriores mientras responde a las preguntas de verificación (CoVe factorizado) reduce la probabilidad de repetir las mismas alucinaciones. En general, este enfoque ofrece mejoras significativas en el rendimiento con respecto a la respuesta del modelo de lenguaje original simplemente pidiendo al mismo modelo que piense (verifique) su respuesta. Dotar a CoVe de la capacidad de aplicar herramientas, como el aumento de la recuperación en el paso de ejecución de la verificación, es una extensión lógica de esta investigación que, sin duda, generaría más ventajas.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de más de 30.000 ml, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Dhanshree Shenwai es ingeniero en informática y tiene una buena experiencia en empresas de tecnología financiera que cubren el ámbito financiero, tarjetas y pagos y banca con un gran interés en las aplicaciones de IA. Le entusiasma explorar nuevas tecnologías y avances en el mundo en evolución de hoy que facilita la vida de todos.