
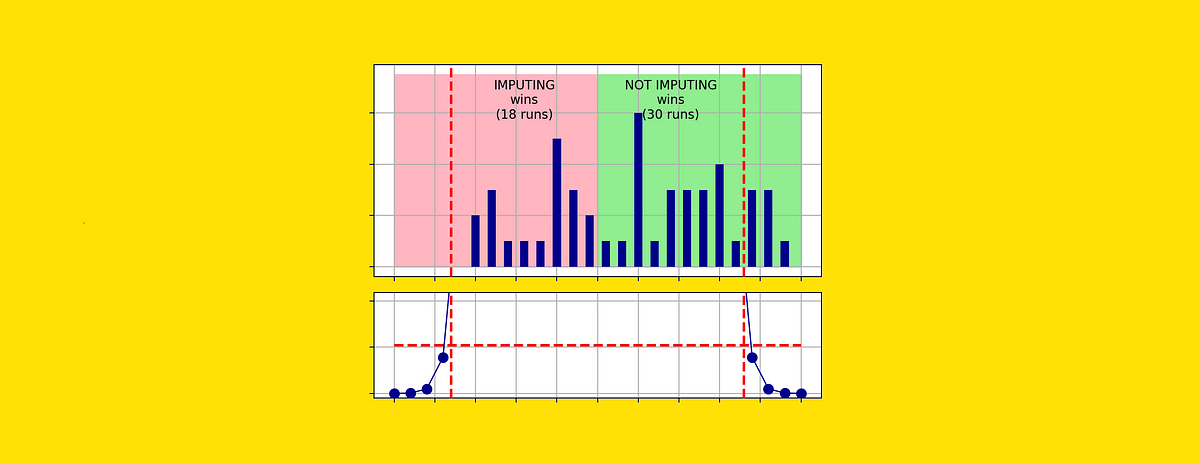
Los valores faltantes son muy comunes en conjuntos de datos reales. Con el tiempo, se han propuesto muchos métodos para abordar este problema. Generalmente consisten en eliminar datos que contienen valores faltantes o en imputarlos con algunas técnicas.
En este artículo, probaré una tercera alternativa:
Haciendo nada.
De hecho, los mejores modelos para conjuntos de datos tabulares (es decir, XGBoost, LightGBM y CatBoost) pueden manejar de forma nativa los valores faltantes. Entonces, la pregunta que intentaré responder es:
¿Pueden estos modelos manejar eficazmente los valores faltantes o obtendríamos un mejor resultado con una imputación preliminar?
Parece haber una creencia generalizada de que debemos hacer algo sobre valores perdidos. Por ejemplo, le pregunté a ChatGPT qué debo hacer si mi conjunto de datos contiene valores faltantes y me sugirió 10 formas diferentes de deshacerme de ellos (puedes leer la respuesta completa). aquí).
¿Pero de dónde viene esta creencia?
Por lo general, este tipo de opiniones se originan a partir de modelos históricos, particularmente de regresión lineal. Éste también es el caso. Veamos por qué.
Supongamos que tenemos este conjunto de datos:
Si intentáramos entrenar una regresión lineal sobre estas características, obtendríamos un error. De hecho, para poder hacer predicciones, la regresión lineal necesita multiplicar cada característica por un coeficiente numérico. Si faltan una o más funciones, es imposible hacer una predicción para esa fila.
Por este motivo se han propuesto muchos métodos de imputación. Por ejemplo, una de las posibilidades más simples es reemplazar los valores nulos con la media de la característica.