
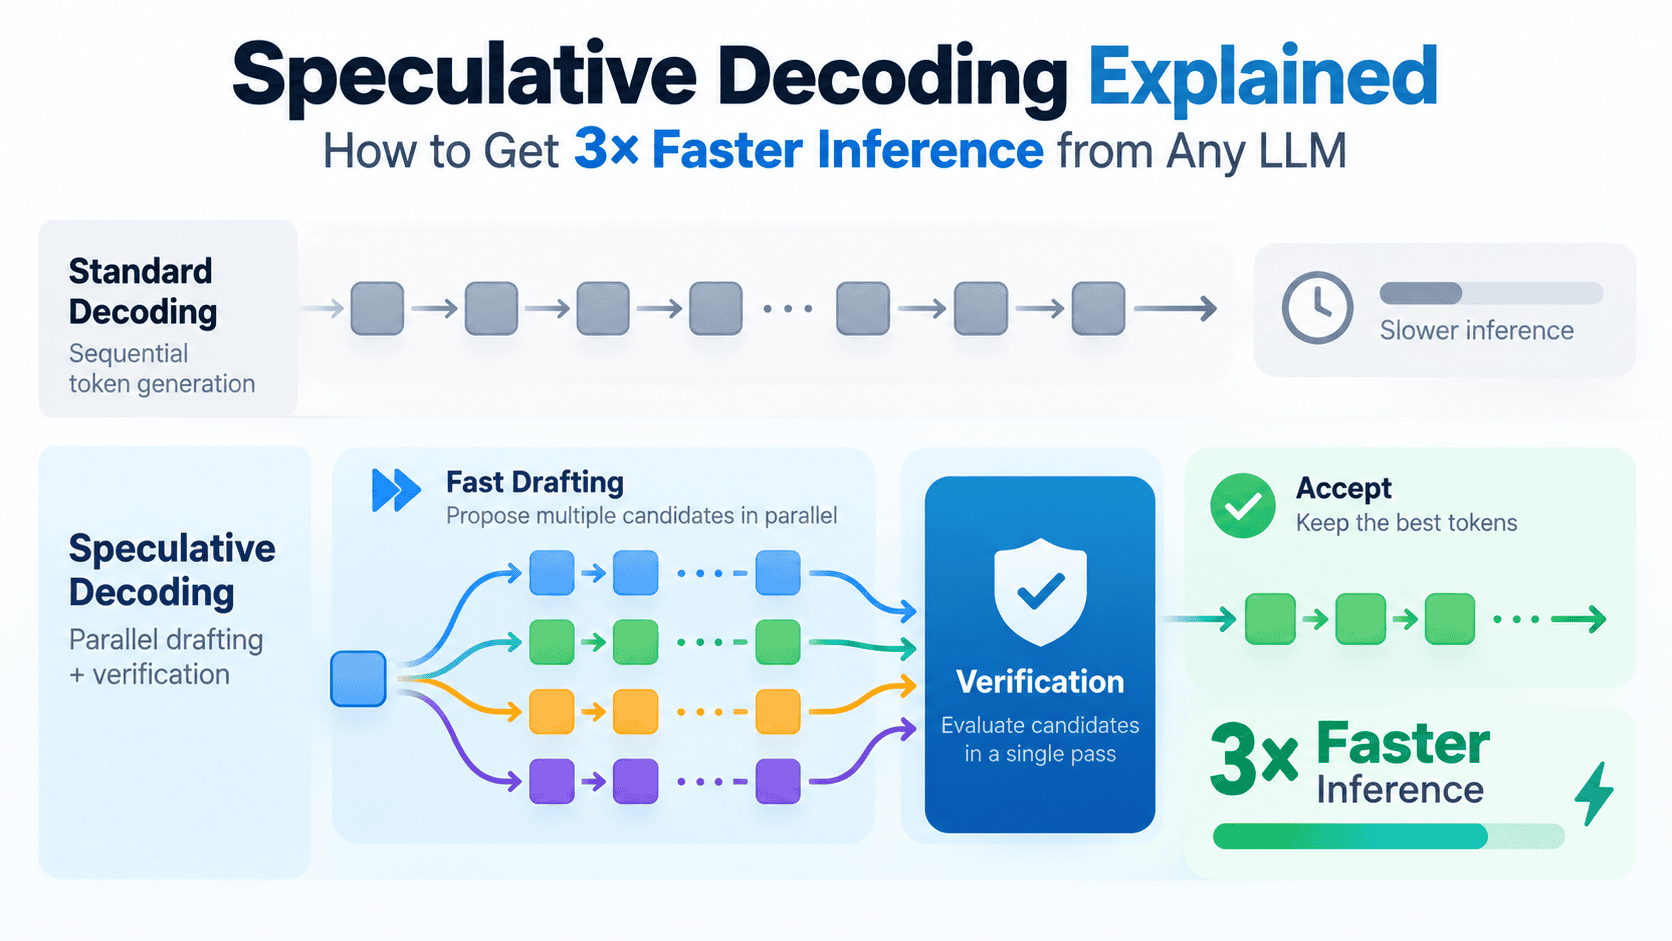
En este artículo, aprenderá cómo funciona la decodificación especulativa, por qué produce ganancias de velocidad reales a nivel de hardware y cómo se ven las implementaciones modernas en la práctica.
Los temas que cubriremos incluyen:
El cuello de botella del ancho de banda de la memoria central que ralentiza la generación de tokens autorregresivos estándar. Cómo funciona el ciclo de redacción y verificación y por qué conserva exactamente la distribución de salida del modelo de destino. Variantes modernas de decodificación especulativa, incluidas Medusa, Eagle y Prompt Lookup Decoding, y las compensaciones prácticas que implica habilitar la técnica en producción.
Introducción
Cada vez que envía un mensaje a un chatbot de IA, el modelo genera su respuesta un token a la vez. Esa única restricción es una de las barreras más importantes para implementar grandes modelos lingüísticos a escala. A medida que los modelos crecen y se vuelven más capaces, el tiempo que lleva producir cada token se convierte en un problema real, especialmente para aplicaciones que exigen retroalimentación instantánea como asistentes de codificación, robots de servicio al cliente y agentes en tiempo real.
La decodificación especulativa evita este problema sin cambiar el modelo, volver a capacitarse con nuevos datos o sacrificar la calidad de la salida. Logra una inferencia entre 2 y 3 veces más rápida simplemente mediante una estrategia de generación más inteligente. Este artículo analiza cómo funciona, por qué es más rápido a nivel de hardware y cómo se ven las implementaciones modernas en la práctica.
El problema central: los LLM generan un token a la vez
Los modelos de lenguaje grandes generan texto de forma autorregresiva. El modelo lee todos los tokens anteriores, realiza un cálculo completo de sus miles de millones de parámetros y produce exactamente un token nuevo. Luego hace todo nuevamente para el siguiente token, y así sucesivamente, hasta que se completa la respuesta.
El cuello de botella no es la velocidad de cálculo bruta. El hardware de IA moderno, como las GPU NVIDIA H100, es extraordinariamente rápido en los tipos de matemáticas matriciales que impulsan estos modelos. El problema es que los miles de millones de parámetros del modelo se almacenan en la memoria de la GPU y antes de que se pueda generar cada token, todos esos pesos deben transferirse de la memoria al procesador. Esta transferencia de datos es la restricción real, no el cálculo en sí.
Generar un token a la vez significa que la GPU espera repetidamente transferencias de memoria mientras sus unidades de cómputo permanecen inactivas. Los ingenieros llaman a esto estar limitado por el ancho de banda de la memoria. Agregar más computación sin procesar a un servidor no acelera significativamente las cosas, porque el factor limitante es la rapidez con la que se pueden mover los datos, no la rapidez con la que se pueden procesar.
Qué hace la decodificación especulativa de manera diferente
La idea central es sencilla: en lugar de generar tokens uno a la vez, genere un lote de tokens candidatos a la vez y verifíquelos en paralelo.
Esto funciona a través de un sistema de dos modelos. Un modelo pequeño y liviano llamado modelo borrador genera rápidamente una secuencia de tokens candidatos. Estas conjeturas son rápidas y económicas de producir porque el modelo preliminar tiene muchos menos parámetros que el modelo principal. Todavía genera tokens de forma autorregresiva, sólo que mucho más rápido debido a su tamaño más pequeño.
El modelo grande y de alta calidad llamado modelo objetivo luego evalúa todos esos tokens candidatos en una sola pasada. Debido a que las GPU modernas están diseñadas para computación paralela, procesar un lote de tokens lleva sólo un poco más de tiempo que procesar uno solo. El modelo objetivo verifica cada candidato y lo acepta o rechaza basándose en una comparación probabilística con sus propias predicciones.
Este proceso sigue un método estadístico que proporciona una garantía matemática: el resultado final tiene exactamente la misma distribución de probabilidad que si el modelo objetivo hubiera generado cada token por sí solo. La calidad de salida no es aproximada. Es demostrablemente idéntico.
Caminando por el circuito especulativo
El borrador del modelo genera una secuencia corta, normalmente de cuatro a ocho tokens candidatos, muy rápidamente. Estos representan su mejor suposición sobre lo que diría a continuación el modelo objetivo.
Luego, el modelo objetivo toma esa secuencia completa y la califica en una operación por lotes. En lugar de cargar sus miles de millones de parámetros en el procesador una vez por token, el modelo objetivo los carga una vez y evalúa toda la secuencia candidata en conjunto.
A partir del primer candidato, el modelo objetivo compara la probabilidad de que considere ese token con la probabilidad de que lo considere el modelo preliminar. Si el modelo objetivo tiene al menos tanta confianza como el modelo preliminar, el token se acepta automáticamente. Si el modelo preliminar tenía más confianza, el token se acepta con una probabilidad que disminuye a medida que crece la brecha. Cuando se rechaza un token, se toma una muestra de un token corregido a partir de una distribución ajustada que tiene en cuenta la diferencia entre las predicciones de los dos modelos. Este ajuste es precisamente lo que garantiza que el resultado final coincida exactamente con la distribución del modelo objetivo, y el ciclo comienza nuevamente a partir de ahí.
En el mejor de los casos, se aceptan todos los tokens candidatos y, además, el modelo objetivo produce un token adicional al final. Esto significa que el sistema generó de cinco a nueve tokens por aproximadamente el costo de un pase de modelo objetivo. En el peor de los casos, el primer borrador del token se rechaza y se reemplaza, lo que en realidad agrega una ligera sobrecarga en comparación con la decodificación estándar, ya que aún se paga el tiempo de generación del borrador del modelo. La calidad de la producción se mantiene intacta en cualquier caso, pero los profesionales deben ser conscientes de que la desventaja de un par de modelos mal emparejados es una pequeña desaceleración, no sólo un resultado neutral.
Por qué esto se traduce en ganancias de velocidad reales
En la generación estándar, cargar los pesos del modelo objetivo desde la memoria domina el presupuesto de tiempo. Cada token desencadena otra costosa lectura de memoria, lo que deja a las unidades informáticas en espera.
Con la decodificación especulativa, los pesos del modelo objetivo se cargan una vez por paso especulativo y luego se aplican en múltiples tokens aceptados. La capacidad de computación paralela de la GPU puede realizar un trabajo significativo en toda la secuencia candidata a la vez, en lugar de permanecer inactiva entre lecturas de tokens individuales.
La aceleración real depende principalmente de la tasa de aceptación, es decir, de la frecuencia con la que los candidatos del modelo borrador pasan la verificación del modelo objetivo. Cuando las tasas de aceptación se sitúan entre el 70 y el 80 por ciento, lo cual es típico de pares de modelos bien coincidentes en tareas comunes, la aceleración en el mundo real se sitúa entre 2x y 3x. Las tareas que involucran texto predecible o repetitivo tienden a producir tasas de aceptación aún más altas y mayores ganancias.
Enfoques modernos: más allá de la configuración de dos modelos
La formulación original requiere mantener un modelo borrador separado junto con el modelo de destino, lo que agrega memoria y gastos generales de ingeniería. Varias técnicas más nuevas preservan la idea central y al mismo tiempo eliminan la necesidad de un modelo preliminar independiente. Vale la pena señalar: algunos de estos enfoques cambian la estricta garantía distributiva del método original por una implementación más simple o un mayor rendimiento, aunque el impacto práctico en la calidad de la producción es generalmente insignificante.
Medusa modifica el modelo objetivo adjuntando múltiples cabezales de predicción adicionales directamente a su capa final. Cada cabeza predice de forma independiente una posición futura diferente del token, por lo que el modelo objetivo redacta efectivamente sus propias secuencias candidatas sin ningún modelo externo.
Eagle (algoritmo de extrapolación para una mayor eficiencia del modelo de lenguaje) predice tokens futuros basándose en los estados ocultos internos del modelo objetivo en lugar de sus tokens de salida final. Los estados ocultos contienen información contextual más rica, lo que tiende a producir tasas de aceptación más altas en textos complejos o de dominios específicos.
La decodificación de búsqueda rápida no requiere ningún modelo secundario. Explora el historial de mensajes y conversaciones existente en busca de frases que probablemente se repitan en la respuesta y las utiliza directamente como borradores de candidatos. Este enfoque funciona especialmente bien para la edición de código y el resumen de documentos, donde la salida frecuentemente refleja el vocabulario y la estructura de la entrada.
Qué significa esto para los profesionales
La decodificación especulativa está disponible como una opción incorporada en marcos de inferencia como la inferencia de generación de texto de Hugging Face, vLLM y llama.cpp. Para la mayoría de los profesionales, habilitarlo es un cambio de configuración más que un proyecto de investigación.
La técnica es más beneficiosa cuando se generan resultados más largos, cuando el modelo atiende una solicitud a la vez en lugar de lotes grandes, y cuando el mensaje y la respuesta comparten vocabulario o estructura. La respuesta a preguntas, el resumen de documentos y la finalización de códigos tienden a obtener los mayores beneficios. El servicio por lotes de alto rendimiento es una historia diferente: en entornos con muchos lotes, la decodificación especulativa en realidad puede perjudicar el rendimiento porque los tokens borrador consumen memoria y computación que, de otro modo, podrían atender solicitudes adicionales. Tenga en cuenta esa compensación al elegir si habilitarlo en producción.
Conclusión
La decodificación especulativa reformula lo que durante mucho tiempo se ha tratado como una restricción inevitable en la inferencia de los modelos lingüísticos. El proceso de un token a la vez no es un requisito fijo sino una consecuencia de cómo funciona la generación estándar, y la decodificación especulativa lo rompe al combinar una etapa de redacción rápida con un paso de verificación paralelo que preserva exactamente la salida del modelo objetivo.
El resultado es una inferencia más rápida sin cambios en los pesos del modelo, sin reducción en la calidad de salida y sin modificaciones en el flujo de trabajo de solicitud. A medida que la técnica se integra más estrechamente en las herramientas de inferencia estándar, rápidamente se está convirtiendo en una parte predeterminada de cómo se implementan los modelos de lenguaje grandes.