
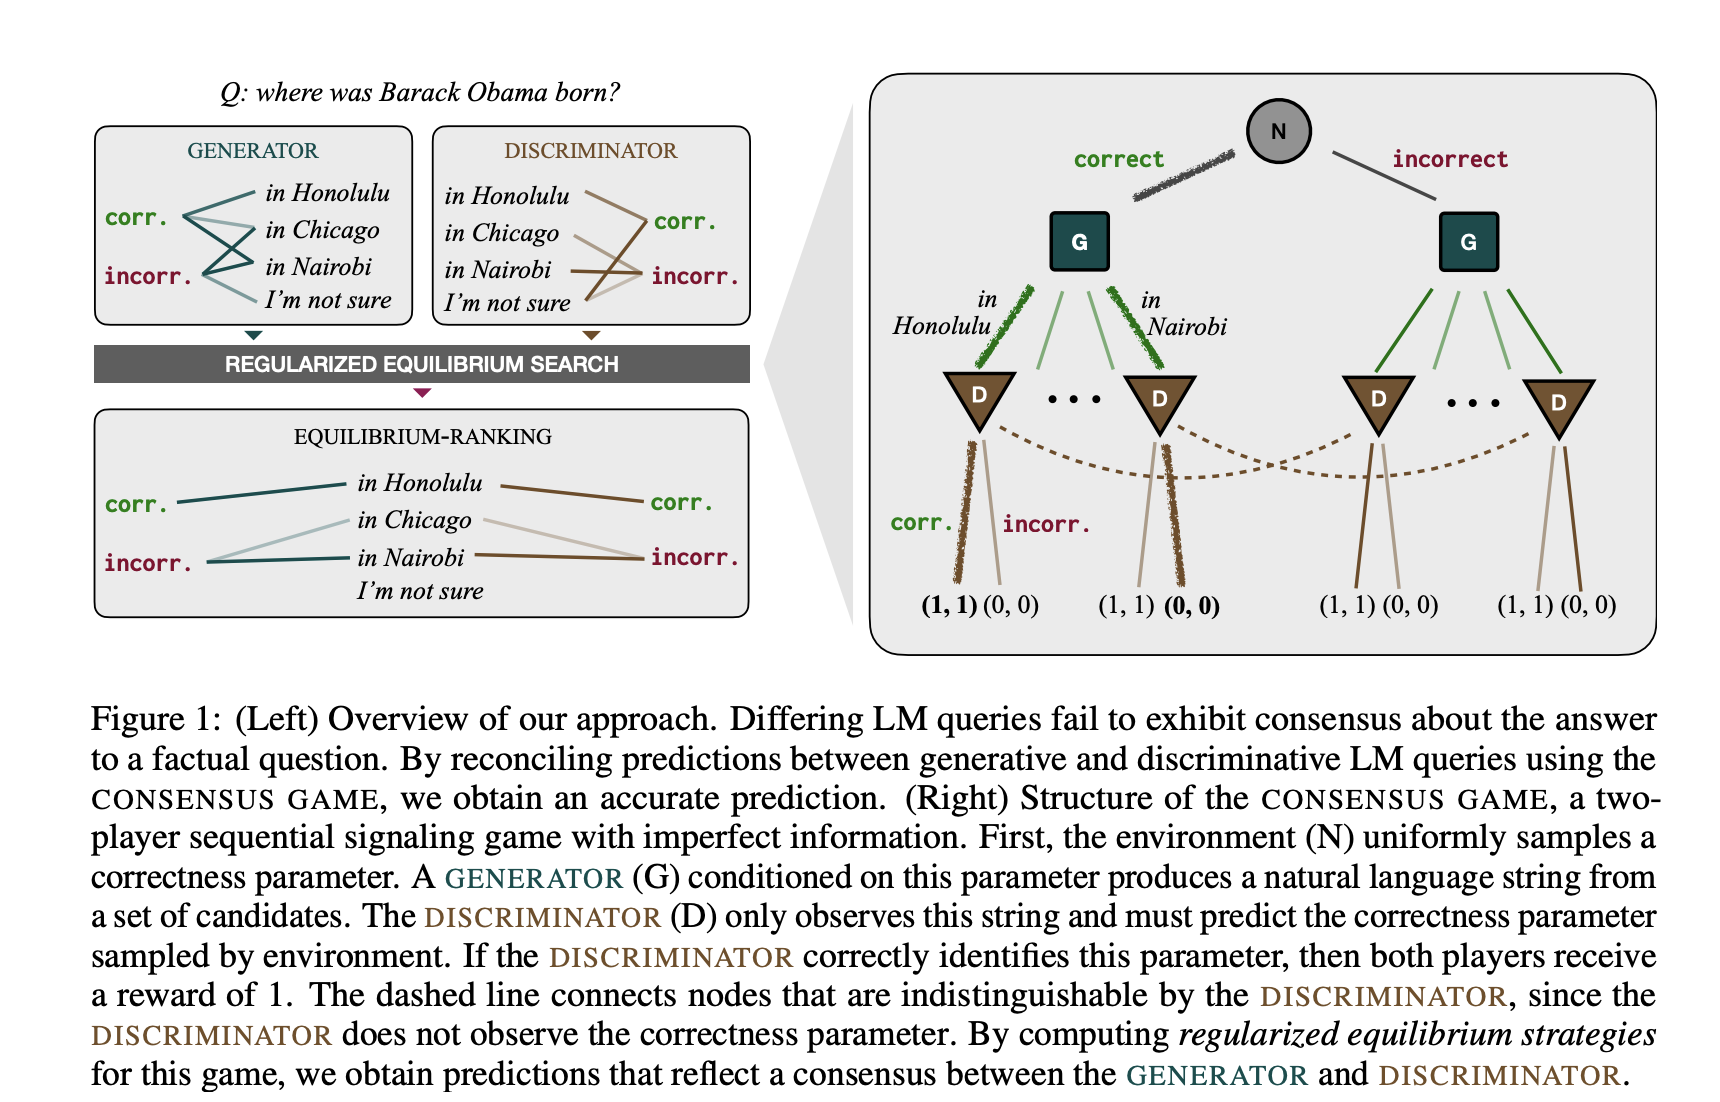
Algunas tareas que requieren la creación o verificación de afirmaciones fácticas (como la respuesta a preguntas, la verificación de hechos e incluso la generación de texto incondicional) se manejan con relativo éxito en los modelos de lenguaje (LM) actuales. Sin embargo, cada vez hay más evidencia que muestra que los LM se vuelven más propensos a producir comentarios erróneos pero a menudo repetidos a medida que aumenta el tamaño. Están lejos de ser completamente confiables. El hecho de que los LM tengan varias posibilidades para resolver tareas de generación de hechos complica aún más las cosas.
Se pueden utilizar tanto de forma generativa (preguntando por la respuesta más probable a una pregunta) como discriminativa (presentando un par de preguntas y respuestas y preguntando si la respuesta es aceptable), pero estos dos métodos a veces producen resultados diferentes. Los métodos generativos pueden fallan cuando la masa de probabilidad se distribuye entre múltiples respuestas contradictorias, mientras que los métodos discriminativos pueden fallar debido a una mala calibración o una dependencia sutil de la pregunta. ¿Cómo deberían extraer la mejor estimación de un LM sobre la verdad a partir de estas señales caóticas y frecuentemente contradictorias? El JUEGO DEL CONSENSO, Investigadores del MIT utilizan en esta investigación un juego de señalización para ofrecer un método para unir los procesos de decodificación LM generativos y discriminativos.
Un agente DISCRIMINADOR debe transmitir un valor abstracto correcto o incorrecto a un agente GENERADOR de alto nivel. Aun así, sólo puede hacerlo utilizando un número limitado de posibles cadenas de lenguaje natural. Parece razonable que una política combinada, en la que el GENERADOR y el DISCRIMINADOR acuerden la asignación de cadenas a valores de corrección, sería un enfoque exitoso para este juego. Pueden examinar un enfoque como ese para encontrar candidatos que todos consideren correctos. Para lograrlo, se debe resolver un juego de varios pasos con un espacio de acción difícil (valorado en cadenas). Los algoritmos de aprendizaje sin arrepentimiento se han vuelto populares recientemente como método de referencia para calcular tácticas ganadoras en juegos como Poker, Stratego y Diplomacy.
Aquí demuestran que también pueden usarse para tareas que implican la creación de lenguajes de forma libre. Este método de teoría de juegos para decodificar LM se conoce como EQUILIBRIUM-RANKING. Cuando se utiliza en 6 puntos de referencia para el rendimiento de respuesta a preguntas (MMLU, ARC, RACE, HHH, TruthfulQA y GSM8K), EQUILIBRIUM-RANKING supera significativamente las técnicas de decodificación generativa, discriminativa y mixta que se utilizan actualmente. En un sentido más amplio, sus hallazgos demuestran cómo el conjunto de herramientas de la teoría de juegos puede usarse para formalizar y mejorar la coherencia en los LM. La precisión de las tareas factuales también mejora como resultado de una mayor coherencia.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 31k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
También estamos en WhatsApp. Únase a nuestro canal de IA en Whatsapp.
Aneesh Tickoo es pasante de consultoría en MarktechPost. Actualmente está cursando su licenciatura en Ciencia de Datos e Inteligencia Artificial en el Instituto Indio de Tecnología (IIT), Bhilai. Pasa la mayor parte de su tiempo trabajando en proyectos destinados a aprovechar el poder del aprendizaje automático. Su interés de investigación es el procesamiento de imágenes y le apasiona crear soluciones en torno a él. Le encanta conectarse con personas y colaborar en proyectos interesantes.