
Los modelos de difusión probabilística, una categoría de vanguardia de modelos generativos, se han convertido en un punto crítico en el panorama de la investigación, particularmente para tareas relacionadas con la visión por computadora. A diferencia de otras clases de modelos generativos, como el codificador automático variacional (VAE), las redes generativas adversas (GAN) y los enfoques cuantificados por vectores, los modelos de difusión introducen un paradigma generativo novedoso. Estos modelos emplean una cadena de Markov fija para mapear el espacio latente, facilitando mapeos intrincados que capturan complejidades estructurales latentes dentro de un conjunto de datos. Recientemente, sus impresionantes capacidades generativas, que van desde el alto nivel de detalle hasta la diversidad de los ejemplos generados, han impulsado avances innovadores en diversas aplicaciones de visión por computadora, como la síntesis de imágenes, la edición de imágenes, la traducción de imagen a imagen y la conversión de texto a imagen. -generación de vídeo.
Los modelos de difusión constan de dos componentes principales: el proceso de difusión y el proceso de eliminación de ruido. Durante el proceso de difusión, el ruido gaussiano se incorpora progresivamente a los datos de entrada, transformándolos gradualmente en ruido gaussiano casi puro. Por el contrario, el proceso de eliminación de ruido tiene como objetivo recuperar los datos de entrada originales de su estado ruidoso utilizando una secuencia de operaciones de difusión inversa aprendidas. Normalmente, se emplea una U-Net para predecir la eliminación de ruido de forma iterativa en cada paso de eliminación de ruido. La investigación existente se centra predominantemente en el uso de U-Nets de difusión previamente entrenados para aplicaciones posteriores, con una exploración limitada de las características internas de la U-Net de difusión.
Un estudio conjunto del S-Lab y la Universidad Tecnológica de Nanyang se aparta de la aplicación convencional de modelos de difusión al investigar la eficacia de la difusión U-Net en el proceso de eliminación de ruido. Para obtener una comprensión más profunda del proceso de eliminación de ruido, los investigadores introducen un cambio de paradigma hacia el dominio de Fourier para observar el proceso de generación de modelos de difusión, un área de investigación relativamente inexplorada.
La figura anterior ilustra el proceso de eliminación de ruido progresivo en la fila superior, mostrando las imágenes generadas en iteraciones sucesivas. Por el contrario, las dos filas siguientes presentan la información de dominio espacial de baja y alta frecuencia asociada después de la transformada de Fourier inversa, correspondiente a cada paso respectivo. Esta figura revela una modulación gradual de los componentes de baja frecuencia, lo que indica una tasa de cambio moderada, mientras que los componentes de alta frecuencia exhiben una dinámica más pronunciada durante todo el proceso de eliminación de ruido. Estos hallazgos se pueden explicar intuitivamente: los componentes de baja frecuencia representan inherentemente la estructura y las características globales de una imagen, abarcando diseños globales y colores suaves. Las modificaciones drásticas de estos componentes generalmente no son adecuadas en los procesos de eliminación de ruido, ya que pueden remodelar fundamentalmente la esencia de la imagen. Por otro lado, los componentes de alta frecuencia capturan cambios rápidos en las imágenes, como bordes y texturas, y son muy sensibles al ruido. Los procesos de eliminación de ruido deben eliminar el ruido y al mismo tiempo preservar estos intrincados detalles.
Teniendo en cuenta estas observaciones con respecto a los componentes de baja y alta frecuencia durante la eliminación de ruido, la investigación se extiende para determinar las contribuciones específicas de la arquitectura U-Net dentro del marco de difusión. En cada etapa del decodificador U-Net, se combinan funciones de omisión de las conexiones de omisión y funciones de la red troncal. El estudio revela que la columna vertebral principal de U-Net desempeña un papel importante en la eliminación de ruido, mientras que las conexiones de salto introducen características de alta frecuencia en el módulo decodificador, lo que ayuda a recuperar información semántica detallada. Sin embargo, esta propagación de características de alta frecuencia puede debilitar inadvertidamente las capacidades inherentes de eliminación de ruido de la red troncal durante la fase de inferencia, lo que podría conducir a la generación de detalles de imagen anormales, como se muestra en la primera fila de la Figura 1.
A la luz de este descubrimiento, los investigadores proponen un nuevo enfoque denominado “FreeU”, que puede mejorar la calidad de las muestras generadas sin requerir una sobrecarga computacional adicional de entrenamiento o ajuste. La descripción general del marco se presenta a continuación.

Durante la fase de inferencia, se introducen dos factores de modulación especializados para equilibrar las contribuciones de las características de la red troncal principal y omitir conexiones de la arquitectura U-Net. El primer factor, conocido como “factores de características de la red troncal”, está diseñado para amplificar los mapas de características de la red troncal primaria, fortaleciendo así el proceso de eliminación de ruido. Sin embargo, se observa que la inclusión de factores de escala de características de la columna vertebral, si bien produce mejoras significativas, en ocasiones puede dar como resultado un suavizado excesivo no deseado de las texturas. Para abordar esta preocupación, se introduce el segundo factor, “omitir factores de escala de características”, para mitigar el problema del suavizado excesivo de la textura.
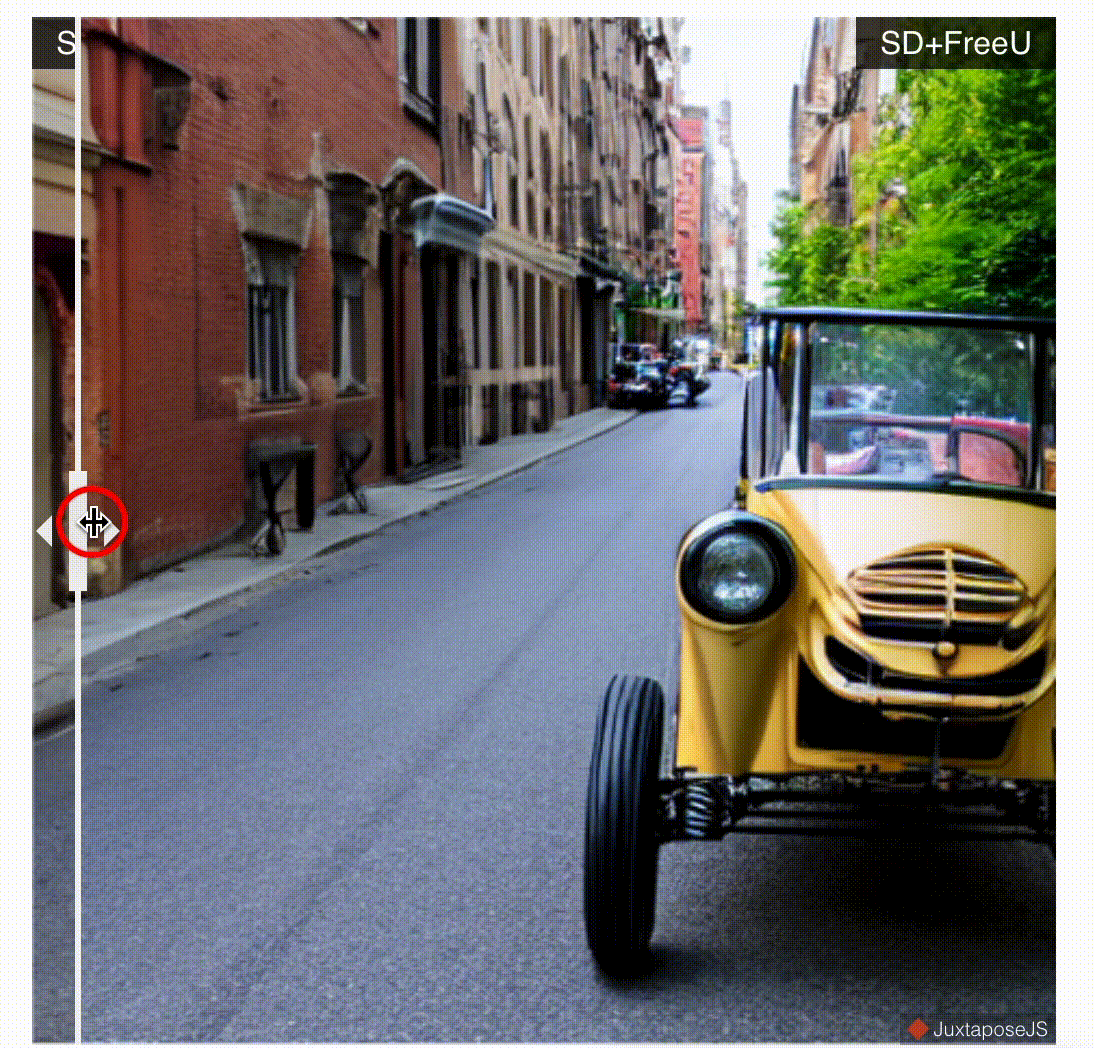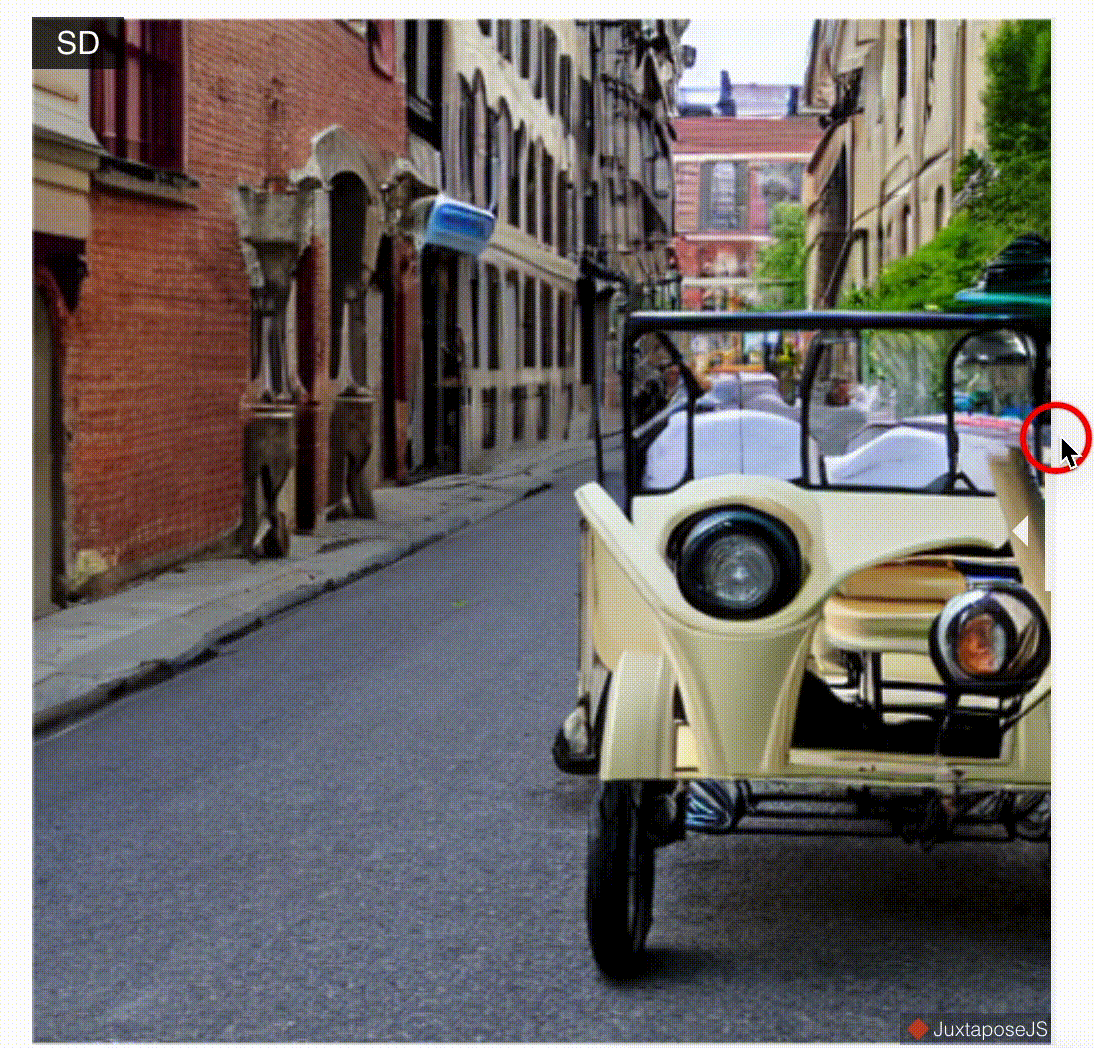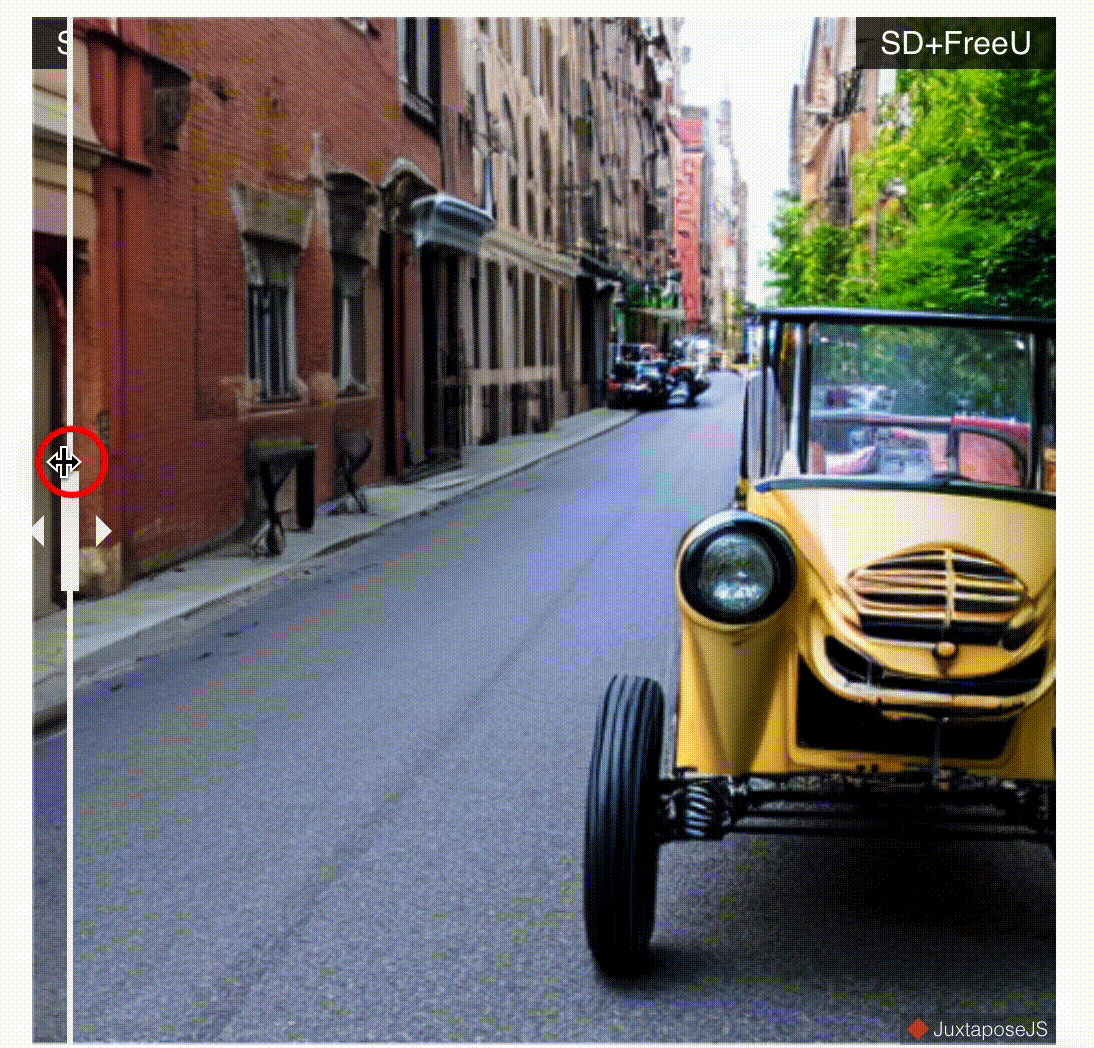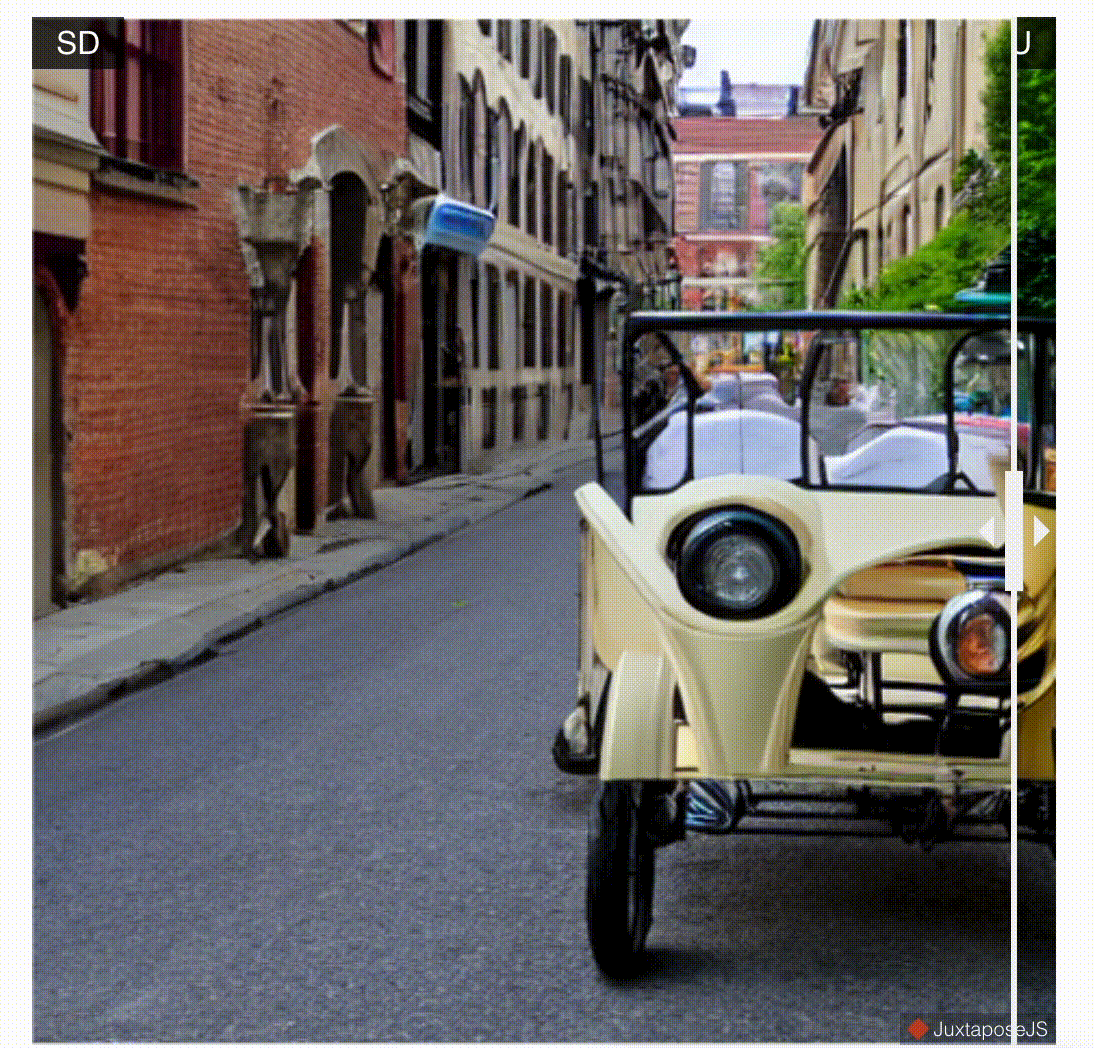
El marco FreeU demuestra una adaptabilidad perfecta cuando se integra con los modelos de difusión existentes, incluidas aplicaciones como la generación de texto a imagen y la generación de texto a video. Se lleva a cabo una evaluación experimental integral de este enfoque utilizando modelos fundamentales como Stable Diffusion, DreamBooth, ReVersion, ModelScope y Rerender para comparaciones de referencia. Cuando se aplica FreeU durante la fase de inferencia, estos modelos muestran una mejora notable en la calidad de los resultados generados. La representación visual en la siguiente ilustración proporciona evidencia de la efectividad de FreeU para mejorar significativamente tanto los detalles complejos como la fidelidad visual general de las imágenes generadas.
Este fue el resumen de FreeU, una novedosa técnica de inteligencia artificial que mejora la calidad de salida de los modelos generativos sin capacitación ni ajustes adicionales. Si está interesado y desea obtener más información al respecto, no dude en consultar los enlaces que se citan a continuación.
Revisar la Papel y Página del proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 32k+ ML, Comunidad de Facebook de más de 40.000 personas, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
También estamos en WhatsApp. Únase a nuestro canal de IA en Whatsapp.

Daniele Lorenzi recibió su M.Sc. en TIC para Ingeniería de Internet y Multimedia en 2021 de la Universidad de Padua, Italia. Es un doctorado. Candidato en el Instituto de Tecnología de la Información (ITEC) de la Alpen-Adria-Universität (AAU) de Klagenfurt. Actualmente trabaja en el Laboratorio Christian Doppler ATHENA y sus intereses de investigación incluyen transmisión de video adaptativa, medios inmersivos, aprendizaje automático y evaluación de QoS/QoE.