
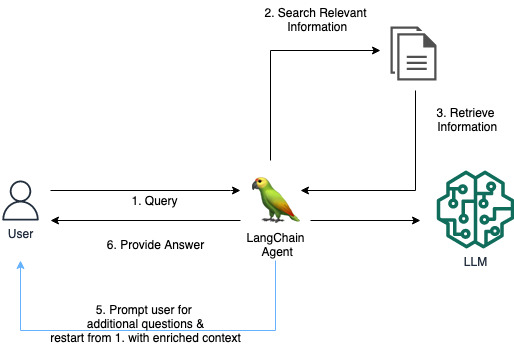
Una de las aplicaciones más comunes de la IA generativa y los modelos de lenguaje grande (LLM) es responder preguntas basadas en un corpus de conocimiento externo específico. La generación aumentada de recuperación (RAG) es una técnica popular para crear sistemas de respuesta a preguntas que utilizan una base de conocimiento externa. Para obtener más información, consulte Cree un potente robot de respuesta a preguntas con Amazon SageMaker, Amazon OpenSearch Service, Streamlit y LangChain.
Los sistemas RAG tradicionales a menudo tienen dificultades para proporcionar respuestas satisfactorias cuando los usuarios hacen preguntas vagas o ambiguas sin proporcionar suficiente contexto. Esto lleva a respuestas inútiles como “No sé” o respuestas incorrectas e inventadas proporcionadas por un LLM. En esta publicación, demostramos una solución para mejorar la calidad de las respuestas en tales casos de uso en comparación con los sistemas RAG tradicionales mediante la introducción de un componente de aclaración interactivo utilizando LangChain.
La idea clave es permitir que el sistema RAG entable un diálogo conversacional con el usuario cuando la pregunta inicial no está clara. Al hacer preguntas aclaratorias, solicitar al usuario más detalles e incorporar nueva información contextual, el sistema RAG puede recopilar el contexto necesario para proporcionar una respuesta precisa y útil, incluso a partir de una consulta inicial ambigua del usuario.
Descripción general de la solución
Para demostrar nuestra solución, hemos creado un Índice de Amazon Kendra (compuesto por la documentación en línea de AWS para amazona kendra, Amazon Lexy Amazon SageMaker), un agente de LangChain con un Roca Amazónica LLM y un sencillo iluminado interfaz de usuario.
Requisitos previos
Para ejecutar esta demostración en su cuenta de AWS, complete los siguientes requisitos previos:
- Clonar el repositorio de GitHub y siga los pasos explicados en el README.
- Implemente un índice de Amazon Kendra en su cuenta de AWS. Puedes usar lo siguiente Formación en la nube de AWS plantilla para crear un nuevo índice o utilizar un índice que ya se esté ejecutando. La implementación de un nuevo índice puede agregar cargos adicionales a su factura, por lo que le recomendamos eliminarlo si ya no lo necesita. Tenga en cuenta que los datos dentro del índice se enviarán al modelo de base (FM) de Amazon Bedrock seleccionado.
- El agente de LangChain se basa en los FM disponibles en Amazon Bedrock, pero esto se puede adaptar a cualquier otro LLM que admita LangChain.
- Para experimentar con la interfaz de muestra compartida con el código, puede usar Amazon SageMaker Estudio para ejecutar una implementación local de la aplicación Streamlit. Tenga en cuenta que ejecutar esta demostración generará algunos costos adicionales.
Implementar la solución
Los agentes RAG tradicionales suelen diseñarse de la siguiente manera. El agente tiene acceso a una herramienta que se utiliza para recuperar documentos relevantes para la consulta de un usuario. Luego, los documentos recuperados se insertan en el mensaje LLM, de modo que el agente pueda proporcionar una respuesta basada en los fragmentos de documentos recuperados.
En esta publicación, implementamos un agente que tiene acceso a KendraRetrievalTool y deriva documentos relevantes del índice de Amazon Kendra y proporciona la respuesta dado el contexto recuperado:
Referirse a repositorio de GitHub para ver el código de implementación completo. Para obtener más información sobre los casos de uso tradicionales de RAG, consulte Respuesta a preguntas mediante recuperación de generación aumentada con modelos básicos en Amazon SageMaker JumpStart.
Considere el siguiente ejemplo. Un usuario pregunta “¿Cuántas GPU tiene mi instancia EC2?” Como se muestra en la siguiente captura de pantalla, el agente busca la respuesta usando KendraRetrievalTool. Sin embargo, el agente se da cuenta de que no sabe cuál Nube informática elástica de Amazon (Amazon EC2) tipo de instancia al que hace referencia el usuario y, por lo tanto, no proporciona ninguna respuesta útil al usuario, lo que genera una mala experiencia para el cliente.
Para abordar este problema, definimos una herramienta personalizada adicional llamada AskHumanTool y entregárselo al agente. La herramienta le indica a un LLM que lea la pregunta del usuario y le haga una pregunta de seguimiento si KendraRetrievalTool no es capaz de devolver una buena respuesta. Esto implica que el agente ahora tendrá dos herramientas a su disposición:
Esto permite al agente refinar la pregunta o proporcionar el contexto adicional necesario para responder al mensaje. Para guiar al agente a utilizar AskHumanTool para este propósito, Proporcionamos la siguiente descripción de la herramienta al LLM:
Use this tool if you don’t find an answer using the KendraRetrievalTool.
Ask the human to clarify the question or provide the missing information.
The input should be a question for the human.
Como se ilustra en la siguiente captura de pantalla, usando AskHumanToolel agente ahora identifica preguntas vagas de los usuarios y devuelve una pregunta de seguimiento al usuario pidiendo que especifique qué tipo de instancia EC2 se está utilizando.

Una vez que el usuario ha especificado el tipo de instancia, el agente incorpora la respuesta adicional en el contexto de la pregunta original, antes de derivar la respuesta correcta.

Tenga en cuenta que el agente ahora puede decidir si utilizar KendraRetrievalTool para recuperar los documentos relevantes o hacer una pregunta aclaratoria utilizando AskHumanTool. La decisión del agente se basa en si considera que los fragmentos de documento insertados en el mensaje son suficientes para proporcionar la respuesta final. Esta flexibilidad permite que el sistema RAG admita diferentes consultas que un usuario puede enviar, incluidas preguntas vagas y bien formuladas.
En nuestro ejemplo, el flujo de trabajo completo del agente es el siguiente:
- El usuario realiza una solicitud a la aplicación RAG y pregunta “¿Cuántas GPU tiene mi instancia EC2?”
- El agente utiliza el LLM para decidir qué acción tomar: encontrar información relevante para responder a la solicitud del usuario llamando al
KendraRetrievalTool. - El agente recupera información del índice de Amazon Kendra utilizando la herramienta. Los fragmentos de los documentos recuperados se insertan en el mensaje del agente.
- El LLM (del agente) concluye que los documentos recuperados de Amazon Kendra no son útiles o no contienen suficiente contexto para dar una respuesta a la solicitud del usuario.
- El agente utiliza
AskHumanToolpara formular una pregunta de seguimiento: “¿Cuál es el tipo de instancia EC2 específica que está utilizando? Conocer el tipo de instancia ayudaría a saber cuántas GPU tiene”. El usuario proporciona la respuesta “ml.g5.12xlarge” y el agente llamaKendraRetrievalToolnuevamente, pero esta vez agregando el tipo de instancia EC2 a la consulta de búsqueda. - Después de ejecutar nuevamente los pasos 2 a 4, el agente obtiene una respuesta útil y se la envía al usuario.
El siguiente diagrama ilustra este flujo de trabajo.
El ejemplo descrito en esta publicación ilustra cómo la adición de la costumbre AskHumanTool permite al agente solicitar detalles aclaratorios cuando sea necesario. Esto puede mejorar la confiabilidad y precisión de las respuestas, lo que lleva a una mejor experiencia del cliente en un número creciente de aplicaciones RAG en diferentes dominios.
Limpiar
Para evitar incurrir en costos innecesarios, elimine el índice de Amazon Kendra si ya no lo usa y cierre la instancia de SageMaker Studio si la usó para ejecutar la demostración.
Conclusión
En esta publicación, mostramos cómo permitir una mejor experiencia de cliente para los usuarios de un sistema RAG agregando una herramienta personalizada que permite al sistema solicitar a un usuario la información faltante. Este enfoque conversacional interactivo representa una dirección prometedora para mejorar las arquitecturas RAG tradicionales. La capacidad de resolver la vaguedad a través del diálogo puede conducir a brindar respuestas más satisfactorias a partir de una base de conocimientos.
Tenga en cuenta que este enfoque no se limita a los casos de uso de RAG; Puede usarlo en otros casos de uso de IA generativa que dependen de un agente en su núcleo, donde un personalizado AskHumanTool Puede ser añadido.
Para obtener más información sobre el uso de Amazon Kendra con IA generativa, consulte Cree rápidamente aplicaciones de IA generativa de alta precisión sobre datos empresariales utilizando Amazon Kendra, LangChain y modelos de lenguaje de gran tamaño..
Sobre los autores
 Antonia Wiebeler es científica de datos en el Centro de innovación de IA generativa de AWS, donde le gusta crear pruebas de concepto para los clientes. Su pasión es explorar cómo la IA generativa puede resolver problemas del mundo real y crear valor para los clientes. Si bien no codifica, le gusta correr y competir en triatlones.
Nikita Kozodoi es científico aplicado en el Centro de innovación de IA generativa de AWS, donde desarrolla soluciones de aprendizaje automático para resolver los problemas de los clientes en todas las industrias. En su puesto, se centra en el avance de la IA generativa para abordar los desafíos del mundo real. En su tiempo libre le encanta jugar voleibol de playa y leer.