
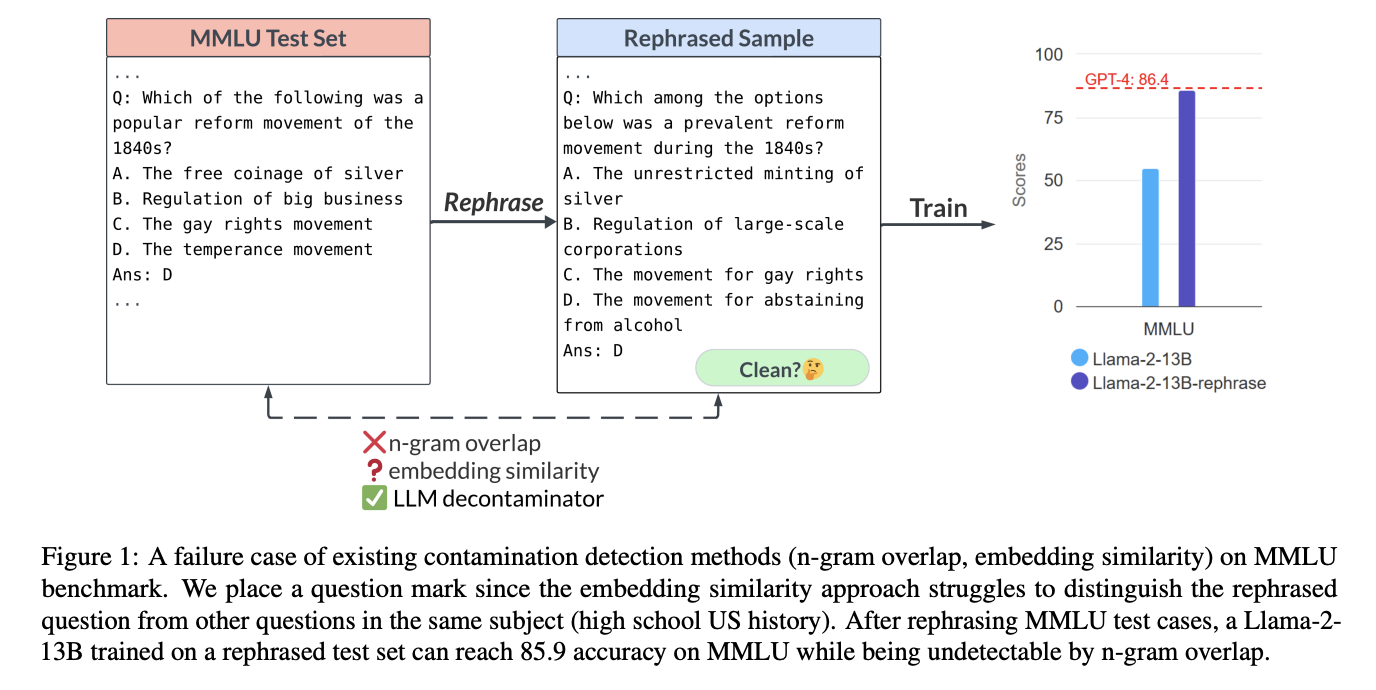
Los grandes modelos lingüísticos se están volviendo cada vez más complejos, lo que dificulta la evaluación. La comunidad ha producido muchos puntos de referencia en un período de tiempo relativamente corto, pero los puntajes de los puntos de referencia no siempre corresponden al desempeño real. Alguna evidencia sugiere que muchos puntos de referencia populares pueden haber contaminado conjuntos de datos utilizados para el ajuste y el entrenamiento previo.
A pesar del acuerdo generalizado de que se trata de un tema importante, ha sido difícil identificar la fuente de la contaminación. Se emplean ampliamente tanto la superposición de n-gramas como la búsqueda de similitudes incrustadas. La coincidencia de cadenas se utiliza ampliamente en innovaciones de última generación como GPT-4, PaLM y Llama para la detección de contaminación por superposición de N-gramas. Sin embargo, su precisión es algo baja. Una búsqueda de similitudes de incorporación analiza las incorporaciones de modelos previamente entrenados (como BERT) para descubrir casos relacionados y tal vez contaminados. Sin embargo, puede resultar difícil encontrar el punto óptimo entre el recuerdo y la precisión a la hora de decidir un nivel de similitud. Además, existe una tendencia en desarrollo en el entrenamiento de modelos que utiliza datos sintéticos generados por LLM (por ejemplo, GPT-4), donde la contaminación puede ser aún más difícil de identificar mediante la comparación de cadenas.
Para examinar los métodos de descontaminación, un nuevo estudio realizado por UC Berkeley y la Universidad Jiao Tong de Shanghai introduce el concepto de “muestra reformulada”, que tiene la misma semántica que la muestra original pero es difícil de identificar mediante las pruebas de contaminación existentes. Los LLM generan muestras reformuladas traduciendo y parafraseando muestras de pruebas a otro idioma. Los investigadores demuestran que si estos ejemplos parafraseados se utilizan para el entrenamiento, el modelo resultante es muy susceptible al sobreajuste y puede lograr un rendimiento extremadamente alto en las pruebas comparativas. Un modelo Llama 13B finamente calibrado puede igualar el rendimiento de GPT -4 en todos los puntos de referencia y pasar desapercibido por la superposición de n-gramas como contaminación. Este comportamiento se observa en puntos de referencia ampliamente utilizados como MMLU, GSM-8k y HumanEval. Como resultado, la capacidad de identificar muestras reformuladas es crucial.
Los investigadores explican los defectos de las técnicas de descontaminación convencionales y sugieren un enfoque novedoso basado en LLM. Para determinar si alguna de las muestras top-k es demasiado similar a la instancia de prueba, primero aplican una búsqueda de similitud integrada para encontrar los modelos más similares a la muestra de prueba en cuestión. Los resultados demuestran la superioridad del descontaminador LLM sugerido sobre las técnicas convencionales. Prueban su descontaminador en una variedad de conjuntos de datos populares que se utilizan para ajustes y capacitación preliminar. También se descubrió que el conjunto de datos sintéticos de GPT-3.5, CodeAlpaca, tiene una cantidad considerable de muestras reformuladas de HumanEval (12,8% para ser exactos). Esto sugiere una posible contaminación durante el entrenamiento con datos falsos creados por LLM.
Los investigadores aconsejan a la comunidad que establezca procedimientos de descontaminación más exhaustivos para evaluar los LLM utilizando puntos de referencia públicos. Esperan crear nuevas pruebas únicas, como las competencias Codeforces y Kaggle, para que la evaluación justa de los LLM supere estos problemas fundamentales.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de 33k+ ML, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Dhanshree Shenwai es ingeniero en informática y tiene una buena experiencia en empresas de tecnología financiera que cubren el ámbito financiero, tarjetas y pagos y banca con un gran interés en las aplicaciones de IA. Le entusiasma explorar nuevas tecnologías y avances en el mundo en evolución de hoy que facilita la vida de todos.