
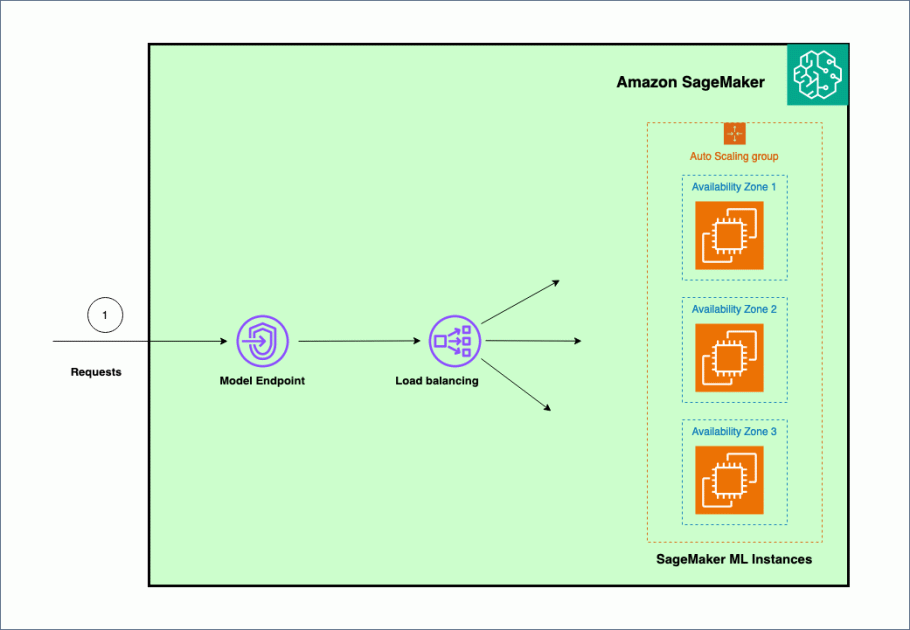
Amazon SageMaker facilita la implementación de modelos de aprendizaje automático (ML) para inferencia en tiempo real y ofrece una amplia selección de instancias de ML que abarcan CPU y aceleradores como AWS Inferencia. Como servicio totalmente administrado, puede escalar las implementaciones de sus modelos, minimizar los costos de inferencia y administrar sus modelos de manera más efectiva en producción con una carga operativa reducida. Un punto final de inferencia en tiempo real de SageMaker consta de un punto final HTTP e instancias de aprendizaje automático que se implementan en múltiples zonas de disponibilidad para lograr alta disponibilidad. fabricante de salvia escalado automático de aplicaciones puede ajustar dinámicamente la cantidad de instancias de ML aprovisionadas para un modelo en respuesta a cambios en la carga de trabajo. El punto final distribuye uniformemente las solicitudes entrantes a instancias de ML mediante un algoritmo de operación por turnos.
Cuando los modelos de aprendizaje automático implementados en instancias reciben llamadas API de una gran cantidad de clientes, una distribución aleatoria de solicitudes puede funcionar muy bien cuando no hay mucha variabilidad en sus solicitudes y respuestas. Pero en sistemas con cargas de trabajo de IA generativa, las solicitudes y respuestas pueden ser extremadamente variables. En estos casos, a menudo es deseable equilibrar la carga considerando la capacidad y la utilización de la instancia en lugar de un equilibrio de carga aleatorio.
En esta publicación, analizamos la estrategia de enrutamiento de solicitudes menos pendientes (LOR) de SageMaker y cómo puede minimizar la latencia para ciertos tipos de cargas de trabajo de inferencia en tiempo real teniendo en cuenta la capacidad y la utilización de las instancias de ML. Hablamos de sus beneficios sobre el mecanismo de enrutamiento predeterminado y de cómo puede habilitar LOR para las implementaciones de su modelo. Finalmente, presentamos un análisis comparativo de las mejoras de latencia con LOR respecto a la estrategia de enrutamiento predeterminada de enrutamiento aleatorio.
Estrategia LOR de SageMaker
De forma predeterminada, los puntos finales de SageMaker tienen una estrategia de enrutamiento aleatorio. SageMaker ahora admite una estrategia LOR, que le permite enrutar de manera óptima las solicitudes a la instancia que mejor se adapte a esa solicitud. SageMaker hace esto posible al monitorear la carga de las instancias detrás de su punto final y los modelos o componentes de inferencia que se implementan en cada instancia.
El siguiente diagrama interactivo muestra la política de enrutamiento predeterminada donde las solicitudes que llegan a los puntos finales del modelo se reenvían de forma aleatoria a las instancias de ML.
El siguiente diagrama interactivo muestra la estrategia de enrutamiento donde SageMaker enrutará la solicitud a la instancia que tenga la menor cantidad de solicitudes pendientes.

En general, el enrutamiento LOR funciona bien para modelos fundamentales o modelos de IA generativos cuando su modelo responde en cientos de milisegundos a minutos. Si la respuesta de su modelo tiene una latencia más baja (hasta cientos de milisegundos), puede beneficiarse más del enrutamiento aleatorio. De todos modos, le recomendamos que pruebe e identifique el mejor algoritmo de enrutamiento para sus cargas de trabajo.
Cómo configurar estrategias de enrutamiento de SageMaker
SageMaker ahora le permite configurar el RoutingStrategy parámetro al crear el EndpointConfiguration para puntos finales. Lo diferente RoutingStrategy Los valores admitidos por SageMaker son:
LEAST_OUTSTANDING_REQUESTSRANDOM
El siguiente es un ejemplo de implementación de un modelo en un punto final de inferencia que tiene LOR habilitado:
- Cree la configuración del punto final configurando
RoutingStrategycomoLEAST_OUTSTANDING_REQUESTS: - Cree el punto final usando la configuración del punto final (sin cambios):
Resultados de rendimiento
Realizamos evaluaciones comparativas de rendimiento para medir la latencia de inferencia de un extremo a otro y el rendimiento de la codegen2-7B modelo alojado en instancias ml.g5.24xl con enrutamiento predeterminado y puntos finales de enrutamiento inteligente. El modelo CodeGen2 pertenece a la familia de modelos de lenguaje autorregresivos y genera código ejecutable cuando se le dan indicaciones en inglés.
En nuestro análisis, aumentamos la cantidad de instancias ml.g5.24xl detrás de cada punto final para cada ejecución de prueba a medida que aumentaba la cantidad de usuarios simultáneos, como se muestra en la siguiente tabla.
| Prueba | Número de usuarios simultáneos | Número de instancias |
| 1 | 4 | 1 |
| 2 | 20 | 5 |
| 3 | 40 | 10 |
| 4 | 60 | 15 |
| 5 | 80 | 20 |
Medimos la latencia P99 de un extremo a otro para ambos puntos finales y observamos una mejora de la latencia del 4 al 33 % cuando el número de instancias aumentó de 5 a 20, como se muestra en el siguiente gráfico.
De manera similar, observamos una mejora del 15 al 16 % en el rendimiento por minuto por instancia cuando el número de instancias aumentó de 5 a 20.
Esto ilustra que el enrutamiento inteligente puede mejorar la distribución del tráfico entre los puntos finales, lo que genera mejoras en la latencia de un extremo a otro y en el rendimiento general.
Conclusión
En esta publicación, explicamos las estrategias de enrutamiento de SageMaker y la nueva opción para habilitar el enrutamiento LOR. Explicamos cómo habilitar LOR y cómo puede beneficiar las implementaciones de su modelo. Nuestras pruebas de rendimiento mostraron mejoras en la latencia y el rendimiento durante la inferencia en tiempo real. Para obtener más información sobre las funciones de enrutamiento de SageMaker, consulte documentación. Le recomendamos que evalúe sus cargas de trabajo de inferencia y determine si está configurado de manera óptima con la estrategia de enrutamiento.
Sobre los autores
parque james es arquitecto de soluciones en Amazon Web Services. Trabaja con Amazon.com para diseñar, construir e implementar soluciones tecnológicas en AWS y tiene un interés particular en la inteligencia artificial y el aprendizaje automático. En su tiempo libre le gusta buscar nuevas culturas, nuevas experiencias y mantenerse actualizado con las últimas tendencias tecnológicas. Puedes encontrarlo en LinkedIn.
Venugopal Pai es arquitecto de soluciones en AWS. Vive en Bengaluru, India, y ayuda a los clientes nativos digitales a escalar y optimizar sus aplicaciones en AWS.
 David Nigenda es ingeniero senior de desarrollo de software en el equipo de Amazon SageMaker y actualmente trabaja para mejorar los flujos de trabajo de aprendizaje automático de producción, así como para lanzar nuevas funciones de inferencia. En su tiempo libre, intenta seguir el ritmo de sus hijos.
 Deepti Ragha es ingeniero de desarrollo de software en el equipo de Amazon SageMaker. Su trabajo actual se centra en crear funciones para alojar modelos de aprendizaje automático de manera eficiente. En su tiempo libre, le gusta viajar, hacer caminatas y cultivar plantas.
 Alan Tan es gerente senior de productos en SageMaker y lidera los esfuerzos en la inferencia de modelos grandes. Le apasiona aplicar el aprendizaje automático al área de análisis. Fuera del trabajo, disfruta del aire libre.
Dhawal Patel es arquitecto principal de aprendizaje automático en AWS. Ha trabajado con organizaciones que van desde grandes empresas hasta medianas empresas en problemas relacionados con la computación distribuida y la Inteligencia Artificial. Se centra en el aprendizaje profundo, incluidos los dominios de PNL y visión por computadora. Ayuda a los clientes a lograr una inferencia de modelos de alto rendimiento en SageMaker.