
La privacidad en los modelos de aprendizaje automático se ha convertido en una preocupación crítica debido a los ataques de inferencia de membresía (MIA). Estos ataques miden si puntos de datos específicos formaban parte de los datos de entrenamiento de un modelo. Comprender MIA es fundamental, ya que evalúa la exposición inadvertida de información cuando los modelos se entrenan en diversos conjuntos de datos. El alcance de MIA abarca varios escenarios, desde modelos estadísticos hasta aprendizaje automático federado y que preserva la privacidad. Inicialmente basados en estadísticas resumidas, los métodos MIA han evolucionado, utilizando diversas estrategias y aproximaciones de prueba de hipótesis, especialmente en algoritmos de aprendizaje profundo.
Los enfoques anteriores de MIA se han enfrentado a desafíos importantes. A pesar de las mejoras en la efectividad de los ataques, las demandas computacionales han hecho que muchas auditorías de privacidad sean poco prácticas. Algunos métodos de vanguardia, particularmente para modelos generalizados, rozan la conjetura aleatoria cuando están limitados por recursos computacionales. Además, la falta de medios claros e interpretables para comparar diferentes ataques ha llevado a su dominio mutuo, donde cada ataque supera al otro en función de diferentes escenarios. Esta complejidad requiere el desarrollo de ataques más sólidos pero eficientes para evaluar los riesgos de privacidad de manera efectiva. El gasto computacional asociado con los ataques existentes ha limitado su practicidad, lo que subraya la necesidad de estrategias novedosas que logren un alto rendimiento dentro de presupuestos computacionales limitados.
En este contexto, se publicó un nuevo artículo para proponer un enfoque de ataque novedoso dentro del ámbito de los ataques de inferencia de membresía (MIA). Los ataques de inferencia de membresía, cuyo objetivo es discernir si un punto de datos específico se utilizó durante el entrenamiento de un modelo de aprendizaje automático determinado θ, se describen como un juego de indistinguibilidad entre un retador (algoritmo) y un adversario (auditor de privacidad). Esto implica escenarios en los que se entrena un modelo θ con o sin el punto de datos x. La tarea del adversario es inferir, basándose en x, el modelo entrenado θ y su conocimiento de la distribución de datos, en qué escenario se encuentra dentro de estos dos mundos.
La nueva metodología Membership Inference Attack (MIA) introduce un enfoque preciso para construir dos mundos distintos donde x es miembro o no miembro del conjunto de entrenamiento. A diferencia de los métodos anteriores que simplificaban estas construcciones, este nuevo ataque compone meticulosamente la hipótesis nula reemplazando x con puntos de datos aleatorios de la población. Este diseño conduce a muchas pruebas de razones de probabilidad por pares para medir la pertenencia de x en relación con otros puntos de datos z. El ataque tiene como objetivo recopilar evidencia sustancial que favorezca la presencia de x en el conjunto de entrenamiento sobre una z aleatoria, ofreciendo un análisis de fuga más matizado. Este novedoso método calcula el índice de probabilidad correspondiente a x y z, distinguiendo entre escenarios en los que x es miembro y no miembro mediante una prueba de índice de probabilidad.
Esta metodología, denominada ataque de inferencia de membresía relativa (RMIA), aprovecha los datos de población y los modelos de referencia para mejorar la potencia y la solidez del ataque contra las variaciones de conocimiento previo del adversario. Introduce una prueba refinada de razón de verosimilitud que mide efectivamente la distinguibilidad entre x y cualquier z basándose en cambios en sus probabilidades cuando están condicionadas a θ. A diferencia de los ataques existentes, este método garantiza un enfoque más calibrado, evitando dependencias de una magnitud no calibrada o pasando por alto la calibración esencial con datos de población. A través de un meticuloso cálculo de la relación de probabilidad por pares y un enfoque bayesiano, RMIA emerge como un ataque robusto, de alta potencia y rentable, que supera a los métodos de última generación anteriores en varios escenarios.
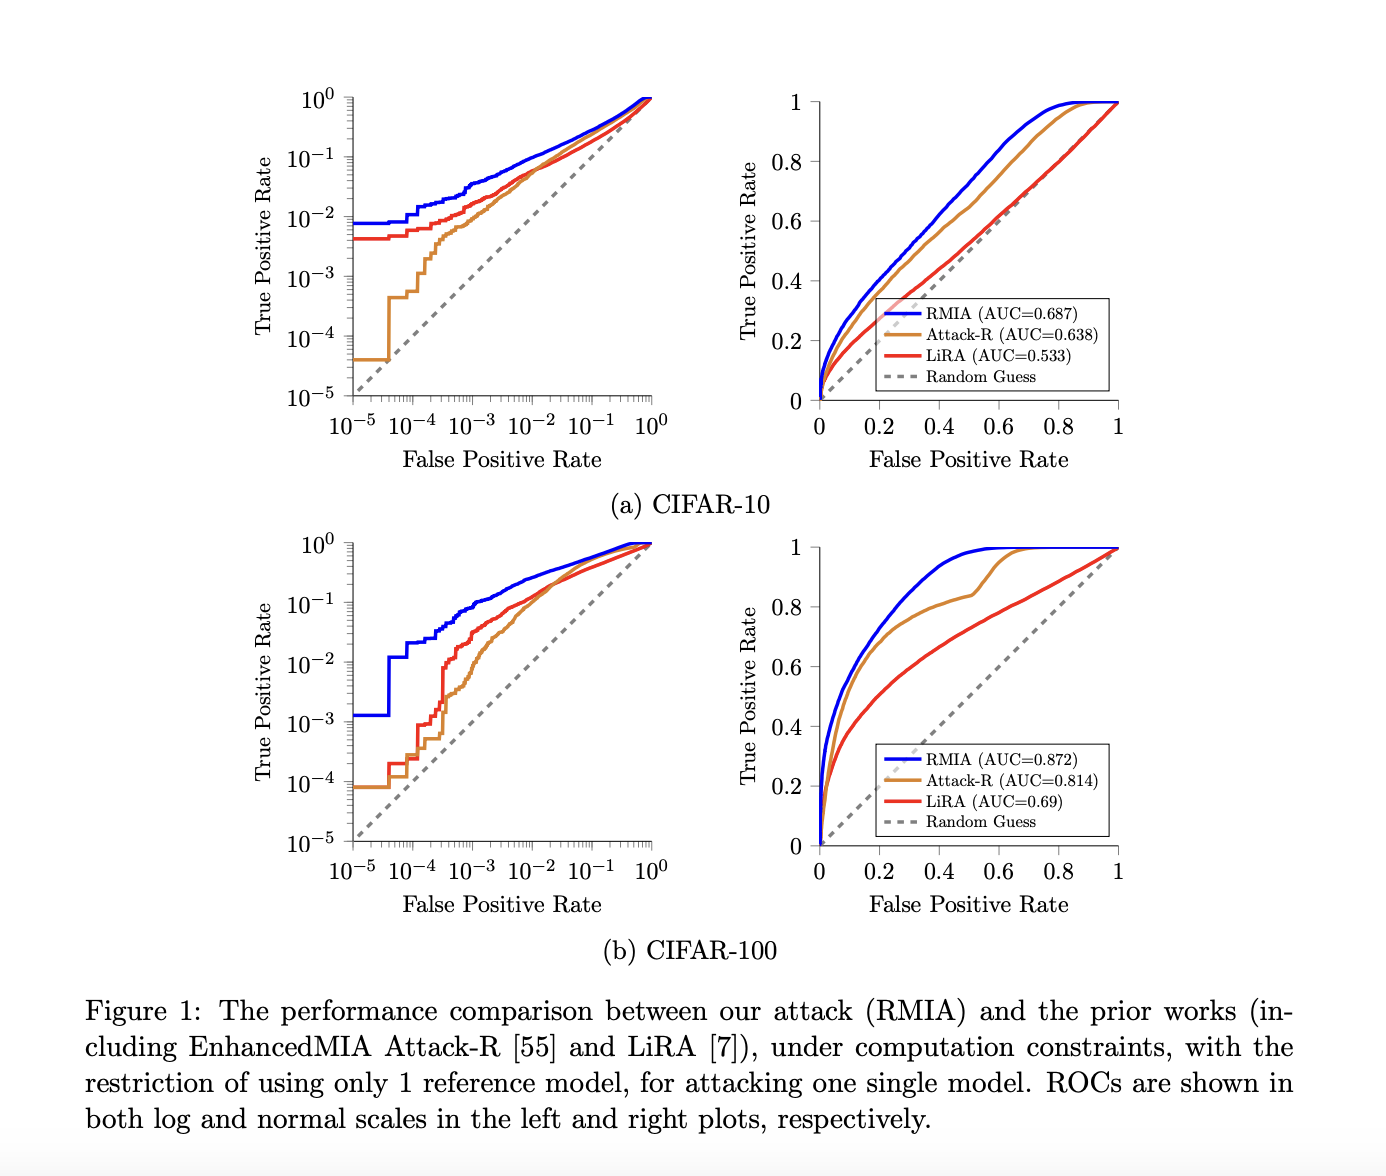
Los autores compararon RMIA con otros ataques de inferencia de membresía utilizando conjuntos de datos como CIFAR-10, CIFAR-100, CINIC-10 y Purchase-100. RMIA superó consistentemente a otros ataques, especialmente con un número limitado de modelos de referencia o en escenarios fuera de línea. Incluso con pocos modelos, RMIA mostró resultados cercanos a escenarios con más modelos. Con abundantes modelos de referencia, RMIA mantuvo una ligera ventaja en AUC y un TPR notablemente más alto con FPR cero en comparación con LiRA. Su rendimiento mejoró con más consultas, lo que demuestra su eficacia en diversos escenarios y conjuntos de datos.
Para concluir, el artículo presenta RMIA, un método de ataque de inferencia de membresía relativa, que demuestra su superioridad sobre los ataques existentes en la identificación de membresía dentro de modelos de aprendizaje automático. RMIA sobresale en escenarios con modelos de referencia limitados y muestra un rendimiento sólido en varios conjuntos de datos y arquitecturas de modelos. Además, esta eficiencia hace que RMIA sea una opción práctica y viable para el análisis de riesgos de privacidad, especialmente en escenarios donde las limitaciones de recursos son una preocupación. Su flexibilidad, escalabilidad y el equilibrio entre precisión y falsos positivos posicionan a RMIA como un método confiable y adaptable para ataques de inferencia de membresía, ofreciendo aplicaciones prometedoras en tareas de análisis de riesgos de privacidad para modelos de aprendizaje automático.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides unirte. nuestro SubReddit de más de 35.000 ml, 41k+ comunidad de Facebook, Canal de discordia, y Boletín electrónicodonde compartimos las últimas noticias sobre investigaciones de IA, interesantes proyectos de IA y más.
Si te gusta nuestro trabajo, te encantará nuestra newsletter.
Mahmoud es un investigador de doctorado en aprendizaje automático. También posee un
Licenciatura en Ciencias Físicas y Maestría en
sistemas de telecomunicaciones y redes. Sus áreas actuales de
Las investigaciones se refieren a la visión por computadora, la predicción del mercado de valores y la profundidad.
aprendiendo. Produjo varios artículos científicos sobre la relación de personas.
identificación y estudio de la robustez y estabilidad de profundidades
redes.