
La síntesis de vista, parte integral de la visión por computadora y los gráficos, permite la reproducción de escenas desde diversas perspectivas similares a la visión humana. Ayuda en tareas como la manipulación de objetos y la navegación al mismo tiempo que fomenta la creatividad. El aprendizaje temprano de la representación neuronal 3D optimizó principalmente los datos 3D directamente, con el objetivo de mejorar las capacidades de síntesis de vistas para aplicaciones más amplias en estos campos. Sin embargo, todos estos métodos existentes dependen en gran medida de la geometría 3D real, lo que limita su aplicabilidad a datos 3D sintéticos a pequeña escala.
Los primeros trabajos en el aprendizaje de representaciones neuronales 3D se centraron en optimizar datos 3D directamente, utilizando vóxeles y nubes de puntos para el aprendizaje de representaciones explícitas. Alternativamente, los métodos asignaron coordenadas espaciales 3D a funciones u ocupaciones de distancia firmadas para el aprendizaje de representación implícita. Sin embargo, estos dependían en gran medida de la geometría 3D real, lo que limitaba su aplicabilidad. Las funciones de renderizado diferenciables mejoraron la escalabilidad con imágenes posadas en múltiples vistas. El entrenamiento directo en conjuntos de datos 3D utilizando nubes de puntos o campos neuronales mejoró la eficiencia, pero encontró desafíos computacionales.
Investigadores del Dyson Robotics Lab, el Imperial College London y la Universidad de Hong Kong presentes EscherNet, un modelo de difusión condicionada de múltiples vistas que controla la transformación precisa de la cámara entre las vistas de referencia y de destino. Aprende representaciones 3D implícitas con codificación posicional de cámara especializada, lo que ofrece generalidad y escalabilidad excepcionales en la síntesis de vistas. A pesar del entrenamiento con un número fijo de vistas de referencia, EscherNet puede generar más de 100 vistas de destino consistentes en una sola GPU. Unifica tareas de reconstrucción 3D de una y varias imágenes.
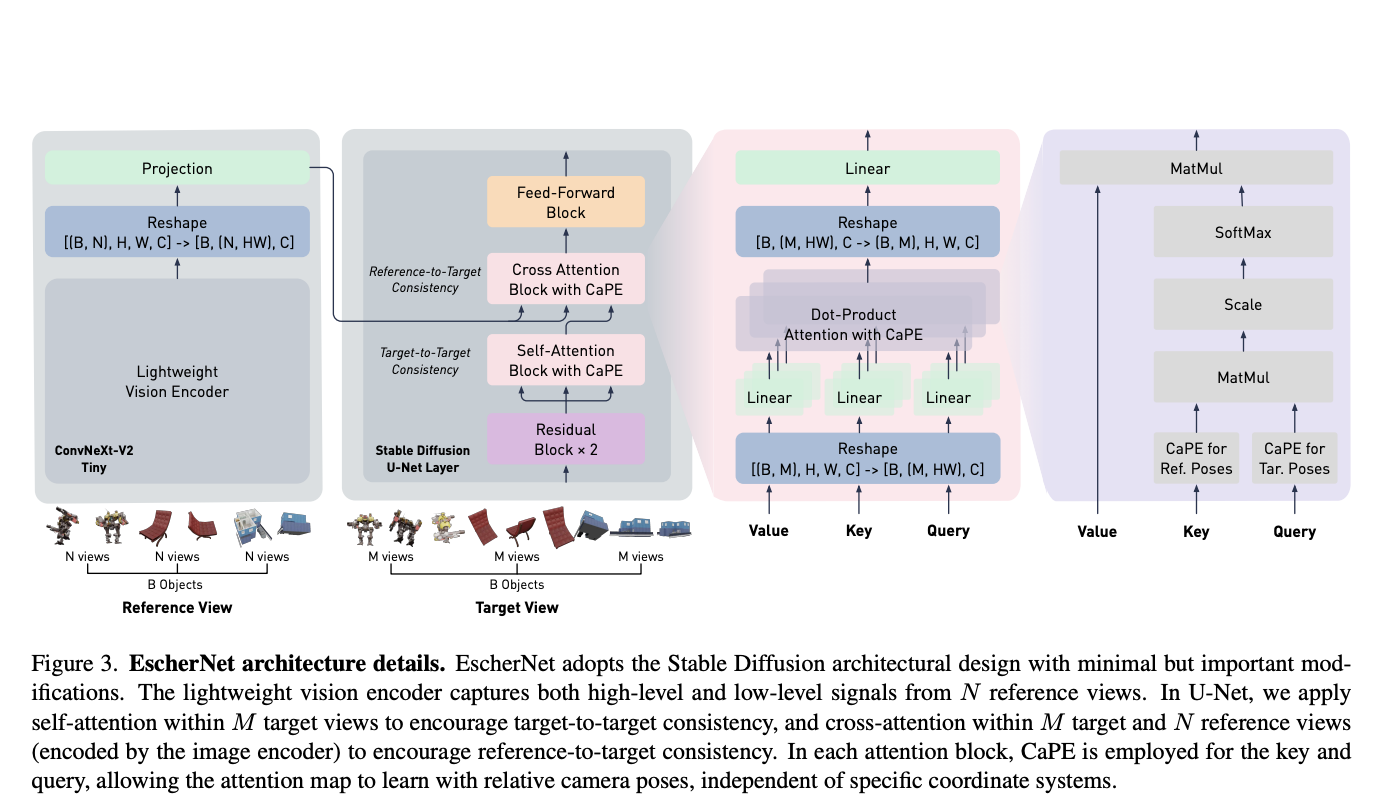
EscherNet Integra un modelo de difusión 2D y codificación posicional de cámara para manejar números arbitrarios de vistas para la síntesis de vistas. Utiliza Stable Diffusion v1.5 como columna vertebral, modificando los bloques de atención personal para garantizar la coherencia entre objetivos en múltiples vistas. Al incorporar la codificación posicional de la cámara (CaPE), EscherNet codifica con precisión las poses de la cámara para cada vista, lo que facilita el aprendizaje relativo de la transformación de la cámara. Logra resultados de alta calidad codificando eficientemente semántica de alto nivel y detalles de textura de bajo nivel a partir de vistas de referencia.

EscherNet demuestra un rendimiento superior en diversas tareas en visión 3D. En la síntesis de vistas novedosas, supera a los modelos de difusión 3D y a los métodos de representación neuronal, logrando resultados de alta calidad con menos vistas de referencia. Además, EscherNet sobresale en generación 3D, superando a los modelos de última generación en la reconstrucción de geometría 3D precisa y visualmente atractiva. Su flexibilidad permite una integración perfecta en procesos de generación de texto a 3D, produciendo resultados consistentes y realistas a partir de indicaciones textuales.
En resumen, los investigadores del Dyson Robotics Lab, el Imperial College London y la Universidad de Hong Kong presentan EscherNet, un modelo de difusión condicionada de vistas múltiples para síntesis de vistas escalables. Al aprovechar la arquitectura 2D de Stable Diffusion y el innovador CaPE, EscherNet aprende de manera efectiva representaciones 3D implícitas de varias vistas de referencia, lo que permite una síntesis consistente de vistas novedosas en 3D. Este enfoque demuestra resultados prometedores para abordar los desafíos en la síntesis de vistas y ofrece potencial para futuros avances en arquitecturas neuronales escalables para la visión 3D.
Revisar la Papel y Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 36k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas

Asjad es consultor interno en Marktechpost. Está cursando B.Tech en ingeniería mecánica en el Instituto Indio de Tecnología, Kharagpur. Asjad es un entusiasta del aprendizaje automático y el aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en la atención médica.