
Los LLM, capacitados en extensos conjuntos de datos públicos, han mostrado un éxito notable en varios campos, pero el agotamiento de los datos públicos de alta calidad es inminente para 2026. Debido a esta escasez, los investigadores combinan conjuntos de datos existentes o generan datos creados por modelos. Sin embargo, aún se deben utilizar abundantes datos de alta calidad debido a limitaciones logísticas o de privacidad. Por ejemplo, BloombergGPT sobresale en finanzas con datos financieros privados que abarcan 40 años. La capacitación colaborativa sobre datos personales descentralizados, sin intercambio directo, surge como un enfoque crítico para respaldar el desarrollo de LLM modernos en medio de la escasez de datos y las preocupaciones sobre la privacidad.
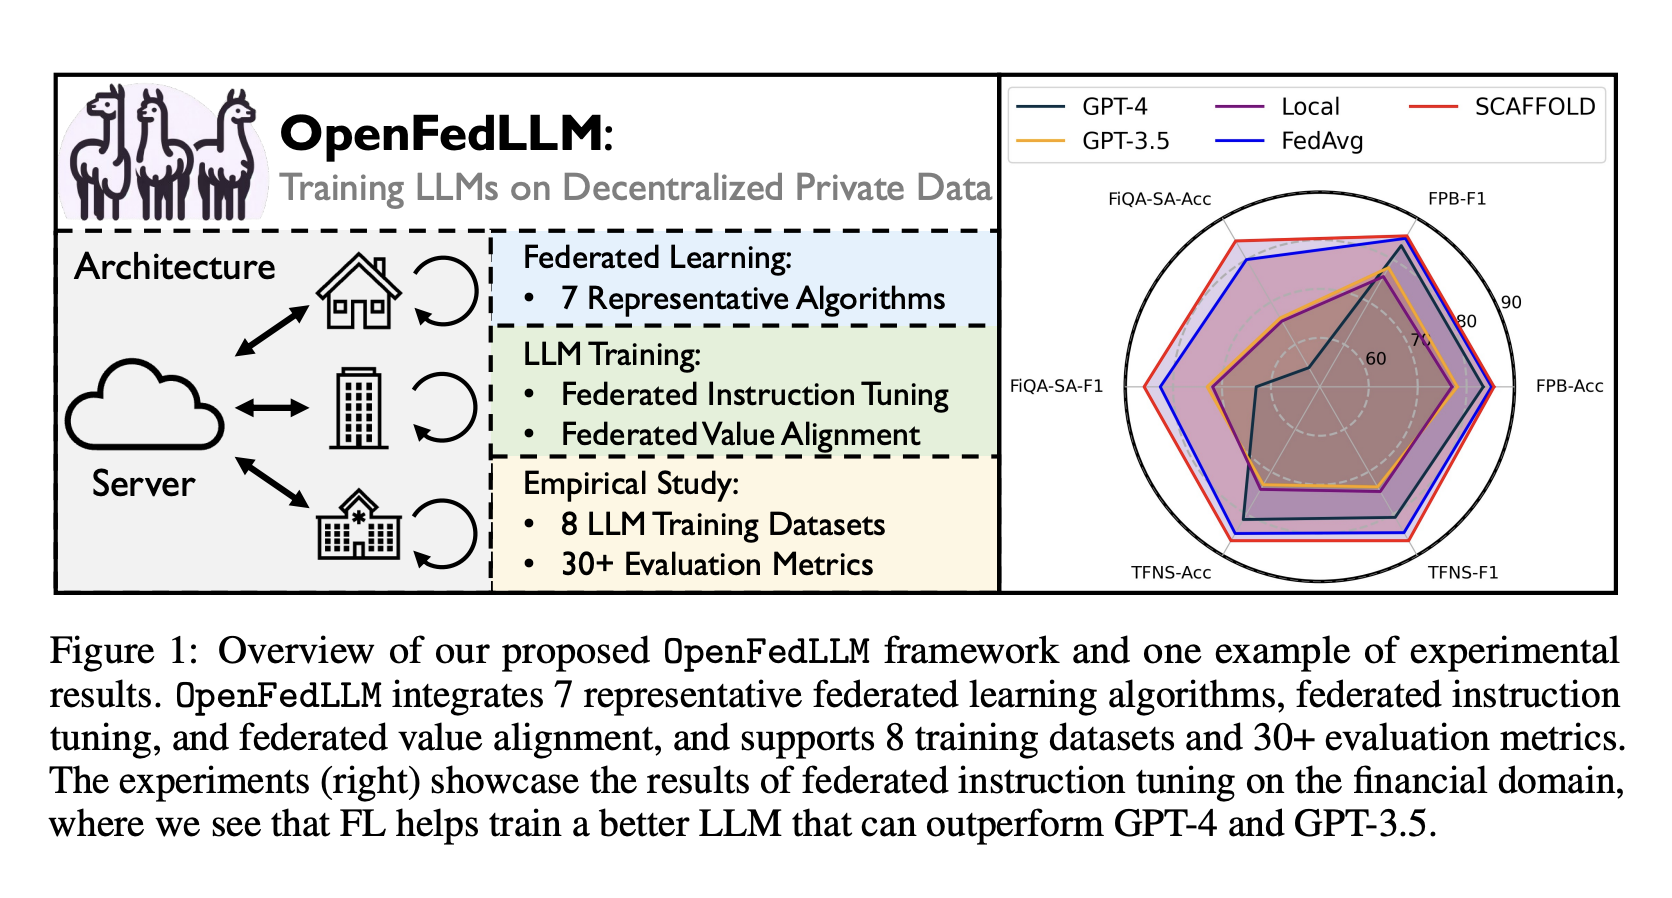
Investigadores de la Universidad Jiao Tong de Shanghai, la Universidad de Zhejiang y el Laboratorio de IA de Shanghai han desarrollado OpenFedLLM, que facilita la capacitación colaborativa y de preservación de la privacidad de los LLM sobre datos privados distribuidos a través del aprendizaje federado FL. OpenFedLLM integra ajuste de instrucciones federadas, alineación de valores y diversos algoritmos FL, ofreciendo una interfaz fácil de usar para las comunidades LLM y FL. Los estudios empíricos demuestran la superioridad de la FL sobre la capacitación individual, especialmente en escenarios con recursos limitados, con aplicaciones potenciales en finanzas.
En los últimos años, los LLM como GPT-3.5/4 y Llama2 han demostrado éxito en varios dominios, normalmente capacitados en tres etapas: capacitación previa en grandes corpus, ajuste de instrucciones y alineación de valores. Sin embargo, el agotamiento de los datos públicos de alta calidad para 2026 ha impulsado la exploración de capacitar a los LLM en datos de propiedad privada. FL ofrece una solución al permitir la capacitación colaborativa sin compartir datos sin procesar. Se han propuesto varios algoritmos FL para mejorar el rendimiento, aunque es necesario comprender mejor su eficacia en la formación LLM. Trabajos anteriores han explorado FL con LLM, pero tienen un alcance limitado. Este estudio proporciona una exploración integral de FL y LLM, que cubre el ajuste de instrucciones, la alineación de valores y múltiples algoritmos de FL, con una evaluación empírica extensa.
Se describe el marco OpenFedLLM, que se centra en la formación de LLM a través de FL preservando al mismo tiempo la privacidad. Se introducen dos componentes clave: ajuste de instrucciones federadas y alineación de valores federados. El ajuste de instrucciones federadas mejora la capacidad de los LLM para seguir instrucciones, mientras que la alineación de valores federados inyecta valores humanos en los modelos. Se integran técnicas de ajuste fino de parámetros eficientes como LoRA para garantizar la eficiencia computacional y de comunicación. El marco sigue protocolos FL estándar, lo que permite una integración perfecta con varios algoritmos FL y facilita la capacitación de modelos colaborativos entre partes distribuidas.

La gestión de datos en FedLLM se vuelve compleja debido a la distribución descentralizada de los datos, lo que requiere métodos de selección matizados. Las preferencias heterogéneas plantean desafíos en la alineación de valores federados (FedVA), lo que sugiere la necesidad de agrupar clientes con valores similares. El FL personalizado surge como una dirección para adaptar los modelos a tareas o valores individuales. La robustez, la seguridad, la preservación de la privacidad y la eficiencia son preocupaciones cruciales en FedLLM, especialmente con la aparición de datos maliciosos y la necesidad de capacitación de modelos a gran escala. La adaptación de FedLLM a configuraciones FL entre silos y dispositivos presenta desafíos y oportunidades, con avances en la compresión de modelos y estrategias de capacitación eficientes que ofrecen soluciones prometedoras para la implementación en dispositivos con recursos limitados.
En el estudio, los investigadores han delineado un enfoque holístico para capacitar a los LLM que utilizan FL en datos privados distribuidos, ofreciendo una vía prometedora en medio de la disminución de los datos públicos. El marco, OpenFedLLM, integra ajuste de instrucciones, alineación de valores, algoritmos FL, conjuntos de datos y métricas de evaluación, lo que facilita una exploración integral. Los análisis empíricos muestran la superioridad de FL sobre la capacitación local, con LLM ajustados de FL que superan incluso a modelos de última generación como GPT-4 en ciertos puntos de referencia. El trabajo aporta valiosos conocimientos y metodologías para aprovechar los datos descentralizados en la formación de LLM.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y noticias de Google. Unirse nuestro SubReddit de 38k+ ML, 41k+ comunidad de Facebook, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Canal de telegramas
También te puede gustar nuestro Cursos GRATUITOS de IA….

A Sana Hassan, pasante de consultoría en Marktechpost y estudiante de doble titulación en IIT Madras, le apasiona aplicar la tecnología y la inteligencia artificial para abordar los desafíos del mundo real. Con un gran interés en resolver problemas prácticos, aporta una nueva perspectiva a la intersección de la IA y las soluciones de la vida real.