
La demanda de cargas de trabajo de inferencia optimizadas nunca ha sido más crítica en el aprendizaje profundo. Encontrarse esconderse, un compilador de aprendizaje profundo de código abierto desarrollado por un equipo dedicado de CentML Inc. Este compilador basado en Python tiene como objetivo agilizar el proceso de compilación, ofreciendo soporte de extremo a extremo para modelos DNN desde PyTorch y ONNX hasta núcleos CUDA eficientes, centrándose en GPU NVIDIA.
Hidet surgió de la investigación presentada en el artículo “Hidet: paradigma de programación de mapeo de tareas para programas tensoriales de aprendizaje profundo”, El compilador aborda el desafío de reducir la latencia de las inferencias de modelos de aprendizaje profundo, un aspecto vital para garantizar un modelo eficiente en una variedad de plataformas, desde servicios en la nube hasta dispositivos de borde.
El desarrollo de Escondite está impulsado por el reconocimiento de que desarrollar programas tensoriales eficientes para operadores de aprendizaje profundo es una tarea compleja, dadas las complejidades de los aceleradores modernos como las GPU NVIDIA y las TPU de Google, junto con la rápida expansión de los tipos de operadores. Si bien los compiladores de aprendizaje profundo existentes, como Apache TVM, aprovechan las primitivas de programación declarativa, Hidet adopta un enfoque único.
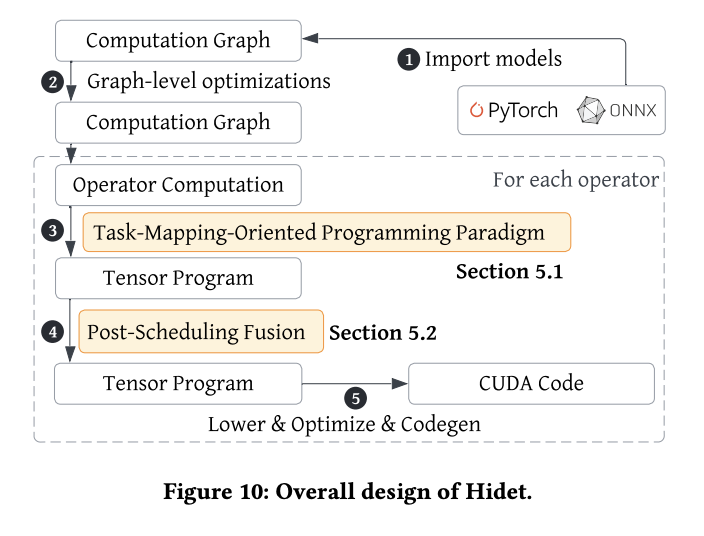
El compilador incorpora el proceso de programación en programas tensoriales, introduciendo asignaciones dedicadas conocidas como asignaciones de tareas. Estas asignaciones de tareas permiten a los desarrolladores definir la asignación de cálculo y el ordenamiento directamente dentro de los programas tensoriales, enriqueciendo las optimizaciones expresables al permitir manipulaciones detalladas a nivel de declaración de programa. Este enfoque innovador se conoce como paradigma de programación de mapeo de tareas.
Además, Hidet introduce una optimización de la fusión posterior a la programación, automatizando el proceso de fusión después de la programación. Esto no sólo permite a los desarrolladores centrarse en la programación de operadores individuales, sino que también reduce significativamente los esfuerzos de ingeniería necesarios para la fusión de operadores. El paradigma también construye un espacio de programación eficiente centrado en el hardware independiente del tamaño de entrada del programa, reduciendo así sustancialmente el tiempo de ajuste.
Amplios experimentos sobre modelos modernos de convolución y transformador muestran el poder de Hidet, superando a los marcos de inferencia DNN de última generación, como ONNX Runtime y el compilador TVM equipado con programadores AutoTVM y Ansor. En promedio, Hidet logra una mejora de 1,22 veces, con una ganancia máxima de rendimiento de 1,48 veces.
Además de su rendimiento superior, Hidet demuestra su eficiencia al reducir significativamente los tiempos de ajuste. En comparación con AutoTVM y Ansor, Hidet reduce los tiempos de sintonización 20 veces y 11 veces, respectivamente.
A medida que Hidet continúa evolucionando, establece nuevos estándares de eficiencia y rendimiento en la compilación de aprendizaje profundo. Con su enfoque de mapeo de tareas y optimización de la fusión, Hidet tiene el potencial de convertirse en una piedra angular en el conjunto de herramientas de los desarrolladores que buscan ampliar los límites del servicio de modelos de aprendizaje profundo.
Niharika es pasante de consultoría técnica en Marktechpost. Es estudiante de tercer año y actualmente cursa su licenciatura en tecnología en el Instituto Indio de Tecnología (IIT), Kharagpur. Es una persona muy entusiasta con un gran interés en el aprendizaje automático, la ciencia de datos y la inteligencia artificial y una ávida lectora de los últimos avances en estos campos.