
La descompilación juega un papel crucial en la ingeniería inversa del software, ya que permite el análisis y la comprensión de ejecutables binarios cuando su código fuente es inaccesible. Esto es particularmente valioso para el análisis de seguridad del software, la detección de errores y la recuperación de código heredado. Sin embargo, las técnicas de descompilación tradicionales a menudo necesitan ayuda para producir código fuente legible por humanos y semánticamente preciso, lo que plantea un desafío importante.
La investigación sobre descompilación ha utilizado tradicionalmente varias herramientas y métodos para traducir el código binario nuevamente al código fuente, aunque con distintos grados de éxito. Estas herramientas, como Ghidra e IDA Pro, destacan en escenarios específicos, pero a menudo necesitan ser revisadas para restaurar el código a un estado fácilmente comprensible para los humanos. Este desafío se ve agravado por la dificultad inherente a la hora de reconstruir con precisión los detalles más finos del código fuente, como los nombres de las variables y la estructura original, incluidos los bucles y las declaraciones condicionales, que normalmente se pierden durante el proceso de compilación.
Investigadores de la Universidad de Ciencia y Tecnología del Sur y la Universidad Politécnica de Hong Kong presentaron LLM4Decompile, que destaca por su enfoque único. Utiliza LLM previamente capacitados en grandes cantidades de código fuente C y el código ensamblador correspondiente, con el objetivo de aprovechar sus capacidades predictivas para reconstruir código fuente preciso y sintácticamente correcto a partir de ejecutables binarios. A diferencia de las herramientas existentes, LLM4Decompile prioriza la ejecutabilidad del código, un aspecto clave de la programación funcional.
El equipo compiló un conjunto de datos de 4 mil millones de tokens, que abarcan una amplia gama de pares de códigos C y ensambladores, para entrenar modelos de diferentes tamaños, desde parámetros de 1B a 33B. Esta extensa capacitación previa tiene como objetivo dotar a los modelos de una comprensión profunda de la estructura y la semántica del código. A diferencia de las herramientas anteriores que a menudo generaban código no funcional o difícil de analizar para los humanos, LLM4Decompile se esfuerza por producir código que se asemeje a la fuente en sintaxis y conserve su esencia ejecutable.
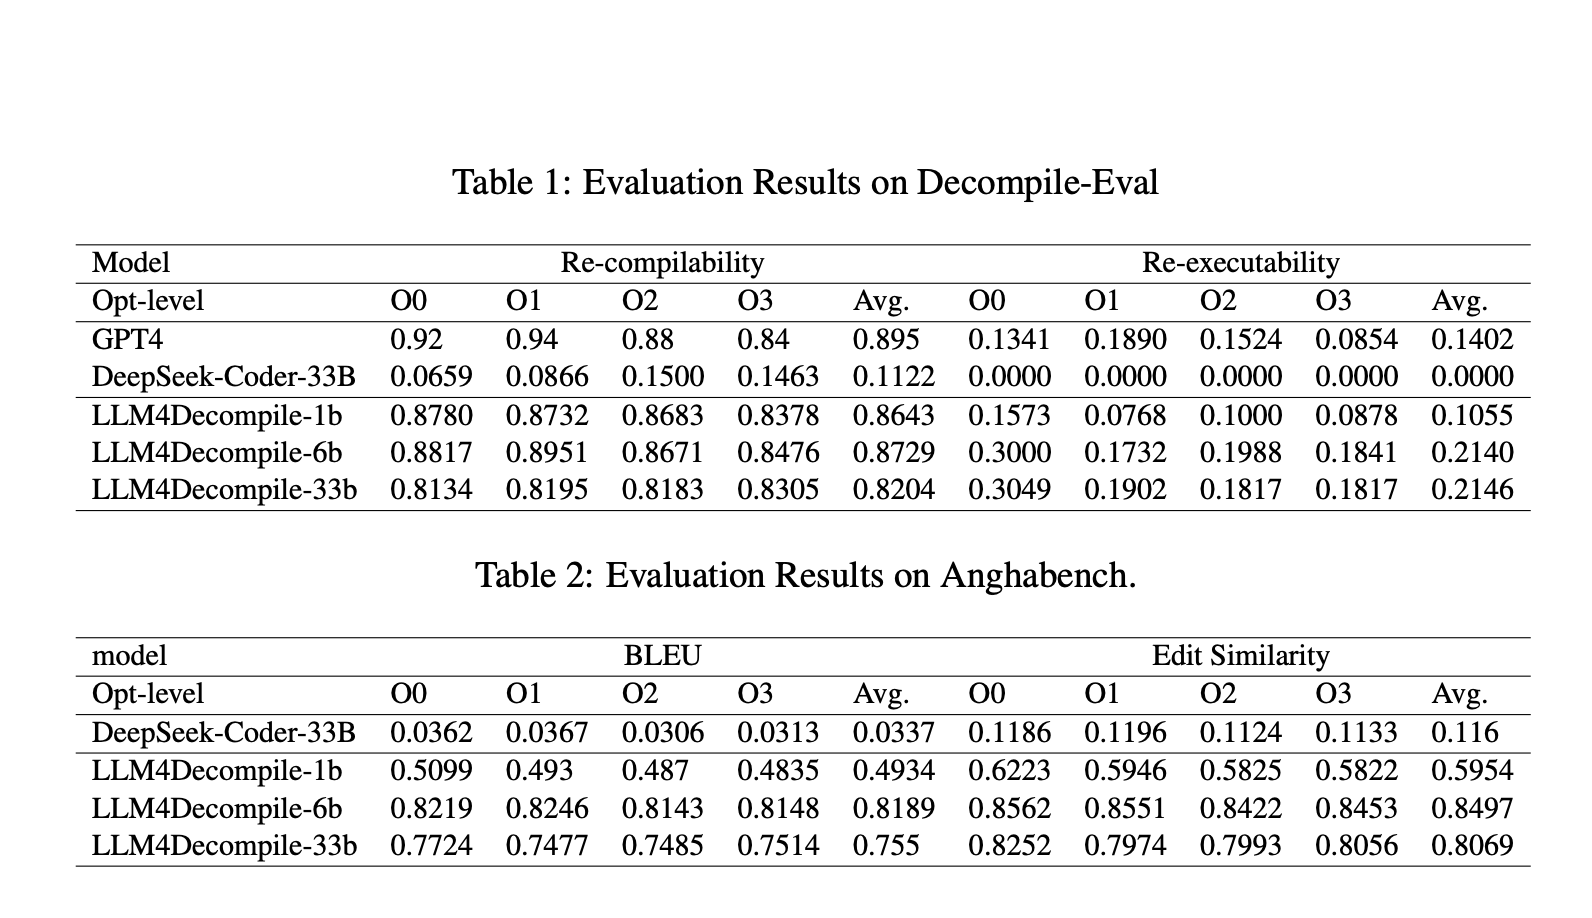
La evaluación de la eficacia de LLM4Decompile es igualmente meticulosa y utiliza el punto de referencia Decompile-Eval recientemente introducido. Este punto de referencia evalúa el código descompilado en dos frentes cruciales: recompilabilidad y reejecutabilidad. Estas métricas dan testimonio de la comprensión del modelo de la semántica del código y su capacidad para generar código sintácticamente correcto. LLM4Decompile logró un hito importante, demostrando la capacidad de descompilar código binario con precisión con una asombrosa tasa de recompilabilidad del 90 % y una notable tasa de reejecutabilidad del 21 % para su modelo 6B. Estas cifras marcan una mejora del 50 % en el rendimiento de descompilación con respecto a su predecesor, GPT-4, lo que subraya los avances en la precisión y utilidad de la descompilación.
En conclusión, la introducción de LLM4Decompile cambia las reglas del juego en la ingeniería de software. Su trabajo no sólo aborda los desafíos inherentes a la descompilación desde hace mucho tiempo, sino que también allana el camino para nuevas vías de investigación y desarrollo. Con su metodología avanzada y su rendimiento impresionante, LLM4Decompile es un faro para proyectos futuros, presagiando un futuro en el que la descompilación puede ser tan matizada y refinada como el código que busca desentrañar. Este es un momento emocionante para la ingeniería de software, con LLM4Decompile liderando el avance hacia un enfoque más sofisticado y efectivo para la descompilación.
Revisar la Papel y GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML

Nikhil es consultor interno en Marktechpost. Está cursando una doble titulación integrada en Materiales en el Instituto Indio de Tecnología de Kharagpur. Nikhil es un entusiasta de la IA/ML que siempre está investigando aplicaciones en campos como los biomateriales y la ciencia biomédica. Con una sólida formación en ciencia de materiales, está explorando nuevos avances y creando oportunidades para contribuir.