
Las funciones profundas son fundamentales en los estudios de visión por computadora, ya que desbloquean la semántica de las imágenes y permiten a los investigadores abordar diversas tareas, incluso en escenarios con datos mínimos. Últimamente, se han desarrollado técnicas para extraer características de diversos tipos de datos como imágenes, texto y audio. Estas características sirven como base para diversas aplicaciones, desde la clasificación hasta el aprendizaje débilmente supervisado, la segmentación semántica, la representación neuronal y el campo de vanguardia de la generación de imágenes. Con su potencial transformador, las características profundas continúan ampliando los límites de lo que es posible en la visión por computadora.
Aunque las características profundas tienen muchas aplicaciones en visión por computadora, a menudo necesitan más resolución espacial para realizar directamente tareas de predicción densa, como segmentación y predicción de profundidad, debido a modelos que agrupan agresivamente información mediante modelos en áreas grandes. Por ejemplo, ResNet-50 condensa una entrada de 224 × 224 píxeles en funciones de 7 × 7 de profundidad. Incluso los Vision Transformers (ViT) de última generación enfrentan desafíos similares, lo que reduce significativamente la resolución. Esta reducción presenta un obstáculo a la hora de aprovechar estas características para tareas que exigen información espacial precisa, como la segmentación o la estimación de profundidad.
Un grupo de investigadores del MIT, Google, Microsoft y Adobe presentaron FeatUp, un marco independiente de tareas y modelos que restaura información espacial perdida en características profundas. Ofrecieron dos variantes de FeatUp: la primera guía funciones con una señal de alta resolución en un solo pase hacia adelante. Por el contrario, el segundo ajusta un modelo implícito a una sola imagen para reconstruir características en cualquier resolución. Estas funciones conservan su semántica original y pueden reemplazar sin problemas las funciones existentes en diversas aplicaciones para generar mejoras en resolución y rendimiento incluso sin necesidad de volver a capacitarlas. FeatUp supera significativamente a otros enfoques de superresolución de imágenes y muestreo superior de funciones en la generación de mapas de activación de clases, predicción de profundidad, etc.
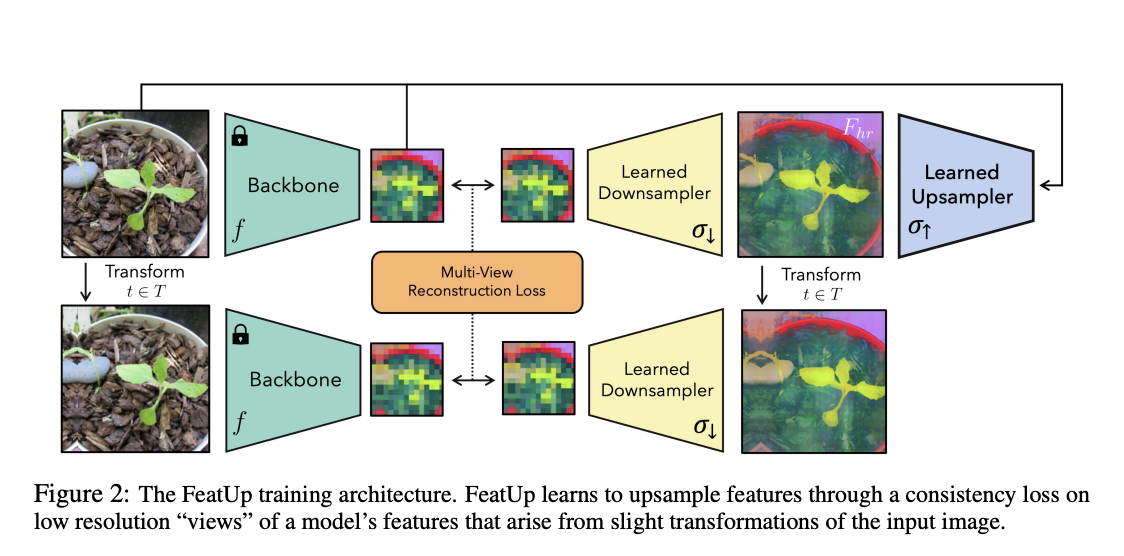
Para las variantes de FeatUp, se ha utilizado una pérdida de coherencia de múltiples vistas con profundas analogías con los NeRF. Los siguientes pasos se consideran en este trabajo de investigación mientras se desarrolla FeatUp:
- Se generaron vistas de características de baja resolución para refinarlas en una única salida de alta resolución. Para ello, la imagen de entrada se alteró con pequeños pads y giros horizontales. El modelo se aplicó a cada imagen transformada para extraer una colección de mapas de características de baja resolución de estas vistas. Proporciona información de subfunciones para entrenar al muestreador.
- Construimos un mapa de características consistente de alta resolución y postulamos que puede reproducir características fluctuantes de baja resolución cuando se reduce la resolución. La reducción de resolución de FeatUp es un análogo directo de la marcha de rayos, que transforma características de alta resolución en características de baja resolución.
- Los upsamplers se entrenan en el conjunto de entrenamiento de ImageNet durante 2000 pasos y las métricas se calculan en 2000 imágenes aleatorias del conjunto de validación. Un ViT-S/16 previamente entrenado congelado también sirvió como característica, extrayendo mapas de activación de clase (CAM) aplicando un clasificador lineal después de la agrupación máxima.
Al comparar las características muestreadas con los resultados reales del modelo utilizando una pérdida de probabilidad gaussiana, se observa que un buen mapa de características de alta resolución debería reconstruir las características observadas en todas las vistas diferentes. Para reducir la huella de memoria y acelerar aún más el entrenamiento de la red implícita de FeatUp, las características que varían espacialmente se comprimen a sus componentes principales superiores k=128. Esta operación de compresión mantiene casi toda la información relevante, ya que los 128 componentes principales explican aproximadamente el 96% de la variación en las características de una sola imagen. Esta optimización acelera el tiempo de entrenamiento hasta 60 veces para modelos como ResNet-50 y facilita lotes más grandes sin comprometer la calidad de las funciones.
En conclusión, FeatUp, un marco independiente de tareas y modelos que restaura información espacial perdida en características profundas, es un enfoque novedoso para muestrear características profundas utilizando consistencia de múltiples vistas. Puede aprender funciones de alta calidad con resoluciones arbitrarias. Resuelve un problema crítico en la visión por computadora: los modelos profundos aprenden características de alta calidad pero a resoluciones espaciales prohibitivamente bajas. Ambas variantes de FeatUp superan una amplia gama de líneas de base en el aprendizaje por transferencia de sonda lineal, la interpretabilidad del modelo y la segmentación semántica de un extremo a otro.
Revisar la Papel y Blog del MIT. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 39k+ ML

Sajjad Ansari es un estudiante de último año de IIT Kharagpur. Como entusiasta de la tecnología, profundiza en las aplicaciones prácticas de la IA centrándose en comprender el impacto de las tecnologías de IA y sus implicaciones en el mundo real. Su objetivo es articular conceptos complejos de IA de una manera clara y accesible.