
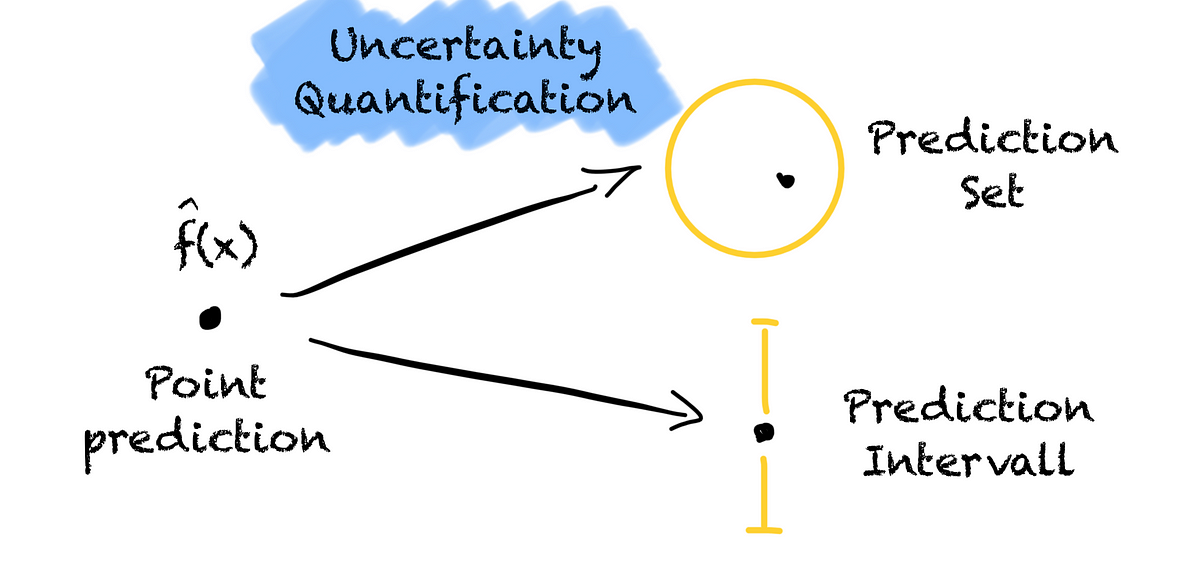
Ahora sabemos por qué necesitamos la cuantificación de la incertidumbre para el aprendizaje automático y qué tan útiles son las regiones de predicción.
Pero, ¿cómo podemos cuantificar la incertidumbre de un modelo de ML?
Supongamos que trabajamos para una empresa que clasifica imágenes de animales para comprender con qué frecuencia aparece una determinada especie en una región determinada. Antiguamente, una persona miraba cada imagen para identificar al animal. Este proceso tomó mucho tiempo. Por tanto, construimos un modelo que clasifica al animal en cada imagen. Para que sea útil, el modelo debe ser correcto al menos en el 90 % de los casos.
Pero la tarea es complicada. Nuestro modelo de clasificación multiclase solo alcanza una precisión del 85% en nuestro conjunto de pruebas.
Por lo tanto, queremos que el modelo nos diga qué tan seguro es acerca de una imagen. Si el modelo está seguro de que su predicción es correcta con una probabilidad superior al 90 %, utilizamos la clase predicha del modelo. De lo contrario, tendremos una mirada humana a la imagen.
Pero ¿cómo podemos saber si el modelo es cierto o no? Empecemos primero con un enfoque ingenuo.
Muchos modelos de clasificación generan la puntuación de probabilidad de cada clase. Tomémoslos y confiemos en ellos. Cada vez que el modelo clasifica una imagen con una probabilidad superior a 0,9, confiamos en el modelo. Si la probabilidad es menor, le damos la imagen a un humano.
Le damos al modelo una imagen de un perro. El modelo cree que se trata de un perro con una probabilidad de 0,95. El modelo parece muy seguro. Entonces confiamos en el modelo.
Sin embargo, para una imagen de un gato, el modelo piensa que la imagen muestra una jirafa con una probabilidad de 0,8. Dado que la probabilidad del modelo está por debajo de nuestro objetivo del 90% de probabilidad, descartamos la imagen y se la damos a un humano.
Hacemos esto con muchas imágenes que la modelo no ha visto antes.
Finalmente, probamos la cobertura de este enfoque para todas las imágenes que clasificamos. Desafortunadamente, debemos darnos cuenta de que tenemos una cobertura menor que nuestro objetivo del 90%. Hay demasiadas predicciones erróneas.
que hicimos mal?
Bueno, confiamos en la puntuación de probabilidad del modelo.
Pero la puntuación no está calibrada y no garantiza la cobertura correcta de nuevos datos. La puntuación se calibraría si todas las clasificaciones con una puntuación de 0,9 contuvieran la clase verdadera el 90% de las veces. Pero este no es el caso de la puntuación de “probabilidad” de los modelos de clasificación.
Muchos enfoques tienen el mismo problema, por ejemplo, la escala de Platt, la regresión isotónica, los intervalos predictivos bayesianos o el bootstrapping. Estos no están calibrados o se basan en fuertes supuestos de distribución.
Pero ¿cómo podemos conseguir una cobertura garantizada?
Parece que sólo necesitamos elegir un umbral mejor.
Por lo tanto, seguimos usando la puntuación de “probabilidad” del modelo. Pero esta vez cambiamos la puntuación por una medida de incertidumbre. En este caso, uno menos la puntuación de “probabilidad” del modelo para una clase, es decir, 1 — s(x). Cuanto menor sea el valor, más seguro estará el modelo de que su predicción sea la clase verdadera.
Para determinar el umbral, utilizamos datos que el modelo no ha visto durante el entrenamiento. Calculamos la puntuación de no conformidad de la clase verdadera para cada muestra del conjunto. Luego clasificamos estas puntuaciones de bajas (el modelo es seguro) a altas (el modelo es incierto).
Tenga en cuenta que en esta etapa solo calculamos la puntuación de no conformidad para la clase verdadera. No nos importa si el modelo era correcto o incorrecto.
Usamos la distribución resultante para calcular el umbral. q_sombrero donde el 90% de las puntuaciones son inferiores. Nuestro percentil 90 de la distribución. Una puntuación por debajo de este umbral cubrirá la clase verdadera con una probabilidad del 90 %.
Ahora, cada vez que hacemos una nueva predicción, calculamos la puntuación de no conformidad para todas las clases. Luego colocamos todas las clases con una puntuación inferior al umbral en nuestro conjunto de predicción. Eso es todo.
Con esto podemos garantizar que la clase verdadera estará en el conjunto de predicción con una probabilidad del 90%.
Para nuestra clasificación de animales, confiamos en todas las predicciones que solo contienen un animal en el conjunto de predicciones. Si el conjunto de predicción contiene más de una clase, dejamos que una persona verifique nuestra clasificación.