
La capacidad de una IA para comprender e imitar el entorno físico se basa en su modelo mundial (WM), una representación abstracta de ese entorno. El modelo incluye objetos, escenas, agentes, leyes físicas, información espaciotemporal e interacciones dinámicas. En concreto, permite predecir los estados del mundo en respuesta a determinadas acciones. Por lo tanto, diseñar un modelo mundial genérico puede ayudar con el desarrollo de contenido interactivo, como crear escenas virtuales realistas para películas y juegos, crear experiencias de realidad virtual y realidad aumentada y realizar simulaciones de capacitación e instrucción.
Los LLM modernos pueden generar un habla humana que suene natural y representar modelos mundiales más tradicionales en trabajos de razonamiento específicos. Algunas partes del mundo, incluida la física intuitiva (como la predicción del flujo de fluidos a partir de su viscosidad), deben poder explicarse y describirse eficientemente únicamente con palabras. Además, los LLM dependen de patrones en datos textuales sin comprender las realidades subyacentes que representan porque necesitan una comprensión más sólida de la dinámica física y temporal del mundo real.
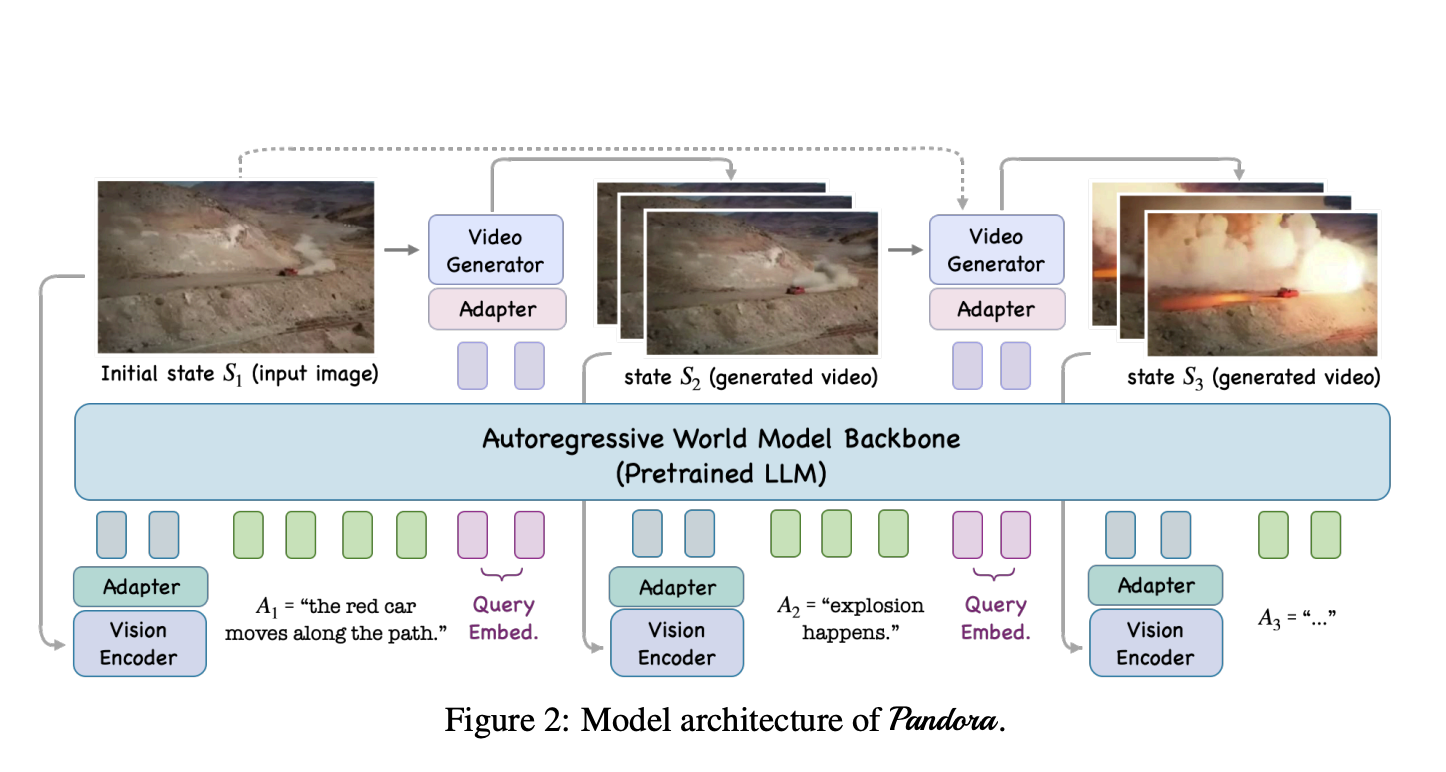
Un estudio de Matrix.org presenta Pandora, un primer paso innovador hacia un modelo mundial genérico. Pandora utiliza la generación de vídeo para imitar situaciones mundiales en diferentes dominios y permite el control en tiempo real mediante acciones arbitrarias descritas en un lenguaje común. El algoritmo Pandora, un modelo autorregresivo que ingresa texto de formato libre y estados de video anteriores y produce nuevos estados de video como salida, representa un salto significativo en el campo de la IA y el aprendizaje automático.
Este ‘enfoque por etapas’ implica dos pasos principales: datos masivos de video y texto para un entrenamiento previo a gran escala para aprender una comprensión general del mundo y cómo hacer simulaciones de video consistentes, y datos secuenciales de texto y video de alta calidad para ajustar las instrucciones. para aprender a controlar el texto durante la generación de vídeo en cualquier momento. Es esencial tener en cuenta que la etapa de preentrenamiento permite el entrenamiento distinto de modelos de video y texto. Dado que los LLM preexistentes y los modelos de generación (de texto a) video han logrado generalización de dominio y consistencia de video, se pueden reciclar fácilmente. Siguiendo los pasos anteriores, todo lo que se requiere es combinar los modelos de idioma y video, agregar los módulos adicionales necesarios y realizar algunos ajustes ligeros. En particular, el ‘modelo de lenguaje Vicuna-7B-v1.5’ y el ‘modelo de texto a video DynamiCrafter’ sirven como base de esta publicación. El ‘modelo de lenguaje Vicuna-7B-v1.5’ es un modelo de lenguaje de última generación que proporciona una sólida columna vertebral para la parte de generación de texto del modelo mundial, mientras que el ‘modelo de texto a video DynamiCrafter’ es un modelo de vanguardia que permite la generación de videos realistas basados en las entradas de texto.
De cara al futuro, se prevé que los modelos previamente entrenados con funciones más grandes y avanzadas, como GPT-4 y Sora, producirán resultados aún mejores. Los investigadores están sintetizando numerosos simuladores de robótica, actividades interiores y exteriores, conducción, juegos 2D y más, y resubtitulando películas de dominio general para crear un gran conjunto heterogéneo de datos secuenciales de estados de acción para la instrucción. etapa de sintonización. Estos avances futuros son muy prometedores para el desarrollo y la aplicación continuos del modelo mundial genérico.
Los investigadores demuestran la amplia gama de resultados de Pandora en varias disciplinas. Este modelo muestra varias cualidades deseadas que no se ven en modelos anteriores. Los resultados también muestran mucho margen de mejora con respecto a la formación futura a mayor escala.
- Pandora puede generar vídeos en muchos dominios generales, incluidos interiores/exteriores, naturales/urbanos, humanos/robots, 2D/3D y muchos más. El uso extensivo de vídeo para el preentrenamiento es en gran medida responsable de la generalización de este dominio.
- Para influir en el futuro del planeta, Pandora utiliza acciones del lenguaje natural como insumos al crear videos. Fundamentalmente, esto difiere de las versiones anteriores de conversión de texto a video, que solo podían aceptar sugerencias de texto al comienzo del video. La promesa del modelo mundial de facilitar el desarrollo de contenido interactivo y mejorar el razonamiento y la planificación sólidos se cumple a través del control sobre la marcha. Esto es posible gracias a la arquitectura autorregresiva del modelo, que permite la entrada de texto en cualquier momento; la columna vertebral de LLM previamente entrenada, que reconoce cualquier expresión de texto; y la etapa de ajuste de instrucciones, mejorando significativamente la eficacia del control.
- El ajuste de instrucciones utilizando datos de alta calidad permite aprender un control de acción eficiente y transferirlo a varios dominios no observados. El equipo muestra que las reglas definidas en un dominio se pueden extender fácilmente a estados en otros dominios completamente diferentes.
- Los métodos actuales de producción de video que se basan en topologías de difusión generalmente generan videos de cierta duración (digamos, 2 segundos).
- Pandora puede aumentar infinitamente y automáticamente la duración del video combinando el modelo de video previamente entrenado con la columna vertebral autorregresiva LLM.
Los investigadores destacan que Pandora aún se encuentra en sus primeras etapas como puerta de entrada a GWM. Si bien muestra resultados prometedores, también tiene algunas limitaciones. Por ejemplo, necesita ayuda para comprender las reglas físicas y el sentido común, crear videos consistentes y simular escenarios complicados. Estas son áreas que requieren más investigación y desarrollo para mejorar el rendimiento y la aplicabilidad del modelo.
Sin embargo, el equipo cree que una capacitación más extensa con modelos troncales robustos (como GPT-4 y Sora) dará como resultado una mejor generalización del dominio, consistencia de video y controlabilidad de las acciones. También están entusiasmados con ampliar el modelo para incluir más modalidades, como audio, para mejorar sus capacidades de medición y simulación. Estos desarrollos futuros tienen el potencial de mejorar el rendimiento del modelo y ampliar significativamente sus aplicaciones.
Revisar la Papel, GitHub, Modelo, y Proyecto. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 43k+ ML | Además, consulte nuestro Plataforma de eventos de IA
Dhanshree Shenwai es ingeniero en informática y tiene una buena experiencia en empresas de tecnología financiera que cubren el ámbito financiero, tarjetas y pagos y banca con un gran interés en las aplicaciones de IA. Le entusiasma explorar nuevas tecnologías y avances en el mundo en evolución de hoy que facilita la vida de todos.