
El desafío crucial de mejorar las capacidades de razonamiento lógico en modelos de lenguajes grandes (LLM) es fundamental para lograr un razonamiento similar al humano, un paso fundamental hacia la realización de la Inteligencia General Artificial (AGI). Los LLM actuales exhiben un rendimiento impresionante en diversas tareas de lenguaje natural, pero a menudo necesitan un razonamiento más lógico, lo que limita su aplicabilidad en escenarios que requieren una comprensión profunda y una resolución estructurada de problemas. Superar este desafío es esencial para avanzar en la investigación de la IA, ya que permitiría a los sistemas inteligentes abordar tareas complejas de resolución de problemas, toma de decisiones y pensamiento crítico con mayor precisión y confiabilidad. La urgencia de este desafío se ve subrayada por la creciente demanda de sistemas de inteligencia artificial que puedan gestionar complejas tareas de razonamiento en diversos campos, incluido el procesamiento del lenguaje natural, el razonamiento automatizado, la robótica y la investigación científica.
Los métodos actuales como Logic-LM y CoT han mostrado limitaciones en el manejo eficiente de tareas de razonamiento complejas. Logic-LM depende de solucionadores externos para la traducción, lo que podría provocar una pérdida de información, mientras que CoT lucha por equilibrar la precisión y la recuperación, lo que afecta su desempeño general en las tareas de razonamiento lógico. A pesar de los avances recientes, estos métodos aún no logran capacidades de razonamiento óptimas debido a limitaciones inherentes al diseño.
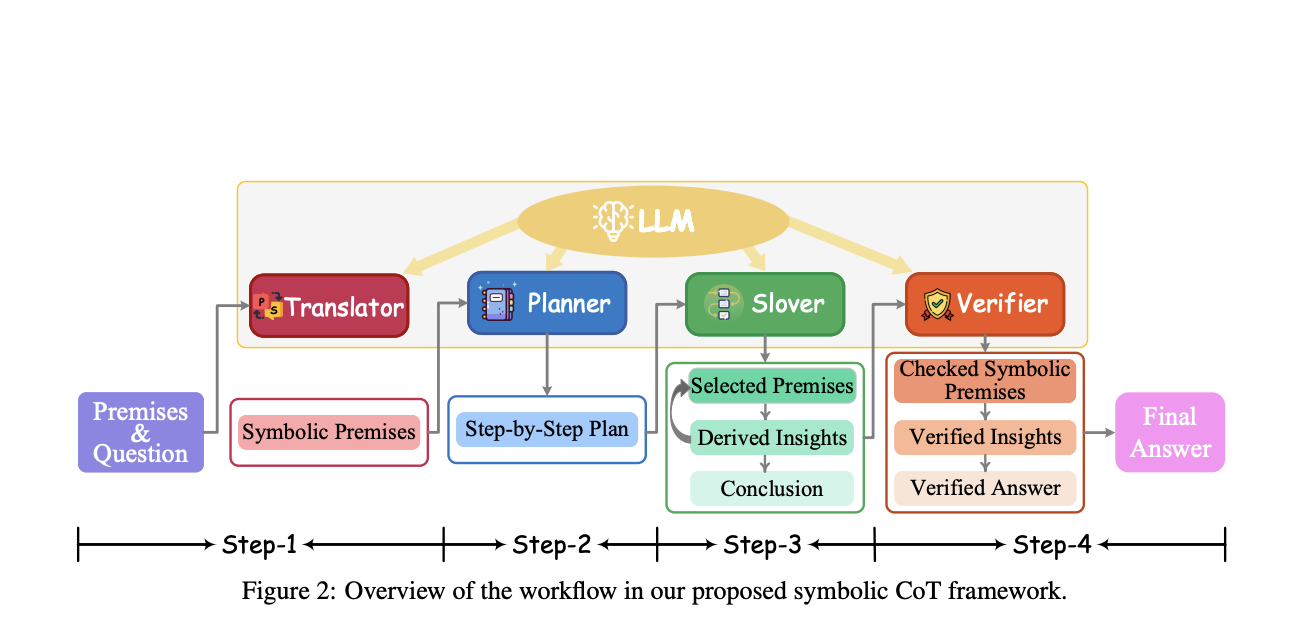
Investigadores de la Universidad Nacional de Singapur, la Universidad de California y la Universidad de Auckland presentan el Cadena de pensamiento simbólica (SymbCoT) marco, que combina expresiones simbólicas con indicaciones de CoT para mejorar el razonamiento lógico en los LLM. SymbCoT supera los desafíos de los métodos existentes al incorporar reglas y representaciones simbólicas, lo que conduce a una mejora significativa del razonamiento. El diseño innovador de SymbCoT ofrece una solución más versátil y eficiente para tareas de razonamiento complejas, superando las líneas de base existentes como CoT y Logic-LM en métricas de rendimiento.
SymbCoT utiliza estructuras y reglas simbólicas para guiar los procesos de razonamiento, mejorando la capacidad del modelo para abordar tareas lógicas complejas. El marco emplea un enfoque de planificar y luego resolver, dividiendo las preguntas en componentes más pequeños para un razonamiento eficiente. Detalla los recursos computacionales necesarios para la implementación, mostrando la escalabilidad y practicidad del método propuesto.
SymbolCoT demuestra mejoras significativas con respecto a las líneas base Naive, CoT y Logic-LM, logrando ganancias del 21,56 %, 6,11 % y 3,53 % en GPT-3.5, y del 22,08 %, 9,31 % y 7,88 % en GPT-4, respectivamente. La única excepción ocurre con el conjunto de datos FOLIO en GPT-3.5, donde no supera a Logic-LM, lo que indica desafíos en el razonamiento no lineal para los LLM. A pesar de esto, el método supera consistentemente todas las líneas de base en ambos conjuntos de datos con GPT-4, superando notablemente a Logic-LM en un promedio del 7,88 %, lo que destaca mejoras sustanciales en tareas de razonamiento complejas. Además, en tareas de expresión simbólica de CO en dos conjuntos de datos, el método supera a CoT y Logic-LM en un 13,32 % y 3,12 %, respectivamente, lo que subraya su versatilidad en el razonamiento simbólico.

En conclusión, el marco SymbCoT representa un avance significativo en la investigación de la IA al mejorar las capacidades de razonamiento lógico en los LLM. Los hallazgos del artículo tienen amplias implicaciones para las aplicaciones de IA, con posibles direcciones de investigación futuras que se centran en explorar lenguajes simbólicos adicionales y optimizar el marco para una adopción más amplia en los sistemas de IA. La investigación contribuye al campo al superar un desafío crítico en el razonamiento lógico, allanando el camino para sistemas de inteligencia artificial más avanzados con capacidades de razonamiento mejoradas.
Revisar la Papel. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo. Únete a nuestro Canal de telegramas, Canal de discordiay LinkedIn Grarriba.
Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro SubReddit de 43k+ ML | Además, consulte nuestro Plataforma de eventos de IA

Aswin AK es pasante de consultoría en MarkTechPost. Está cursando su doble titulación en el Instituto Indio de Tecnología de Kharagpur. Le apasiona la ciencia de datos y el aprendizaje automático, y aporta una sólida formación académica y experiencia práctica en la resolución de desafíos interdisciplinarios de la vida real.