
La verificación de autoría (AV) es fundamental en el procesamiento del lenguaje natural (NLP), ya que determina si dos textos comparten la misma autoría. Esta tarea tiene una importancia inmensa en varios dominios, como la ciencia forense, la literatura y la seguridad digital. El enfoque tradicional de la AV se basaba en gran medida en el análisis estilométrico, que utiliza características lingüísticas y estilísticas como la longitud de las palabras y las oraciones y las frecuencias de las palabras funcionales para diferenciar entre los autores. Con modelos de aprendizaje profundo como BERT y RoBERTa, el campo ha experimentado un cambio de paradigma. Estos enfoques modernos aprovechan los patrones complejos en el texto y ofrecen un rendimiento superior en comparación con las técnicas estilométricas convencionales.
El principal desafío en la verificación de autoría es determinar la autoría con precisión y brindar explicaciones claras y confiables para las decisiones de clasificación. Los modelos de verificación de autoría actuales se centran principalmente en la clasificación binaria, que a menudo carece de transparencia. Esta falta de explicabilidad es una brecha en el interés académico y una preocupación práctica. Analizar el proceso de toma de decisiones de los modelos de IA es esencial para generar confianza y confiabilidad, en particular para identificar y abordar sesgos ocultos. Por lo tanto, los modelos de verificación de autoría deben ser precisos e interpretables, y brindar información detallada sobre sus procesos de toma de decisiones.
Los métodos existentes para la automatización de vehículos han avanzado significativamente con el uso de modelos de aprendizaje profundo. BERT y RoBERTa, por ejemplo, han demostrado un rendimiento superior al de las técnicas estilométricas tradicionales. Sin embargo, estos modelos a menudo necesitan proporcionar explicaciones claras para sus clasificaciones. Esta es una limitación crítica a medida que aumenta la demanda de inteligencia artificial explicable. Los avances recientes han explorado la integración de la explicabilidad en estos modelos, pero aún quedan desafíos para garantizar que las explicaciones sean consistentes y relevantes en varios escenarios.
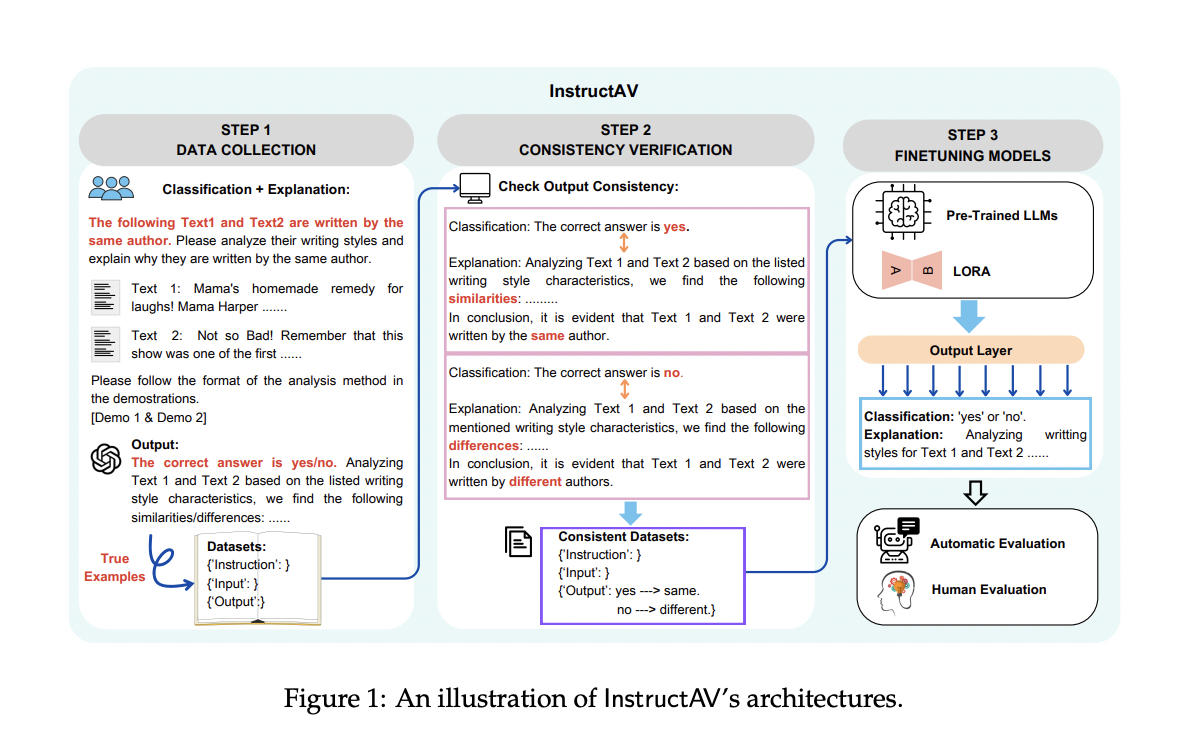
El equipo de investigación de Tecnología y Diseño de Sistemas de Información de la Universidad de Tecnología y Diseño de Singapur presentó un enfoque novedoso llamado InstructAVcuyo objetivo es mejorar la precisión y la explicabilidad en las tareas de verificación de autoría. InstructAV utiliza modelos de lenguaje grandes (LLM) con un método de ajuste fino de parámetros eficiente (PEFT). Este marco innovador está diseñado para alinear las decisiones de clasificación con explicaciones transparentes y comprensibles, lo que marca un avance significativo en el campo. El marco InstructAV integra la explicabilidad directamente en el proceso de clasificación, lo que garantiza que los modelos realicen predicciones precisas y brinden información profunda sobre su lógica de toma de decisiones. Esta doble capacidad es esencial para avanzar en la inteligencia artificial explicable.
La metodología detrás de InstructAV implica tres pasos principales: recopilación de datos, verificación de la consistencia y ajuste fino con el método de adaptación de bajo rango (LoRA). Inicialmente, el marco se centra en la agregación de datos explicativos para muestras de AV. Este enfoque utiliza las etiquetas de clasificación binaria disponibles en los conjuntos de datos de AV existentes. A continuación, se implementa un estricto control de calidad para verificar la alineación y la consistencia de las explicaciones con las etiquetas de clasificación correspondientes. La etapa final implica la síntesis de datos de ajuste de instrucciones, que combina las etiquetas de clasificación recopiladas y sus explicaciones asociadas. Estos datos compuestos son la base para el ajuste fino de los LLM mediante la técnica de adaptación LoRA. Garantiza que los modelos estén ajustados con precisión para las tareas de AV al tiempo que mejora su capacidad para proporcionar explicaciones coherentes y confiables.
El rendimiento de InstructAV se evaluó a través de experimentos exhaustivos en diversos conjuntos de datos de AV, incluidos IMDB, Twitter y Yelp Reviews. El marco demostró una precisión de vanguardia en la verificación de autoría, superando significativamente a los modelos de referencia. Por ejemplo, InstructAV con LLaMA-2-7B logró una precisión del 91,4 % en el conjunto de datos de IMDB, una mejora sustancial con respecto a la línea base de mayor rendimiento, BERT, que obtuvo un 67,7 %. InstructAV logró una alta precisión de clasificación y estableció nuevos puntos de referencia en la generación de explicaciones coherentes y fundamentadas para sus hallazgos. Los puntajes ROUGE-1 y ROUGE-2 destacaron el desempeño superior de InstructAV en lograr la superposición de contenido tanto a nivel de palabras como de frases. El puntaje BERT indicó que las explicaciones generadas por InstructAV eran semánticamente más cercanas a las etiquetas de explicación, lo que subraya la capacidad del marco para producir explicaciones lingüísticamente coherentes y contextualmente relevantes.
En conclusión, el marco InstructAV aborda desafíos críticos en las tareas de los vehículos autónomos al combinar una alta precisión de clasificación con la capacidad de generar explicaciones detalladas y confiables. El doble enfoque en el rendimiento y la interpretabilidad posiciona a InstructAV como una solución de vanguardia en el dominio. El equipo de investigación ha realizado varias contribuciones clave, incluido el desarrollo del marco InstructAV, la creación de tres conjuntos de datos de ajuste de instrucciones con explicaciones lingüísticas confiables y la demostración de la efectividad del marco a través de evaluaciones tanto automatizadas como humanas. La capacidad de InstructAV para mejorar la precisión de la clasificación al tiempo que proporciona explicaciones de alta calidad marca un progreso crucial en la investigación de los vehículos autónomos.
Revisar la PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro Boletin informativo..
No olvides unirte a nuestro Subreddit de más de 46 000 millones de usuarios
Encuentra lo próximo Seminarios web sobre IA aquí

Aswin AK es pasante de consultoría en MarkTechPost. Está cursando su doble titulación en el Instituto Indio de Tecnología de Kharagpur. Le apasionan la ciencia de datos y el aprendizaje automático, y cuenta con una sólida formación académica y experiencia práctica en la resolución de desafíos reales interdisciplinarios.
