
Comprender el lenguaje hablado para los modelos de lenguaje grandes (LLM) es fundamental para crear interacciones más naturales e intuitivas con las máquinas. Si bien los modelos tradicionales son excelentes para las tareas basadas en texto, tienen dificultades para comprender el habla humana, lo que limita su potencial en aplicaciones del mundo real, como asistentes de voz, atención al cliente y herramientas de accesibilidad. Mejorar la comprensión del habla puede mejorar las interacciones entre humanos y máquinas, en particular en situaciones que exigen procesamiento en tiempo real.
Homebrew Research presenta Llama3-s v0.2 para abordar el desafío de comprender el lenguaje hablado en el procesamiento del lenguaje natural. Los modelos de lenguaje actuales se centran predominantemente en el texto, con capacidades limitadas en el procesamiento del lenguaje hablado. Los modelos de comprensión del habla existentes a menudo fallan en situaciones que involucran acentos complejos, ruido de fondo o entradas de audio extendidas.
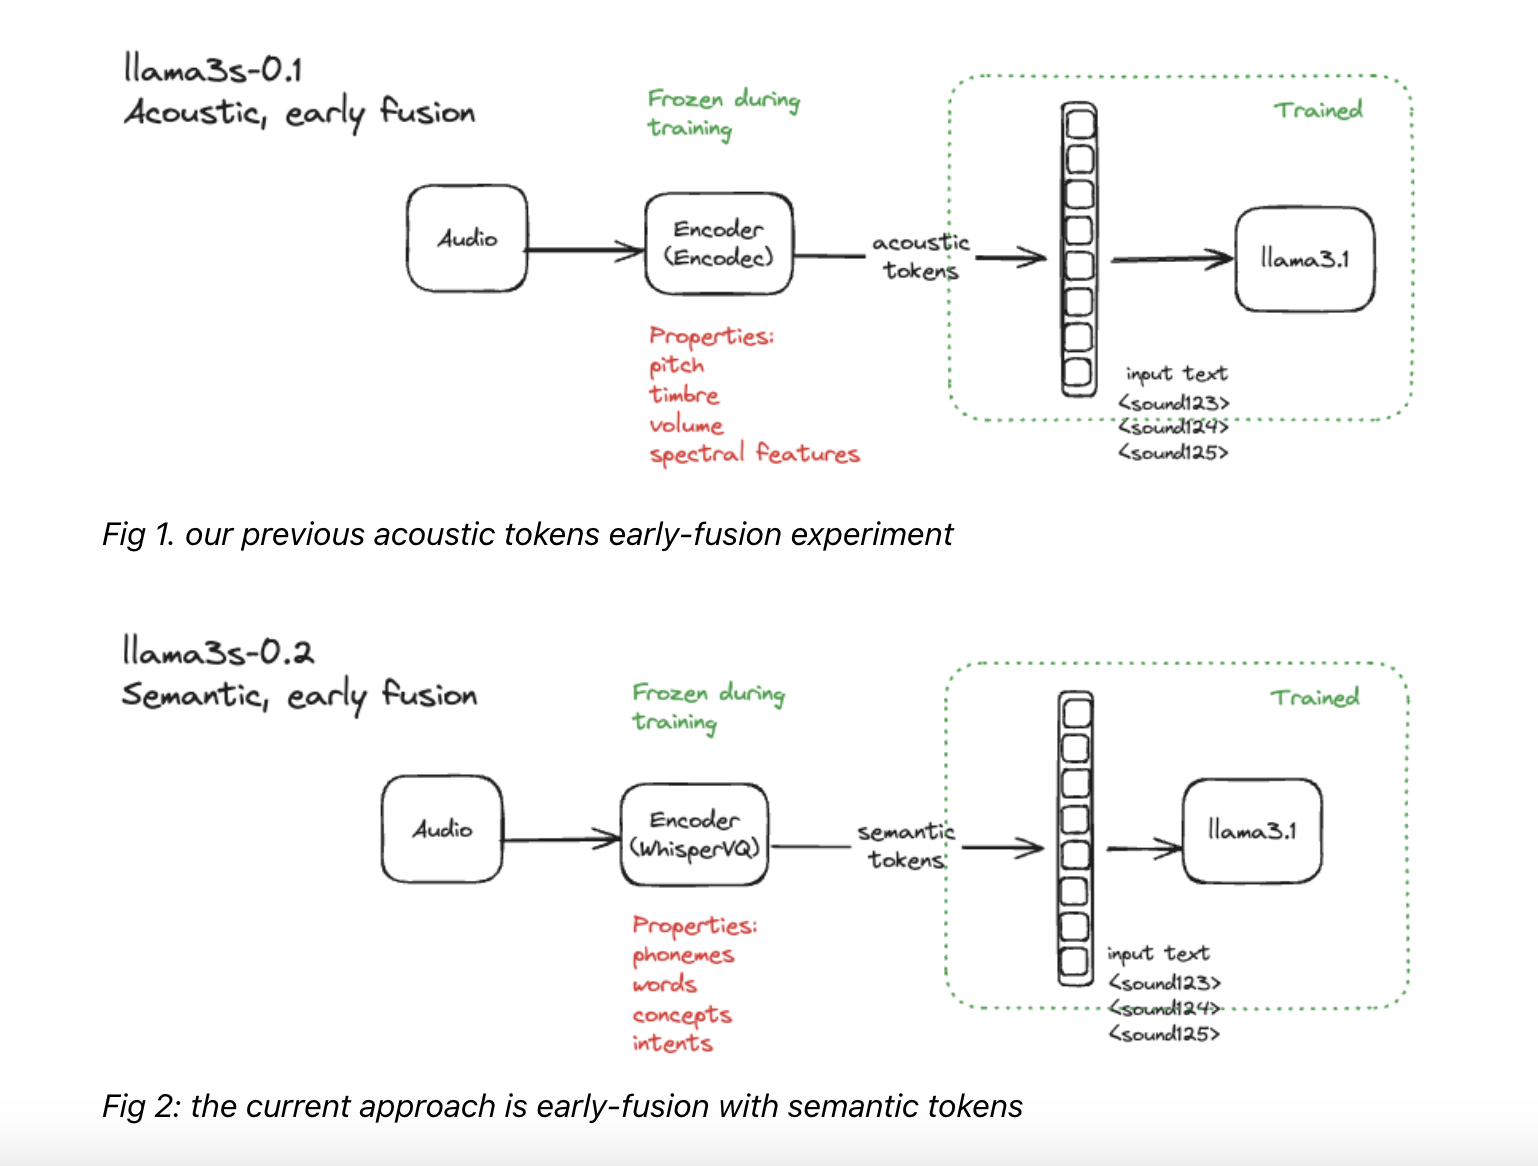
Llama3-s v0.2 se basa en la base del modelo de lenguaje Llama 3.1, introduciendo mejoras significativas diseñadas específicamente para mejorar la comprensión del habla. El modelo utiliza un codificador de audio entrenado previamente (como WhisperVQ) para convertir el audio hablado en representaciones numéricas que el modelo de lenguaje puede procesar. Este enfoque de entrenamiento multimodal, que integra entradas de texto y audio, permite que Llama3-s v0.2 aprenda la relación entre el lenguaje hablado y su representación textual de manera eficiente. Además, el modelo emplea tokens semánticos, representaciones abstractas de los significados de las palabras, para mejorar su comprensión del contenido subyacente del habla.
Llama3-s v0.2 mejora sus capacidades de comprensión del habla mediante un proceso de entrenamiento de dos etapas. En la primera etapa, el modelo se entrena previamente con datos de habla reales utilizando el conjunto de datos MLS-10k, que incluye 10 horas de habla humana multilingüe sin etiquetar. Este entrenamiento previo mejora la capacidad del modelo para generalizar a través de tokens semánticos. En la segunda etapa, el modelo se somete a un ajuste de instrucciones con una mezcla de datos sintéticos, utilizando WhisperVQ para codificar semánticamente los datos de habla. Este enfoque ayuda al modelo a aprender de una combinación de indicaciones de instrucción de habla y de transcripción. Llama3-s v0.2 demuestra resultados prometedores, superando a los modelos existentes en múltiples puntos de referencia, incluidas las evaluaciones ALPACA-Audio y AudioBench. Llama3-s v.02 logró una puntuación promedio de 3,53 en la evaluación ALPACA-Audio, que parece superar a SALMONN, Qwen-Audio y WavLLM. A pesar de sus avances, el modelo aún enfrenta limitaciones, como la sensibilidad al ruido de fondo y dificultades con entradas de audio extendidas.
En conclusión, Llama3-s v0.2 representa un avance significativo en el desarrollo de modelos de lenguaje multimodales capaces de comprender el lenguaje hablado. Al integrar entradas de audio y texto y emplear tokenización semántica avanzada, el modelo supera las limitaciones que enfrentan los modelos de lenguaje tradicionales en la comprensión del habla. Los experimentos demostrados por Llama3-s v0.2 abren nuevas posibilidades para aplicaciones del mundo real, haciendo que la tecnología sea más accesible y fácil de usar.
Echa un vistazo a la Detalles. Todo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa..
No olvides unirte a nuestro Más de 49 000 suscriptores de ML en Reddit
Encuentra lo próximo Seminarios web sobre IA aquí
Pragati Jhunjhunwala es pasante de consultoría en MarktechPost. Actualmente está cursando su licenciatura en tecnología en el Instituto Indio de Tecnología (IIT) de Kharagpur. Es una entusiasta de la tecnología y tiene un gran interés en el ámbito de las aplicaciones de software y ciencia de datos. Siempre está leyendo sobre los avances en diferentes campos de la IA y el ML.