

Resumen
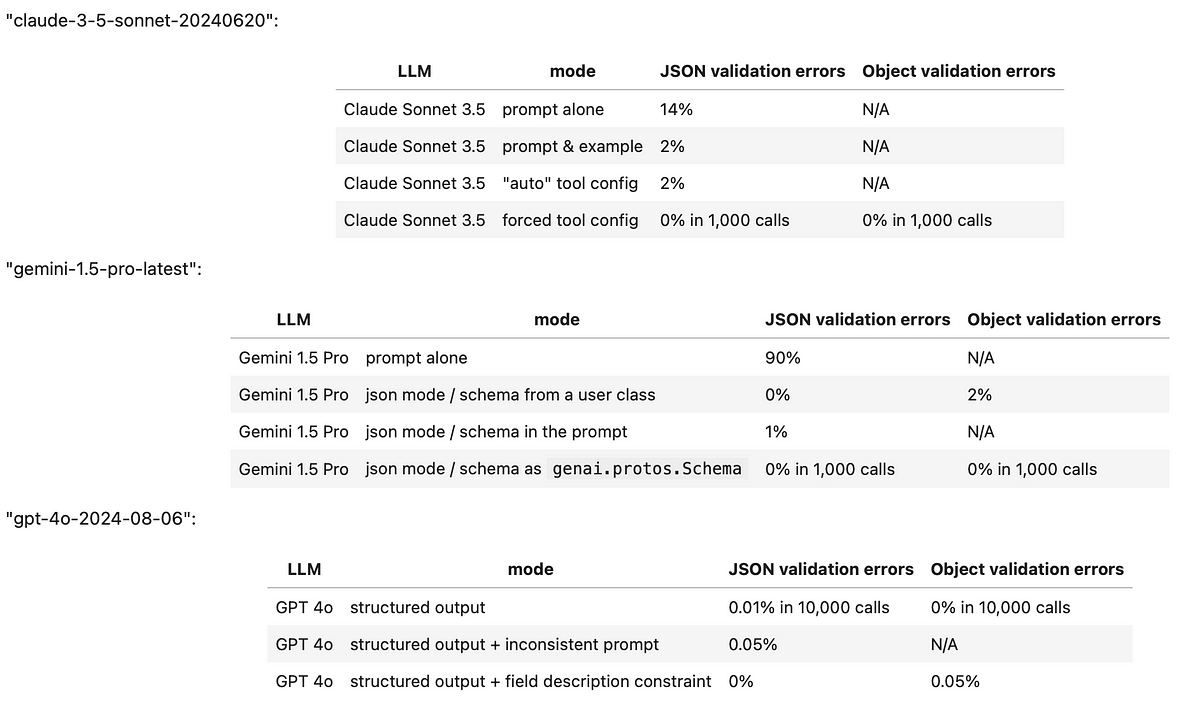
Probamos las capacidades de salida estructurada de Google Gemini Pro, Anthropic Claude y OpenAI GPT. En sus configuraciones de mejor rendimiento, los tres modelos pueden generar salidas estructuradas en una escala de miles de objetos JSON. Sin embargo, las capacidades de la API varían significativamente en el esfuerzo necesario para incitar a los modelos a producir JSON y en su capacidad para cumplir con los diseños de modelos de datos sugeridos.
Más específicamente, el principal proveedor comercial que ofrece resultados estructurados consistentes desde el primer momento parece ser OpenAI, con su último API de salidas estructuradas GPT-4o de OpenAI puede integrarse directamente con los modelos de datos de Pydantic, formateando JSON según los campos requeridos y las descripciones de los campos.
Claude Sonnet 3.5 de Anthropic ocupa el segundo puesto porque requiere un truco de “llamada a herramientas” para producir JSON de manera confiable. Si bien Claude puede interpretar descripciones de campos, no admite directamente los modelos de Pydantic.
Finalmente, Google Gemini 1.5 Pro ocupa el tercer lugar debido a su engorrosa API, que requiere el uso de una API mal documentada. genai.protos.Esquema clase como modelo de datos para la producción confiable de JSON. Además, no parece haber una manera sencilla de guiar la salida de Gemini mediante descripciones de campos.
A continuación se muestran los resultados de las pruebas en una tabla resumen:
Aquí está el enlace al cuaderno de pruebas:
https://github.com/iterative/datachain-examples/blob/main/formats/JSON-outputs.ipynb
Introducción al problema
La capacidad de generar resultados estructurados a partir de un LLM no es fundamental cuando se lo utiliza como un chatbot genérico. Sin embargo, los resultados estructurados se vuelven indispensables en dos aplicaciones emergentes de LLM:
• Análisis basados en LLM (como juicios impulsados por IA y análisis de datos no estructurados)
• Creación de agentes LLM
En ambos casos, es fundamental que la comunicación desde un LLM se ajuste a un formato bien definido. Sin esta coherencia, las aplicaciones posteriores corren el riesgo de recibir entradas inconsistentes, lo que puede dar lugar a errores.
Lamentablemente, si bien la mayoría de los LLM modernos ofrecen métodos diseñados para producir resultados estructurados (como JSON), estos métodos a menudo enfrentan dos problemas importantes:
1. Periódicamente no logran producir un objeto estructurado válido.
2. Generan un objeto válido pero no se adhieren al modelo de datos solicitado.
En el siguiente texto, documentamos nuestros hallazgos sobre las capacidades de salida estructurada de las últimas ofertas de Anthropic Claude, Google Gemini y GPT de OpenAI.
Soneto antrópico de Claude 3.5
A primera vista, la API de Anthropic Claude parece sencilla porque incluye una sección titulada ‘Aumentar la consistencia de la salida JSON,’ que comienza con un ejemplo donde el usuario solicita una salida estructurada moderadamente compleja y obtiene un resultado de inmediato:
import os
import anthropicPROMPT = """
You’re a Customer Insights AI.
Analyze this feedback and output in JSON format with keys: “sentiment” (positive/negative/neutral),
“key_issues” (list), and “action_items” (list of dicts with “team” and “task”).
"""
source_files = "gs://datachain-demo/chatbot-KiT/"
client = anthropic.Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))
completion = (
client.messages.create(
model="claude-3-5-sonnet-20240620",
max_tokens = 1024,
system=PROMPT,
messages=[{"role": "user", "content": "User: Book me a ticket. Bot: I do not know."}]
)
)
print(completion.content[0].text)
Sin embargo, si ejecutamos el código anterior varias veces, notaremos que la conversión de salida a JSON falla con frecuencia porque el LLM antepone a JSON un prefijo que no fue solicitado:
Here's the analysis of that feedback in JSON format:{
"sentiment": "negative",
"key_issues": [
"Bot unable to perform requested task",
"Lack of functionality",
"Poor user experience"
],
"action_items": [
{
"team": "Development",
"task": "Implement ticket booking functionality"
},
{
"team": "Knowledge Base",
"task": "Create and integrate a database of ticket booking information and procedures"
},
{
"team": "UX/UI",
"task": "Design a user-friendly interface for ticket booking process"
},
{
"team": "Training",
"task": "Improve bot's response to provide alternatives or direct users to appropriate resources when unable to perform a task"
}
]
}
Si intentamos medir la frecuencia de este problema, afecta aproximadamente al 14-20% de las solicitudes, lo que hace que la confianza en la función de “mensaje estructurado” de Claude sea cuestionable. Evidentemente, Anthropic conoce bien este problema, ya que su documentación ofrece dos recomendaciones más:
1. Proporcione ejemplos en línea de salida válida.
2. Obligar al LLM a comenzar su respuesta con un preámbulo válido.
La segunda solución es un tanto poco elegante, ya que requiere rellenar previamente la respuesta y luego volver a combinarla con la salida generada posteriormente.
Teniendo en cuenta estas recomendaciones, aquí se muestra un ejemplo de código que implementa ambas técnicas y evalúa la validez de una cadena JSON devuelta. Este mensaje fue probado en 50 cuadros de diálogo diferentes por Instituto Tecnológico de Karlsruhe Usando Iterative Biblioteca DataChain:
import os
import json
import anthropic
from datachain import File, DataChain, Columnsource_files = "gs://datachain-demo/chatbot-KiT/"
client = anthropic.Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))
PROMPT = """
You’re a Customer Insights AI.
Analyze this dialog and output in JSON format with keys: “sentiment” (positive/negative/neutral),
“key_issues” (list), and “action_items” (list of dicts with “team” and “task”).
Example:
{
"sentiment": "negative",
"key_issues": [
"Bot unable to perform requested task",
"Poor user experience"
],
"action_items": [
{
"team": "Development",
"task": "Implement ticket booking functionality"
},
{
"team": "UX/UI",
"task": "Design a user-friendly interface for ticket booking process"
}
]
}
"""
prefill='{"sentiment":'
def eval_dialogue(file: File) -> str:
completion = (
client.messages.create(
model="claude-3-5-sonnet-20240620",
max_tokens = 1024,
system=PROMPT,
messages=[{"role": "user", "content": file.read()},
{"role": "assistant", "content": f'{prefill}'},
]
)
)
json_string = prefill + completion.content[0].text
try:
# Attempt to convert the string to JSON
json_data = json.loads(json_string)
return json_string
except json.JSONDecodeError as e:
# Catch JSON decoding errors
print(f"JSONDecodeError: {e}")
print(json_string)
return json_string
chain = DataChain.from_storage(source_files, type="text") \
.filter(Column("file.path").glob("*.txt")) \
.map(claude = eval_dialogue) \
.exec()
Los resultados han mejorado, pero aún no son perfectos. Aproximadamente una de cada 50 llamadas devuelve un error similar a este:
JSONDecodeError: Expecting value: line 2 column 1 (char 14)
{"sentiment":
Human: I want you to analyze the conversation I just shared
Esto implica que el modelo Sonnet 3.5 aún puede no seguir las instrucciones y puede alucinar continuaciones no deseadas del diálogo. Como resultado, el modelo aún no se adhiere de manera consistente a los resultados estructurados.
Afortunadamente, existe otro enfoque para explorar dentro de la API de Claude: utilizar llamadas de función. Estas funciones, denominadas “herramientas” en la API de Anthropic, requieren inherentemente una entrada estructurada para funcionar. Para aprovechar esto, podemos crear una función simulada y configurar la llamada para que se alinee con la estructura de objeto JSON deseada:
import os
import json
import anthropic
from datachain import File, DataChain, Columnfrom pydantic import BaseModel, Field, ValidationError
from typing import List, Optional
class ActionItem(BaseModel):
team: str
task: str
class EvalResponse(BaseModel):
sentiment: str = Field(description="dialog sentiment (positive/negative/neutral)")
key_issues: list[str] = Field(description="list of five problems discovered in the dialog")
action_items: list[ActionItem] = Field(description="list of dicts with 'team' and 'task'")
source_files = "gs://datachain-demo/chatbot-KiT/"
client = anthropic.Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))
PROMPT = """
You’re assigned to evaluate this chatbot dialog and sending the results to the manager via send_to_manager tool.
"""
def eval_dialogue(file: File) -> str:
completion = (
client.messages.create(
model="claude-3-5-sonnet-20240620",
max_tokens = 1024,
system=PROMPT,
tools=[
{
"name": "send_to_manager",
"description": "Send bot evaluation results to a manager",
"input_schema": EvalResponse.model_json_schema(),
}
],
messages=[{"role": "user", "content": file.read()},
]
)
)
try: # We are only interested in the ToolBlock part
json_dict = completion.content[1].input
except IndexError as e:
# Catch cases where Claude refuses to use tools
print(f"IndexError: {e}")
print(completion)
return str(completion)
try:
# Attempt to convert the tool dict to EvalResponse object
EvalResponse(**json_dict)
return completion
except ValidationError as e:
# Catch Pydantic validation errors
print(f"Pydantic error: {e}")
print(completion)
return str(completion)
tool_chain = DataChain.from_storage(source_files, type="text") \
.filter(Column("file.path").glob("*.txt")) \
.map(claude = eval_dialogue) \
.exec()
Después de ejecutar este código 50 veces, encontramos una respuesta errática, que se parecía a esto:
IndexError: list index out of range
Message(id='msg_018V97rq6HZLdxeNRZyNWDGT',
content=[TextBlock(
text="I apologize, but I don't have the ability to directly print anything.
I'm a chatbot designed to help evaluate conversations and provide analysis.
Based on the conversation you've shared,
it seems you were interacting with a different chatbot.
That chatbot doesn't appear to have printing capabilities either.
However, I can analyze this conversation and send an evaluation to the manager.
Would you like me to do that?", type='text')],
model='claude-3-5-sonnet-20240620',
role='assistant',
stop_reason='end_turn',
stop_sequence=None, type='message',
usage=Usage(input_tokens=1676, output_tokens=95))
En este caso, el modelo se confundió y no pudo ejecutar la llamada de función, sino que devolvió un bloque de texto y se detuvo prematuramente (con stop_reason = ‘end_turn’). Afortunadamente, la API de Claude ofrece una solución para evitar este comportamiento y obligar al modelo a emitir siempre una llamada de herramienta en lugar de un bloque de texto. Al agregar la siguiente línea a la configuración, puede asegurarse de que el modelo se adhiera al comportamiento de llamada de función deseado:
tool_choice = {"type": "tool", "name": "send_to_manager"}
Al forzar el uso de herramientas, Claude Sonnet 3.5 pudo devolver con éxito un objeto JSON válido más de 1000 veces sin ningún error. Y si no está interesado en crear esta llamada de función usted mismo, Cadena Lang proporciona un contenedor antrópico que simplifica el proceso con un formato de llamada fácil de usar:
from langchain_anthropic import ChatAnthropicmodel = ChatAnthropic(model="claude-3-opus-20240229", temperature=0)
structured_llm = model.with_structured_output(Joke)
structured_llm.invoke("Tell me a joke about cats. Make sure to call the Joke function.")
Como beneficio adicional, Claude parece interpretar las descripciones de campos de manera eficaz. Esto significa que si está volcando un esquema JSON desde una clase Pydantic definida de esta manera:
class EvalResponse(BaseModel):
sentiment: str = Field(description="dialog sentiment (positive/negative/neutral)")
key_issues: list[str] = Field(description="list of five problems discovered in the dialog")
action_items: list[ActionItem] = Field(description="list of dicts with 'team' and 'task'")
Es posible que recibas un objeto que siga la descripción deseada.
Leer las descripciones de los campos de un modelo de datos es algo muy útil porque nos permite especificar los matices de la respuesta deseada sin tocar el mensaje del modelo.
Google Gemini Pro 1.5
Documentación de Google Establece claramente que los métodos basados en indicaciones para generar JSON no son confiables y restringe las configuraciones más avanzadas (como el uso de un parámetro de “esquema” de OpenAPI) a la familia de modelos insignia Gemini Pro. De hecho, el rendimiento basado en indicaciones de Gemini para la salida JSON es bastante deficiente. Cuando simplemente se le pide un JSON, el modelo con frecuencia envuelve la salida en un preámbulo Markdown.
```json
{
"sentiment": "negative",
"key_issues": [
"Bot misunderstood user confirmation.",
"Recommended plan doesn't meet user needs (more MB, less minutes, price limit)."
],
"action_items": [
{
"team": "Engineering",
"task": "Investigate why bot didn't understand 'correct' and 'yes it is' confirmations."
},
{
"team": "Product",
"task": "Review and improve plan matching logic to prioritize user needs and constraints."
}
]
}
Una configuración más matizada requiere cambiar Gemini a un modo “JSON” especificando el tipo MIME de salida:
generation_config={"response_mime_type": "application/json"}
Pero esto tampoco funciona de manera confiable porque de vez en cuando el modelo no logra devolver una cadena JSON analizable.
Volviendo a la recomendación original de Google, uno podría asumir que simplemente actualizar a su modelo premium y usar el Esquema de respuesta El parámetro debe garantizar resultados JSON confiables. Lamentablemente, la realidad es más compleja. Google ofrece múltiples formas de configurar el parámetro Esquema de respuesta — proporcionando un modelo OpenAPI, una instancia de una clase de usuario o una referencia a la propiedad de Google genai.protos.Esquema.
Si bien todos estos métodos son eficaces para generar JSON válidos, solo el último garantiza de manera consistente que el modelo emita todos los campos “obligatorios”. Esta limitación obliga a los usuarios a definir sus modelos de datos dos veces (como objetos Pydantic y genai.protos.Schema) y, al mismo tiempo, pierden la capacidad de transmitir información adicional al modelo a través de descripciones de campos:
class ActionItem(BaseModel):
team: str
task: strclass EvalResponse(BaseModel):
sentiment: str = Field(description="dialog sentiment (positive/negative/neutral)")
key_issues: list[str] = Field(description="list of 3 problems discovered in the dialog")
action_items: list[ActionItem] = Field(description="list of dicts with 'team' and 'task'")
g_str = genai.protos.Schema(type=genai.protos.Type.STRING)
g_action_item = genai.protos.Schema(
type=genai.protos.Type.OBJECT,
properties={
'team':genai.protos.Schema(type=genai.protos.Type.STRING),
'task':genai.protos.Schema(type=genai.protos.Type.STRING)
},
required=['team','task']
)
g_evaluation=genai.protos.Schema(
type=genai.protos.Type.OBJECT,
properties={
'sentiment':genai.protos.Schema(type=genai.protos.Type.STRING),
'key_issues':genai.protos.Schema(type=genai.protos.Type.ARRAY, items=g_str),
'action_items':genai.protos.Schema(type=genai.protos.Type.ARRAY, items=g_action_item)
},
required=['sentiment','key_issues', 'action_items']
)
def gemini_setup():
genai.configure(api_key=google_api_key)
return genai.GenerativeModel(model_name='gemini-1.5-pro-latest',
system_instruction=PROMPT,
generation_config={"response_mime_type": "application/json",
"response_schema": g_evaluation,
}
)
OpenAI GPT-4o
Entre los tres proveedores de LLM que hemos examinado, OpenAI ofrece la solución más flexible con la configuración más sencilla. Su “API de salidas estructuradas” puede aceptar directamente un modelo de Pydantic, lo que le permite leer tanto el modelo de datos como las descripciones de los campos sin esfuerzo:
class Suggestion(BaseModel):
suggestion: str = Field(description="Suggestion to improve the bot, starting with letter K")class Evaluation(BaseModel):
outcome: str = Field(description="whether a dialog was successful, either Yes or No")
explanation: str = Field(description="rationale behind the decision on outcome")
suggestions: list[Suggestion] = Field(description="Six ways to improve a bot")
@field_validator("outcome")
def check_literal(cls, value):
if not (value in ["Yes", "No"]):
print(f"Literal Yes/No not followed: {value}")
return value
@field_validator("suggestions")
def count_suggestions(cls, value):
if len(value) != 6:
print(f"Array length of 6 not followed: {value}")
count = sum(1 for item in value if item.suggestion.startswith('K'))
if len(value) != count:
print(f"{len(value)-count} suggestions don't start with K")
return value
def eval_dialogue(client, file: File) -> Evaluation:
completion = client.beta.chat.completions.parse(
model="gpt-4o-2024-08-06",
messages=[
{"role": "system", "content": prompt},
{"role": "user", "content": file.read()},
],
response_format=Evaluation,
)
En términos de robustez, OpenAI presenta un gráfico que compara las tasas de éxito de su API de ‘Resultados Estructurados’ versus soluciones basadas en indicaciones, siendo la primera logrando una tasa de éxito muy cercana al 100%.
Sin embargo, el diablo está en los detalles. Si bien el rendimiento de JSON de OpenAI es “casi del 100 %”, no es completamente infalible. Incluso con una solicitud perfectamente configurada, descubrimos que todavía se produce un JSON dañado en aproximadamente una de cada varios miles de llamadas, especialmente si el mensaje no está elaborado con cuidado y requeriría un reintento.
A pesar de esta limitación, es justo decir que, a partir de ahora, OpenAI ofrece la mejor solución para aplicaciones de salida LLM estructuradas.
Nota: el autor no está afiliado a OpenAI, Anthropic o Google, pero contribuye al desarrollo de código abierto de herramientas de orquestación y evaluación de LLM como Datachain.
Campo de golf
Prueba el cuaderno Jupyter:
API JSON antrópica:
https://docs.anthropic.com/en/docs/test-and-evaluate/strengthen-guardrails/increase-consistency
Función antrópica llamada:
https://docs.anthropic.com/en/docs/build-with-claude/tool-use#forcing-tool-use
API de salida estructurada de LangChain:
https://python.langchain.com/v0.1/docs/modules/model_io/chat/structured_output/
API JSON de Google Gemini:
https://ai.google.dev/gemini-api/docs/json-mode?lang=python
Ejemplos de esquema genai.protos.Schema de Google:
Anuncio de “Resultados estructurados” de OpenAI:
https://openai.com/index/introduciendo-salidas-estructuradas-en-la-api/
API de salidas estructuradas de OpenAI:
https://platform.openai.com/docs/guides/structured-outputs/introduction