
Los recientes avances en el uso de modelos de lenguaje de visión a gran escala (VLM) y modelos de lenguaje (LLM) han tenido un impacto significativo en el aprendizaje por refuerzo (RL) y la robótica. Estos modelos han demostrado su utilidad en el aprendizaje de políticas de robots, el razonamiento de alto nivel y la automatización de la generación de funciones de recompensa para el aprendizaje de políticas. Este progreso ha reducido notablemente la necesidad de conocimientos específicos del dominio que normalmente se exigen a los investigadores de RL.
Sin embargo, a pesar de estos avances, muchos pasos dentro del flujo de trabajo experimental de políticas de entrenamiento a través de RL aún requieren intervención humana. Estos pasos incluyen determinar cuándo ha concluido un experimento y construir programas de tareas para facilitar el aprendizaje de las tareas objetivo. Si bien algunas investigaciones han intentado automatizar pasos individuales en este proceso, como el entrenamiento y la evaluación automatizados de tareas de aprendizaje automático estándar o la creación automatizada de programas de estudio, estos enfoques a menudo consideran cada paso de forma aislada, utilizando modelos entrenados específicamente para una sola tarea. El desafío sigue siendo desarrollar un enfoque más holístico y automatizado que pueda integrar sin problemas estos diversos pasos en el flujo de trabajo experimental de RL, reduciendo la necesidad de intervención humana en todo el proceso.
En el ámbito de la automatización de la ciencia y la ingeniería, se están desarrollando agentes potenciados por LLM para ayudar en tareas de ingeniería de software, desde la programación interactiva en pares hasta el desarrollo de software de extremo a extremo. De manera similar, en la investigación científica, se están empleando agentes basados en LLM para generar direcciones de investigación, analizar literatura, automatizar el descubrimiento científico y realizar experimentos de aprendizaje automático. Para los agentes corpóreos, particularmente en robótica, los LLM se están utilizando para escribir código de políticas, descomponer tareas de alto nivel en subtareas e incluso proponer tareas para exploración abierta. Algunos ejemplos notables incluyen el agente Voyager para Minecraft y sistemas como CaP y SayCan para tareas de robótica. Estos enfoques demuestran el potencial de los LLM para automatizar procesos complejos de razonamiento y toma de decisiones en entornos físicos. Sin embargo, la mayoría del trabajo existente se centra en la automatización de pasos individuales o dominios específicos. El desafío sigue siendo desarrollar sistemas integrados que puedan automatizar flujos de trabajo experimentales completos, particularmente en el aprendizaje de refuerzo para robótica, donde la propuesta de tareas, la descomposición, la ejecución y la evaluación deben combinarse sin problemas.
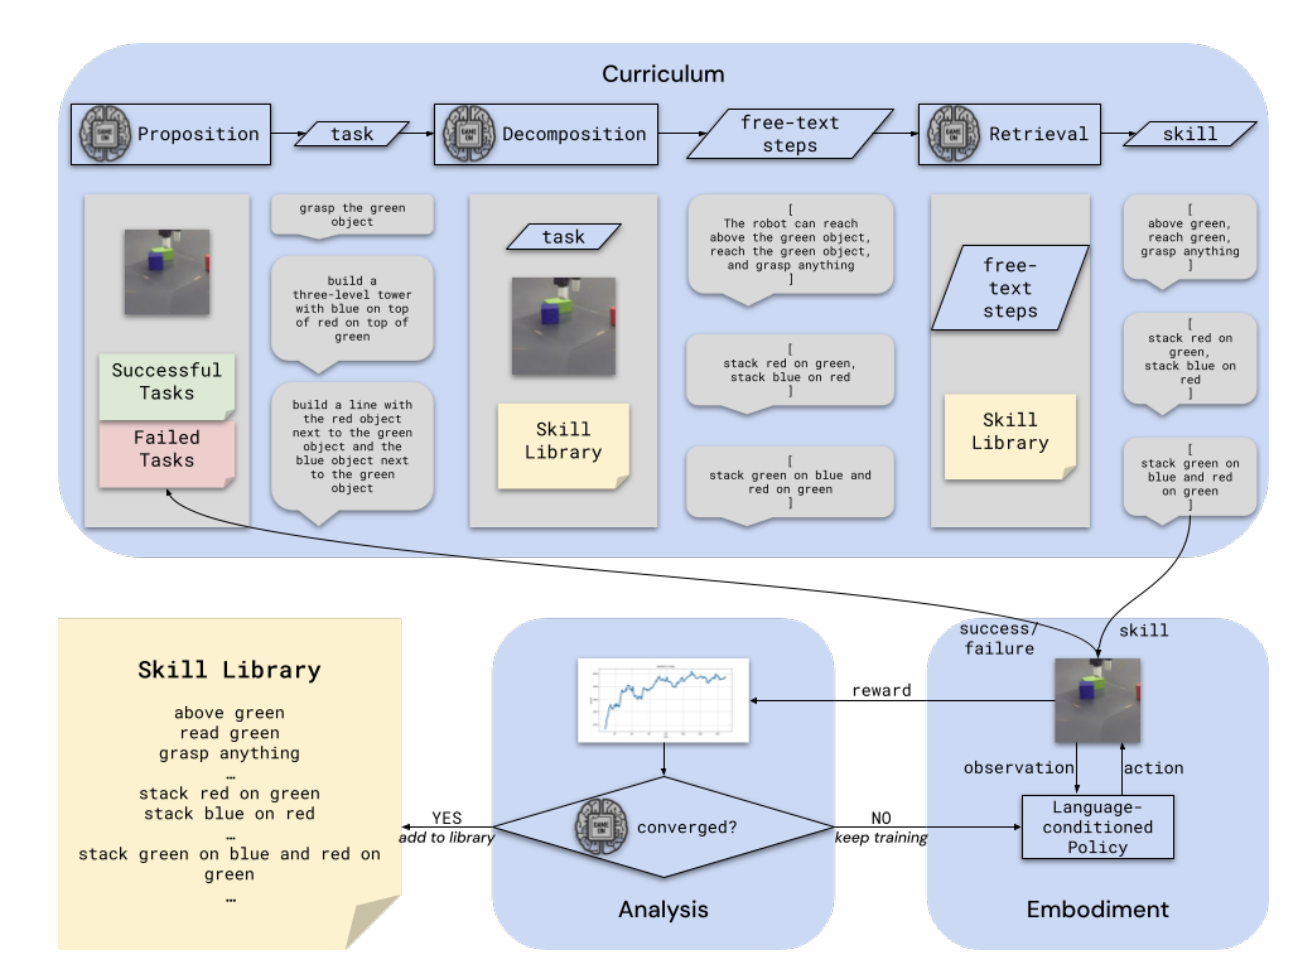
Los investigadores de DeepMind proponen una arquitectura de agente innovadora que automatiza aspectos clave del flujo de trabajo del experimento de RL, con el objetivo de permitir el dominio automatizado de los dominios de control para los agentes encarnados. Este sistema utiliza un VLM para realizar tareas que normalmente realizan los experimentadores humanos, entre ellas:
1. Seguimiento y análisis del progreso del experimento
2. Proponer nuevas tareas basadas en los éxitos y fracasos pasados del agente.
3. Descomponer tareas en secuencias de subtareas (habilidades)
4. Recuperación de habilidades apropiadas para la ejecución
Este enfoque permite que el sistema construya planes de estudio automatizados para el aprendizaje, lo que representa una de las primeras propuestas para un sistema que utiliza un VLM a lo largo de todo el ciclo de experimentos de RL.
Los investigadores han desarrollado un prototipo de este sistema, utilizando un modelo estándar de Gemini sin ajustes adicionales. Este modelo proporciona un plan de estudios de habilidades a un algoritmo Actor-Crítico condicionado por el lenguaje, guiando la recopilación de datos para ayudar en el aprendizaje de nuevas habilidades. Los datos recopilados a través de este método son eficaces para aprender y mejorar iterativamente las políticas de control en un dominio de robótica. Un examen más detallado de la capacidad del sistema para construir una biblioteca creciente de habilidades y evaluar el progreso del entrenamiento de habilidades ha arrojado resultados prometedores. Esto sugiere que la arquitectura propuesta ofrece un posible modelo para el dominio totalmente automatizado de tareas y dominios para agentes corporizados, lo que marca un paso significativo hacia sistemas de aprendizaje de refuerzo más autónomos y eficientes en robótica.
Para explorar la viabilidad del sistema propuesto, los investigadores implementaron sus componentes y los aplicaron a una tarea simulada de manipulación robótica. La arquitectura del sistema consta de varios módulos que interactúan:
1. Módulo de currículo: Este módulo recupera imágenes del entorno y las incorpora a las propuestas de objetivos. Descompone los objetivos en pasos y recupera los títulos de las habilidades. Si todos los pasos se pueden asignar a las habilidades conocidas, la secuencia de habilidades se envía al módulo de personificación.
2. Módulo de encarnación: utiliza una política aprendida condicionada por texto (algoritmo Perceptor-Actor-Crítico) para ejecutar las secuencias de habilidades. Varias instancias de este módulo pueden realizar lanzamientos de episodios simultáneamente.
3. Módulo de análisis: se utiliza fuera del ciclo experimental para evaluar los puntos de convergencia.
Los módulos interactúan a través de una interfaz basada en chat en una sesión de Google Meet, lo que permite una fácil conexión y la introspección humana. El módulo de currículo controla el flujo del programa y cambia las habilidades a intervalos fijos durante las implementaciones.
Para el entrenamiento de políticas, el sistema emplea un modelo Perceptor-Actor-Crítico (PAC), que puede entrenarse mediante aprendizaje de refuerzo fuera de línea y está condicionado por texto. Esto permite el uso de datos de exploración de no expertos y el reetiquetado de datos con múltiples funciones de recompensa. El sistema de alto nivel utiliza un modelo estándar de Gemini 1.5 Pro, con indicaciones diseñadas utilizando la biblioteca OneTwo Python. Las indicaciones incluyen una pequeña cantidad de ejemplos diseñados a mano con datos de imágenes de experimentos anteriores, que cubren tareas de propuesta, descomposición, recuperación y análisis. Esta implementación demuestra un enfoque práctico para integrar VLM en el flujo de trabajo de RL, lo que permite la propuesta, descomposición y ejecución automatizadas de tareas en un entorno robótico simulado.

Los investigadores evaluaron su enfoque utilizando una tarea de apilamiento de bloques robóticos que involucraba un robot Franka Panda de 7 grados de libertad en un simulador MuJoCo. Primero entrenaron un modelo PAC con 140 millones de parámetros sobre habilidades básicas utilizando un conjunto de datos preexistente de 1 millón de episodios. Luego, el proceso de recopilación de datos impulsado por Gemini generó 25 000 episodios nuevos, explorando diferentes temperaturas de muestreo de VLM y conjuntos de habilidades. El módulo de análisis se utilizó para determinar los puntos de parada tempranos óptimos y evaluar la convergencia de habilidades. La capacidad del módulo curricular para trabajar con un conjunto de habilidades en crecimiento se examinó en varios puntos del experimento, lo que demostró la capacidad del sistema para el aprendizaje progresivo y la descomposición de tareas.
Los investigadores han propuesto una arquitectura de agente innovadora para el aprendizaje por refuerzo que utiliza un VLM para automatizar tareas que normalmente realizan los experimentadores humanos. Este sistema tiene como objetivo permitir que los agentes corpóreos adquieran y dominen de forma autónoma un conjunto cada vez mayor de habilidades. La implementación del prototipo demostró varias capacidades clave:
- Proponiendo nuevas tareas para la exploración
- Descomponer tareas en secuencias de habilidades
- Analizando el progreso del aprendizaje
A pesar de algunas simplificaciones en el prototipo, el sistema recopiló con éxito diversos datos para la mejora de la política de control y aprendió nuevas habilidades más allá de su conjunto inicial. El plan de estudios mostró adaptabilidad al proponer tareas en función de la complejidad de las habilidades disponibles.
Echa un vistazo a la PapelTodo el crédito por esta investigación corresponde a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de Telegram y LinkedIn Gr¡Arriba!.
📨 Si te gusta nuestro trabajo, te encantará nuestro Hoja informativa..
No olvides unirte a nuestro Subreddit con más de 50 000 millones de usuarios

Asjad es consultor en prácticas en Marktechpost. Está cursando la licenciatura en ingeniería mecánica en el Instituto Indio de Tecnología de Kharagpur. Asjad es un entusiasta del aprendizaje automático y del aprendizaje profundo que siempre está investigando las aplicaciones del aprendizaje automático en el ámbito de la atención médica.