
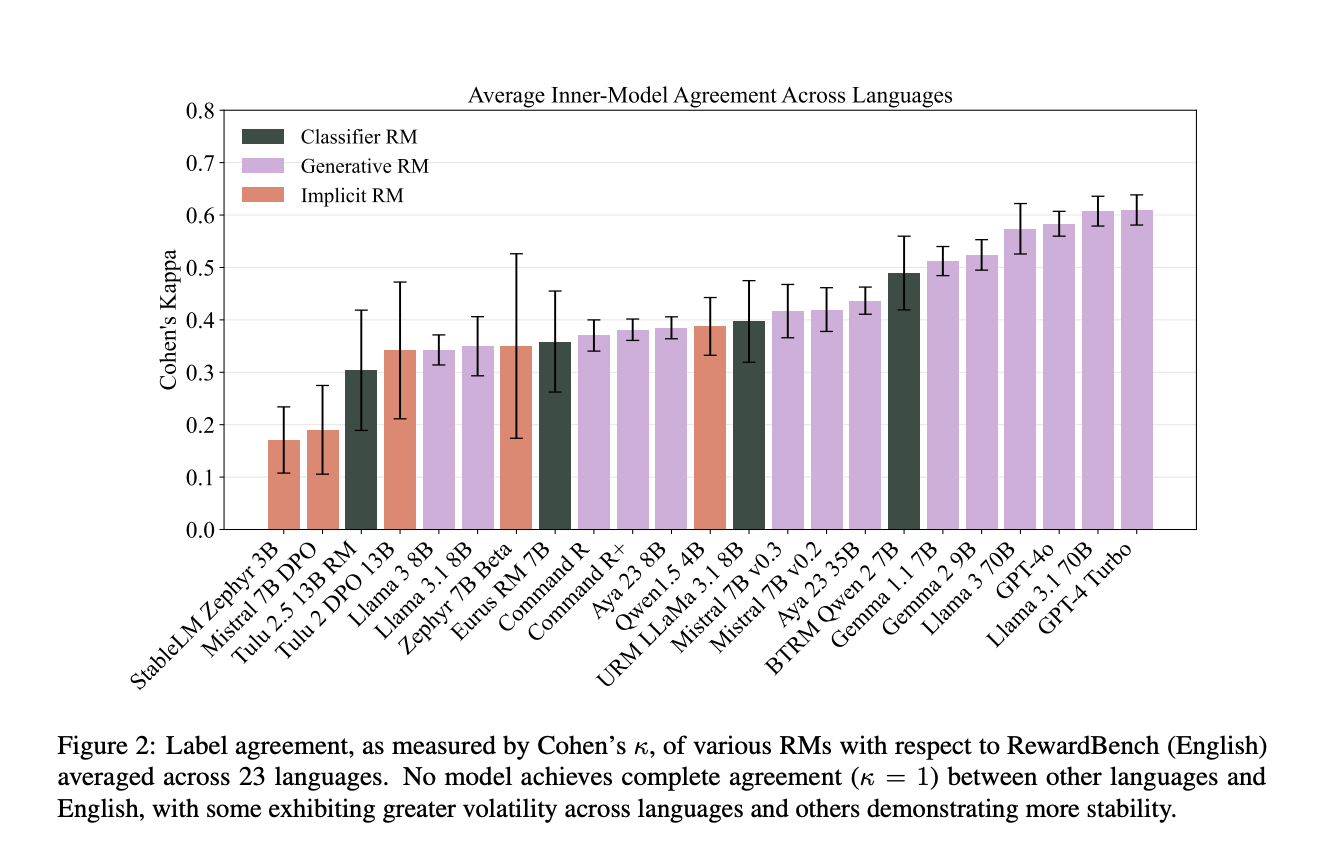
Los modelos de lenguajes grandes (LLM) han transformado campos que van desde el servicio al cliente hasta la asistencia médica al alinear la producción de las máquinas con los valores humanos. Los modelos de recompensa (RM) desempeñan un papel importante en esta alineación, ya que esencialmente sirven como un circuito de retroalimentación donde los modelos se guían para proporcionar respuestas preferidas por los humanos. Si bien muchos avances han optimizado estos modelos para el inglés, existe un desafío más amplio al adaptar los RM a contextos multilingües. Esta adaptación es esencial, dada la base global de usuarios que depende cada vez más de los LLM en diversos idiomas para diversas tareas, incluida información cotidiana, pautas de seguridad y conversaciones matizadas.
Una cuestión central en el desarrollo de LLM radica en adaptar los RM para que se desempeñen de manera consistente en diferentes idiomas. Los modelos de recompensa tradicionales, entrenados principalmente con datos en inglés, a menudo deben ponerse al día cuando se extienden a otros idiomas. Esta limitación crea una brecha de rendimiento que restringe la aplicabilidad de estos modelos, particularmente para usuarios que no hablan inglés y que dependen de modelos de idioma para obtener respuestas precisas, culturalmente relevantes y seguras. La brecha actual en las capacidades de RM subraya la necesidad de puntos de referencia y herramientas de evaluación multilingües para garantizar que los modelos sirvan a una audiencia global de manera más efectiva.
Las herramientas de evaluación existentes, como RewardBench, se centran en evaluar modelos en inglés para capacidades generales como razonamiento, funcionalidad de chat y seguridad del usuario. Si bien este punto de referencia ha establecido una base para evaluar los RM basados en el inglés, debe abordar las dimensiones multilingües necesarias para una aplicabilidad más amplia. RewardBench, tal como está, no tiene en cuenta completamente las tareas que involucran traducción o respuestas interculturales. Esto destaca un área crítica para mejorar, ya que las traducciones precisas y las respuestas culturalmente alineadas son fundamentales para una experiencia de usuario significativa en diferentes idiomas.
Investigadores de Writesonic, el Instituto Allen de IA, la Universidad de Ingeniería y Tecnología de Bangladesh, ServiceNow, Cohere For AI Community, Cohere y Cohere For AI desarrollaron el M-RewardBenchun nuevo punto de referencia de evaluación multilingüe diseñado para evaluar los RM en un espectro de 23 idiomas. El conjunto de datos, que abarca 2870 instancias de preferencia, incluye idiomas de ocho escrituras únicas y múltiples familias de idiomas, lo que proporciona un entorno de prueba multilingüe riguroso. M-RewardBench tiene como objetivo cerrar la brecha de evaluación de RM al cubrir idiomas de diversos orígenes tipológicos, brindando nuevos conocimientos sobre cómo se desempeñan los LLM en idiomas distintos del inglés en áreas esenciales como seguridad, razonamiento, capacidad de chat y traducción.
La metodología M-RewardBench evalúa exhaustivamente los modelos de recompensa multilingües, empleando traducciones generadas por máquinas y verificadas por humanos para garantizar su precisión. Los investigadores crearon subconjuntos basados en la dificultad de la tarea y la complejidad del idioma, traduciendo y adaptando las indicaciones de RewardBench en 23 idiomas. El punto de referencia incluye las categorías Chat, Chat-Hard, Seguridad y Razonamiento para evaluar las capacidades de RM en entornos conversacionales cotidianos y complejos. Para medir el impacto de la calidad de la traducción, el equipo de investigación utilizó dos sistemas de traducción, Google Translate y NLLB 3.3B, lo que demuestra que una traducción mejorada puede mejorar significativamente el rendimiento de RM hasta en un 3 %.
El estudio reveló disparidades sustanciales en el desempeño, particularmente entre contextos ingleses y no ingleses. Los modelos de recompensa generativa, como GPT-4-Turbo, funcionaron relativamente bien, logrando una puntuación de precisión del 83,5%, mientras que otros tipos de RM, como los modelos basados en clasificadores, tuvieron problemas con el cambio a tareas multilingües. Los resultados indican que los modelos generativos son más adecuados para la alineación multilingüe, aunque persiste una caída promedio del rendimiento del 8 % al pasar de tareas en inglés a tareas que no están en inglés. Además, el rendimiento de los modelos varió significativamente según el idioma: los idiomas con mayores recursos, como el portugués, lograron una mayor precisión (68,7%) en comparación con los idiomas con menores recursos, como el árabe (62,8%).
De M-RewardBench surgieron varias ideas clave que subrayan áreas de mejora en el desarrollo de RM multilingüe. Por ejemplo, los RM mostraron un mayor grado de coherencia de etiquetas en todos los idiomas para tareas de razonamiento que para conversaciones de chat generales, lo que sugiere que ciertos tipos de contenido pueden ser más adaptables a contextos multilingües. Esta idea apunta a la necesidad de puntos de referencia especializados dentro de M-RewardBench para evaluar diferentes tipos de contenido, especialmente a medida que los modelos se expanden a idiomas subrepresentados con estructuras gramaticales únicas.

Conclusiones clave de la investigación:
- Alcance del conjunto de datos: M-RewardBench abarca 23 idiomas, ocho familias de idiomas y 2870 instancias de preferencia, lo que la convierte en una de las herramientas de evaluación de RM multilingües más completas disponibles.
- Brechas de desempeño: Los RM generativos lograron puntuaciones promedio más altas, con un significativo 83,5 % en entornos multilingües, pero el rendimiento general cayó hasta un 13 % en tareas que no estaban en inglés.
- Variaciones específicas de tareas: Las tareas de Chat-Hard mostraron la mayor degradación del rendimiento (5,96%), mientras que las tareas de razonamiento tuvieron la menor, lo que destaca que la complejidad de las tareas afecta la precisión de RM en todos los idiomas.
- Impacto en la calidad de la traducción: Las traducciones de mayor calidad mejoraron la precisión de RM hasta en un 3 %, lo que enfatiza la necesidad de métodos de traducción refinados en contextos multilingües.
- Coherencia en idiomas de altos recursos: Los modelos obtuvieron mejores resultados en idiomas de altos recursos (por ejemplo, portugués, 68,7%) y mostraron problemas de coherencia en idiomas de bajos recursos, como el árabe (62,8%).
- Contribución de referencia: M-RewardBench proporciona un nuevo marco para evaluar los LLM en idiomas distintos del inglés, sentando las bases para futuras mejoras en la alineación de RM en contextos culturales y lingüísticos.

En conclusión, la investigación detrás de M-RewardBench ilustra una necesidad crítica de que los modelos lingüísticos se alineen más estrechamente con las preferencias humanas en todos los idiomas. Al proporcionar un punto de referencia adaptado a contextos multilingües, esta investigación sienta las bases para futuras mejoras en el modelado de recompensas, especialmente en el manejo de matices culturales y garantizar la coherencia del lenguaje. Los hallazgos refuerzan la importancia de desarrollar RM que sirvan de manera confiable a una base de usuarios global, donde la diversidad lingüística y la calidad de la traducción son fundamentales para el rendimiento.
Mira el Papel, Proyectoy GitHub. Todo el crédito por esta investigación va a los investigadores de este proyecto. Además, no olvides seguirnos en Gorjeo y únete a nuestro Canal de telegramas y LinkedIn Grarriba. Si te gusta nuestro trabajo, te encantará nuestro hoja informativa.. No olvides unirte a nuestro SubReddit de más de 55.000 ml.
[Upcoming Live Webinar- Oct 29, 2024] La mejor plataforma para ofrecer modelos optimizados: motor de inferencia Predibase (promocionado)
Asif Razzaq es el director ejecutivo de Marktechpost Media Inc.. Como emprendedor e ingeniero visionario, Asif está comprometido a aprovechar el potencial de la inteligencia artificial para el bien social. Su esfuerzo más reciente es el lanzamiento de una plataforma de medios de inteligencia artificial, Marktechpost, que se destaca por su cobertura en profundidad del aprendizaje automático y las noticias sobre aprendizaje profundo que es técnicamente sólida y fácilmente comprensible para una amplia audiencia. La plataforma cuenta con más de 2 millones de visitas mensuales, lo que ilustra su popularidad entre el público.