

TL;DR — Logramos la misma funcionalidad que el recuperador de documentos principales de LangChains (enlace) mediante el uso de consultas de metadatos. Puedes explorar el código. aquí.
La generación de recuperación aumentada (RAG) es actualmente uno de los temas más candentes en el mundo de las aplicaciones LLM y de IA.
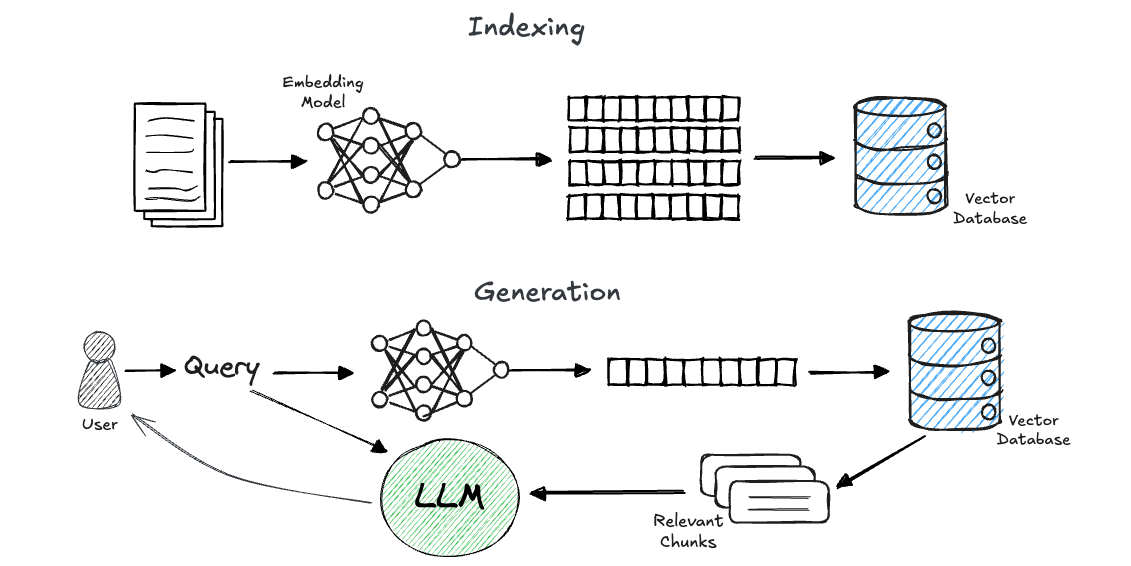
En resumen, RAG es una técnica para fundamentar la respuesta de un modelo generativo en fuentes de conocimiento elegidas. Consta de dos fases: recuperación y generación.
- En la fase de recuperación, dada la consulta de un usuario, recuperamos información relevante de una fuente de conocimiento predefinida.
- Luego, insertamos la información recuperada en el mensaje que se envía a un LLM, que (idealmente) genera una respuesta a la pregunta del usuario según el contexto proporcionado.
Un enfoque comúnmente utilizado para lograr una recuperación eficiente y precisa es mediante el uso de incrustaciones. En este enfoque, preprocesamos los datos de los usuarios (supongamos texto sin formato para simplificar) dividiendo los documentos en partes (como páginas, párrafos u oraciones). Luego utilizamos un modelo de incrustación para crear una representación numérica significativa de estos fragmentos y los almacenamos en una base de datos vectorial. Ahora, cuando llega una consulta, la incorporamos también y realizamos una búsqueda de similitud utilizando la base de datos vectorial para recuperar la información relevante.
Si eres completamente nuevo en este concepto, te recomiendo aprendizaje profundo.ai gran curso, LangChain: chatea con tus datos.
La “Recuperación de documentos principales” o la “Recuperación de ventana de oración”, como la denominan otros, es un enfoque común para mejorar el rendimiento de los métodos de recuperación en RAG al proporcionar al LLM un contexto más amplio para considerar.
En esencia, dividimos los documentos originales en fragmentos relativamente pequeños, incrustamos cada uno y los almacenamos en una base de datos vectorial. El uso de fragmentos tan pequeños (una oración o un par de oraciones) ayuda a los modelos de incrustación a reflejar mejor su significado. [1].
Entonces, en el momento de la recuperación, no devolvemos el fragmento más similar encontrado únicamente en la base de datos de vectores, sino también su contexto circundante. (trozos) en el documento original. De esa manera, el LLM tendrá un contexto más amplio, lo que, en muchos casos, ayuda a generar mejores respuestas.
LangChain apoya este concepto a través de Parent Document Retriever [2]. El recuperador de documentos principales le permite: (1) recuperar el documento completo del que se originó un fragmento específico, o (2) predefinir un fragmento “principal” más grande, para cada fragmento más pequeño asociado con ese padre.
Exploremos el ejemplo de Documentos de LangChains:
# This text splitter is used to create the parent documents
parent_splitter = RecursiveCharacterTextSplitter(chunk_size=2000)
# This text splitter is used to create the child documents
# It should create documents smaller than the parent
child_splitter = RecursiveCharacterTextSplitter(chunk_size=400)
# The vectorstore to use to index the child chunks
vectorstore = Chroma(
collection_name="split_parents", embedding_function=OpenAIEmbeddings()
)
# The storage layer for the parent documents
store = InMemoryStore()
retriever = ParentDocumentRetriever(
vectorstore=vectorstore,
docstore=store,
child_splitter=child_splitter,
parent_splitter=parent_splitter,
)
retrieved_docs = retriever.invoke("justice breyer")
En mi opinión, el enfoque de LangChains tiene dos desventajas:
- La necesidad de gestionar el almacenamiento externo para beneficiarse de este útil enfoque, ya sea en la memoria u otro almacén persistente. Por supuesto, para casos de uso reales, el InMemoryStore utilizado en los distintos ejemplos no será suficiente.
- La recuperación “principal” no es dinámica, lo que significa que no podemos cambiar el tamaño de la ventana circundante sobre la marcha.
De hecho, se han planteado algunas preguntas sobre este tema. [3].
Aquí también mencionaré que Llama-index tiene su propio SentenciaVentanaNodoParser [4]que generalmente tiene las mismas desventajas.
A continuación, presentaré otro enfoque para lograr esta útil característica que aborda las dos desventajas mencionadas anteriormente. En este enfoque, solo usaremos el almacén de vectores que ya está en uso.
Implementación alternativa
Para ser precisos, usaremos un almacén de vectores que admite la opción de realizar consultas de metadatos únicamente, sin ninguna búsqueda de similitud involucrada. Aquí, presentaré una implementación para cromadb y milvus. Este concepto se puede adaptar fácilmente a cualquier base de datos vectorial con tales capacidades. me referiré a Piña por ejemplo al final de este tutorial.
El concepto general
El concepto es sencillo:
- Construcción: Junto a cada fragmento, guarde en sus metadatos el id_documento fue generado a partir de y también el número_secuencia del trozo.
- Recuperación: Después de realizar la búsqueda de similitud habitual (asumiendo por simplicidad sólo el primer resultado), obtenemos el id_documento y el número_secuencia del fragmento a partir de los metadatos del fragmento recuperado. Recuperar todos los fragmentos con números de secuencia circundantes que tengan el mismo id_documento.
Por ejemplo, suponiendo que haya indexado un documento llamado ejemplo.pdf en 80 trozos. Luego, por alguna consulta, encuentras que el vector más cercano es el que tiene los siguientes metadatos:
{document_id: "example.pdf", sequence_number: 20}
Puede obtener fácilmente todos los vectores del mismo documento con números de secuencia del 15 al 25.
Veamos el código.
Aquí estoy usando:
chromadb==0.4.24
langchain==0.2.8
pymilvus==2.4.4
langchain-community==0.2.7
langchain-milvus==0.1.2
Lo único interesante a destacar a continuación son los metadatos asociados a cada fragmento, que nos permitirán realizar la búsqueda.
from langchain_community.document_loaders import PyPDFLoader
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitterdocument_id = "example.pdf"
def preprocess_file(file_path: str) -> list[Document]:
"""Load pdf file, chunk and build appropriate metadata"""
loader = PyPDFLoader(file_path=file_path)
pdf_docs = loader.load()
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=1000,
chunk_overlap=0,
)
docs = text_splitter.split_documents(documents=pdf_docs)
chunks_metadata = [
{"document_id": file_path, "sequence_number": i} for i, _ in enumerate(docs)
]
for chunk, metadata in zip(docs, chunks_metadata):
chunk.metadata = metadata
return docs
Ahora, implementemos la recuperación real en Milvus y Chroma. Tenga en cuenta que usaré los objetos de LangChains y no los clientes nativos. Hago esto porque asumo que los desarrolladores querrán mantener la útil abstracción de LangChains. Por otro lado, será necesario que realicemos algunos trucos menores para evitar estas abstracciones de una manera específica de la base de datos, por lo que debes tenerlo en cuenta. De todos modos, el concepto sigue siendo el mismo.
Nuevamente, supongamos por simplicidad que queremos sólo el vector más similar (“top 1”). A continuación, extraeremos el document_id asociado y su número de secuencia. Esto nos permitirá recuperar la ventana circundante.
from langchain_community.vectorstores import Milvus, Chroma
from langchain_community.embeddings import DeterministicFakeEmbeddingembedding = DeterministicFakeEmbedding(size=384) # Just for the demo :)
def parent_document_retrieval(
query: str, client: Milvus | Chroma, window_size: int = 4
):
top_1 = client.similarity_search(query=query, k=1)[0]
doc_id = top_1.metadata["document_id"]
seq_num = top_1.metadata["sequence_number"]
ids_window = [seq_num + i for i in range(-window_size, window_size, 1)]
# ...
Ahora, para la recuperación de ventana/padre, profundizaremos en la abstracción Langchain, de una manera específica de la base de datos.
Para Milvus:
  if isinstance(client, Milvus):
expr = f"document_id LIKE '{doc_id}' && sequence_number in {ids_window}"
res = client.col.query(
expr=expr, output_fields=["sequence_number", "text"], limit=len(ids_window)
)  # This is Milvus specific
docs_to_return = [
Document(
page_content=d["text"],
metadata={
"sequence_number": d["sequence_number"],
"document_id": doc_id,
},
)
for d in res
]
# ...
Para croma:
    elif isinstance(client, Chroma):
expr = {
"$and": [
{"document_id": {"$eq": doc_id}},
{"sequence_number": {"$gte": ids_window[0]}},
{"sequence_number": {"$lte": ids_window[-1]}},
]
}
res = client.get(where=expr)  # This is Chroma specific
texts, metadatas = res["documents"], res["metadatas"]
docs_to_return = [
Document(
page_content=t,
metadata={
"sequence_number": m["sequence_number"],
"document_id": doc_id,
},
)
for t, m in zip(texts, metadatas)
]
y no olvides ordenarlo por el número de secuencia:
    docs_to_return.sort(key=lambda x: x.metadata["sequence_number"])
return docs_to_return
Para su comodidad, puede explorar el código completo. aquí.
Piña (y otras)
Hasta donde yo sé, no existe una forma nativa de realizar dicha consulta de metadatos en Pinecone, pero puedes recuperar vectores de forma nativa por su ID (https://docs.pinecone.io/guides/data/fetch-data).
Por lo tanto, podemos hacer lo siguiente: cada fragmento obtendrá una ID única, que es esencialmente una concatenación de document_id y el número de secuencia. Luego, dado un vector recuperado en la búsqueda de similitud, puede crear dinámicamente una lista de los ID de los fragmentos circundantes y lograr el mismo resultado.
Vale la pena mencionar que las bases de datos vectoriales no fueron diseñadas para realizar operaciones de bases de datos “regulares” y generalmente no están optimizadas para eso, y cada base de datos funcionará de manera diferente. Milvus, por ejemplo, admitirá la creación de índices sobre campos escalares (“metadatos”) que pueden optimizar este tipo de consultas.
Además, tenga en cuenta que requiere una consulta adicional a la base de datos de vectores. Primero recuperamos el vector más similar y luego realizamos consultas adicionales para obtener los fragmentos circundantes en el documento original.
Y, por supuesto, como se ve en los ejemplos de código anteriores, la implementación es específica de la base de datos vectorial y no es compatible de forma nativa con la abstracción de LangChains.
En este blog presentamos una implementación para lograr la recuperación de ventana de oraciones, que es una técnica de recuperación útil utilizada en muchas aplicaciones RAG. En esta implementación hemos usado solo la base de datos vectorial que ya está en uso de todos modos, y también admitimos la opción de modificar dinámicamente el tamaño de la ventana circundante recuperada.
[1] ARAGOG: Clasificación avanzada de salida RAG, https://arxiv.org/pdf/2404.01037sección 4.2.2
[2] https://python.langchain.com/v0.1/docs/modules/data_connection/retrievers/parent_document_retriever/
[3] Algunas cuestiones relacionadas:
– https://github.com/langchain-ai/langchain/issues/14267
– https://github.com/langchain-ai/langchain/issues/20315
– https://stackoverflow.com/questions/77385587/persist-parentdocumentretriever-of-langchain
[4] https://docs.llamaindex.ai/en/stable/api_reference/node_parsers/sentence_window/